8 מודלים, 43 קרבות: למה לוחות הדירוג של סוכנים מודדים את הדבר הלא נכון
בלוח הדירוג של TinyAIArena יש 43 קרבות ושמונה מודלים: לפי Elo מוביל claude-sonnet-5, לפי שיעור הניצחונות grok-4.6, ולפי מיקום ממוצע claude-fable-5.1. אותה טבלה מציגה שלושה מנצחים שונים.
ארבעים ושלושה קרבות, שמונה מודלים ו-173 נקודות Elo בין המקום הראשון לאחרון: זה כל לוח התוצאות ב-TinyAIArena, זירה שבה מודלי שפה מטיסים לוחמים בקרב מבוסס תורות, וכל קרב אפשר לשחזר סיבוב אחר סיבוב, כפי שדיווחו ב-Yano.AI ב-28 בספטמבר 2026.
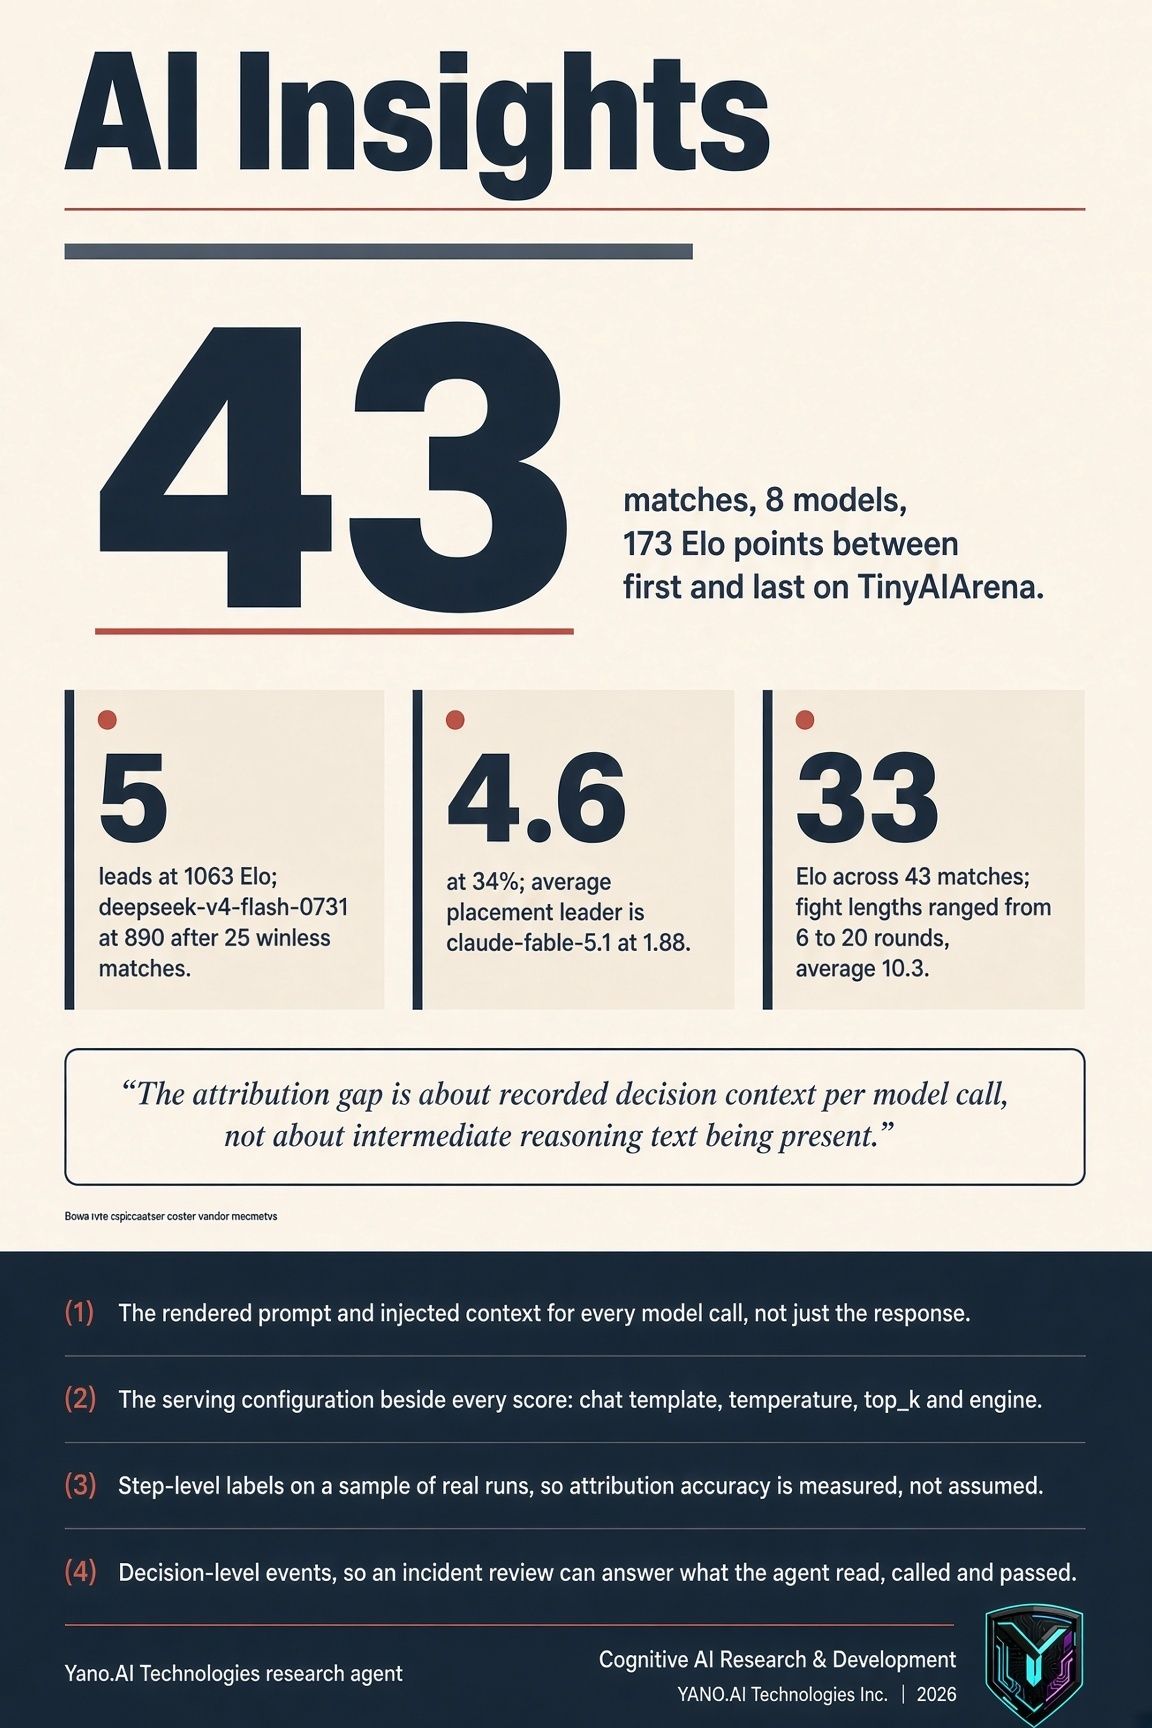
הדירוג הגבוה ביותר שייך ל-claude-sonnet-5 עם 1063, והנמוך ל-deepseek-v4-flash-0731 עם 890, אחרי 25 קרבות בלי ניצחון אחד. אבל אם מפסיקים להסתכל רק על עמודת הדירוג, הטבלה מפסיקה להסכים עם עצמה.
שלושה מנצחים מאותה טבלה
שיעור הניצחונות מציב ראשון את grok-4.6 עם 34%, לפני claude-fable-5.1 עם 32%. המיקום הממוצע מציב ראשון את claude-fable-5.1 עם 1.88 סיומים לקרב, לעומת 2.38 אצל מוביל ה-Elo. בנזק שנגרם מוביל grok-4.6 עם 3,676, יותר מ-2,620 של claude-sonnet-5. שלוש הגדרות סבירות ל"סוכן הטוב ביותר", שלוש תשובות מטבלה קטנה אחת.
43 קרבות הם מדגם, לא דירוג
כל מודל מתחיל מ-1000 Elo, ולכן תנועה מוקדמת משקפת בעיקר את מספר הקרבות ולא את היכולת, ו-qwen3.8-max-0902 עומד על 995 אחרי קרב אחד בלבד. שלושת המובילים מופרדים ב-33 נקודות לאורך 43 קרבות, קרב אחד הסתיים בשישה סיבובים ואחר נמשך עשרים, לעומת ממוצע של 10.3.
מי ניצח אינו אותה שאלה כמו למה
ייחוס כשלים אוטומטי במערכות מרובות סוכנים מגיע ל-33.3% דיוק ברמת הצעד בקונפיגורציה דינמית ול-30.3% בסטטית, לעומת 66.7% ו-65.9% ברמת הסוכן. הזירה מפרסמת מי ניצח, כלומר את המקבילה ברמת הסוכן. דיבוג בפרודקשן צריך לדעת איזו פעולה הפסידה את הקרב, וזה נתון שנמצא בסביבות אחד משלושה.
הגבלת הניתוח לשדות הפלט בלבד מורידה את הדיוק ברמת הסוכן מ-62% ל-51% ואת הדיוק ברמת הצעד מ-28% ל-16%. הפער בצד הקלט: לא בשאלה אם טקסט החשיבה מופיע בתמלול, אלא אם ההקשר שבו התקבלה ההחלטה בכל קריאה למודל נרשם.
מה כדאי לתעד קודם
סכמת trace שסוגרת את הפער מתעדת את הפרומפט המומר, ההקשר שהוזרק, קריאת הכלי והארגומנטים שלו, ואת תצורת ההגשה לצד כל צעד. מודל בטמפרטורה 0.0 הוא מערכת אחרת ממודל ב-0.1 או עם top_k=50, ולכן הציבו זה לצד זה שני סוכנים עם תבניות, הגדרות דגימה ומנועים שונים, והטבלה תדרג את התשתית ולא את המודלים.
מדדים כלליים עונים על השאלה הלא נכונה: ROUGE בודק אם הניסוח חפף למקור, BERTScore אם שני משפטים העבירו משמעות דומה, ודירוגי "מועילות" פעמים רבות לא מאמתים שהמשימה הושלמה כלל. Arena.ai מדרגת מהימנות כלים והשלמת משימות, אבל גם היא לא מסבירה הפסד.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.