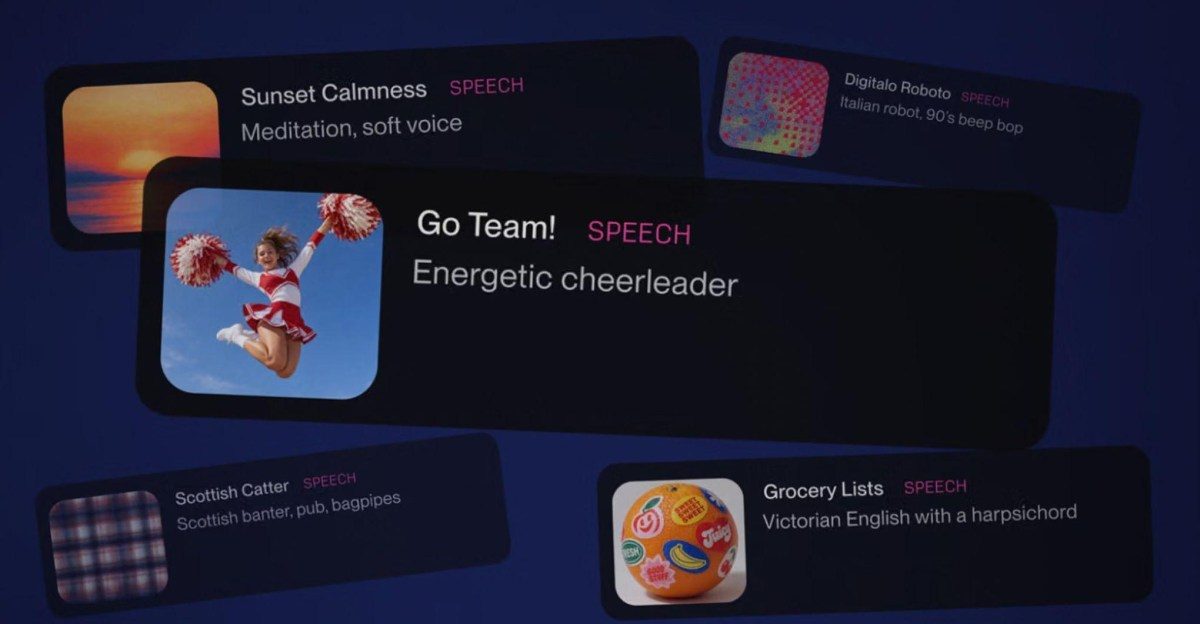
Suno הציגה פיצ'ר חדש בשם Speech שמאחד קול ומוזיקה בטראק אחד
Suno השיקה את הפיצ'ר החדש Speech, שיוצר דיבור לפי תסריט או תיאור טקסטואלי ומאחד את הקול עם מוזיקת רקע בטראק אודיו אחד. הפיצ'ר זמין בגרסת בטא ציבורית.
Suno, פלטפורמת המוזיקה מבוססת ה-AI, הציגה את הפיצ'ר החדש Speech, שיוצר דיבור לפי תסריט או תיאור טקסטואלי. הפיצ'ר זמין במצב בטא ציבורי באתר החברה ובאפליקציות המובייל, ויוצר גם מוזיקת רקע לצד הקול.
קול ומוזיקה בטראק אחד
Suno מתארת את הפיצ'ר החדש כך: „זהו מודל האודיו הראשון שמאחד קול ומוזיקה לטראק שלם אחד". ג'ק ברודי, מנהל המוצר של החברה, הצהיר שהמוזיקה תמיד תישאר בלב Suno ובכל מה שהחברה יוצרת, אך החזון שלה כולל גם צורות אחרות של ביטוי אנושי.
מוזיקת הרקע אינה חובה: ניתן לכבות אותה במתג ולקבל רק דיבור נקי. לפי ההסבר של Suno, המוזיקה מתאימה למקרים ספציפיים, למשל רקע שקט לשירים או ליווי אנרגטי יותר לדיאלוגים דרמטיים ומונולוגים.
איך עובד Speech
כדי להשתמש בפיצ'ר, פתחו את תפריט Create ובחרו את הפרמטר Speech. ישנם שני מצבים: פשוט, שיוצר קול לפי התיאור שהוזן (למשל, „קפטן הפיראטים קורא לצוות"), ומורחב, שמשתמש בתסריט מוכן אם אתם יודעים בדיוק מה אמור להיאמר. בהגדרות המורחבות ניתן להגדיר את מין הקול, סגנון הדיבור ואת הגיוון של כל יצירה. יצירה אחת אורכת לכל היותר כ-8 דקות.
שוק תחרותי ומגבלות הבטא
דיבור מבוסס AI אינו חדש: DeepMind של Google חוקר סינתזת דיבור מבוססת למידה עמוקה כבר עשור, ל-Adobe יש כלי להמרת טקסט לדיבור, ו-ElevenLabs היא אחת הפלטפורמות המוכרות ביותר בתחום זה מאז 2023. צעד זה מעיד על כך ש-Suno מחפשת כיוונים חדשים מעבר ליצירת מוזיקה: למחולל המוזיקה של החברה היו הרבה תביעות משפטיות.
החברה מודה שהפיצ'ר עדיין אינו מושלם. „בטא זה באמת בטא", אמר ברודי והוסיף שלפעמים מבטא בריטי עשוי להשתנות לאוסטרלי ולחזור, ושהפסקות דרמטיות עשויות להיות דרמטיות מדי. לדבריו, המשתמשים כמעט בהכרח ימצאו שימושים לפיצ'ר שהחברה לא חשבה עליהם. Suno מצהירה כי תשפר את Speech לפי משוב המשתמשים.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.