AMD: MEXT יכול לשמר 95% מביצועי השרת עם חצי מה-DRAM
AMD אומרת ש-MEXT יכול להפחית שימוש ב-DRAM של שרתים ב-20% עד 75% תוך שמירה על חלק ניכר מהביצועים, באמצעות פלאש ובינה מלאכותית להעברת דפי זיכרון קרים. החברה פרסה אותו על 145 שרתים ומתכננת להגיע ל-2,000 שרתים בשנה הבאה.
AMD הציגה כיצד MEXT, מנוע חיזוי לזיכרון, יכול לצמצם את ה-DRAM הפיזי הנדרש בשרתים תוך שמירה על רוב הביצועים. לפי MEXT, המערכת מספקת יותר מ-99% מהביצועים של מערכת עם DRAM מלא גם כשהיא פועלת עם 25% בלבד ממודולי ה-DIMM הפיזיים. הטכנולוגיה מעבירה דפי זיכרון קרים לאחסון פלאש, ומודל בינה מלאכותית מחזיר אותם לפני שנדרשים.
איך MEXT מעביר זיכרון לפלאש
MEXT מפנה דפי זיכרון קרים לאחסון פלאש, אך הזיכרון החסר עדיין נרשם במערכת ההפעלה כ-DRAM מותקן. מכיוון שפלאש איטי יותר מ-DRAM, MEXT משתמש במודל בינה מלאכותית כדי לחזות אילו דפים יידרשו ולהחזיר אותם לפני שהם נחוצים. AMD אומרת שהמודל מתאמן בפחות משנייה כשהוא מופעל לראשונה, פועל על ליבת EPYC אחת בלי GPU, וממשיך להתאמן תוך כדי העבודה. MEXT נפרס כמודול קרנל של Linux שעובד עם כל הפצת Linux, ומשתמש במכלול מודלי בינה מלאכותית שבראשו מודל שפה גדול מבוסס טרנספורמר.
טענות הביצועים הפנימיות של AMD
בעומסי עבודה פנימיים מסוימים, כמו Synopsys PrimeTime, AMD אומרת ששרתים הפועלים ב-50% מקיבולת ה-DRAM שומרים על 95% מהביצועים של שרת מלא, בעוד קיבולת של 25% שומרת על 80% מהביצועים. באשכול Azure בן שלושה צמתים עם מעבדי EPYC מהדור החמישי, AMD אומרת ש-MEXT סיפק 99% מביצועי האשכול המלא ב-50% מקיבולת ה-DRAM בעומס Spark SQL מבנצ'מרק TPC-DS. בבינה מלאכותית סוכנית AMD טוענת ל-99% מביצועי שרת מלא ב-50% מקיבולת הזיכרון ול-85% ב-25%, לפי ממוצע גיאומטרי של חמישה סוכנים שרצו במקביל. עבור סוכן עתיר זיכרון AMD טוענת ל-90% ביצועים ב-50% מקיבולת ול-88% ב-25%.
פריסה והרחבה
AMD פרסה את MEXT פנימית על 145 שרתים ואומרת שתרחיב ל-2,000 שרתים בשנה הבאה. היא גם הודיעה על שיתוף פעולה עם HPE כדי להביא את MEXT ללקוחות. שלב 1 כולל כמה שרתי EPYC Venice עם תג MEXT Ready וכונן NVMe ייעודי או תא להעברה. שלב 2 יביא לשרתים האלה רישיונות MEXT ואת אפליקציית RAM View, אך AMD לא אמרה מתי יתחיל שלב 2.
עומסי עבודה ומגבלות
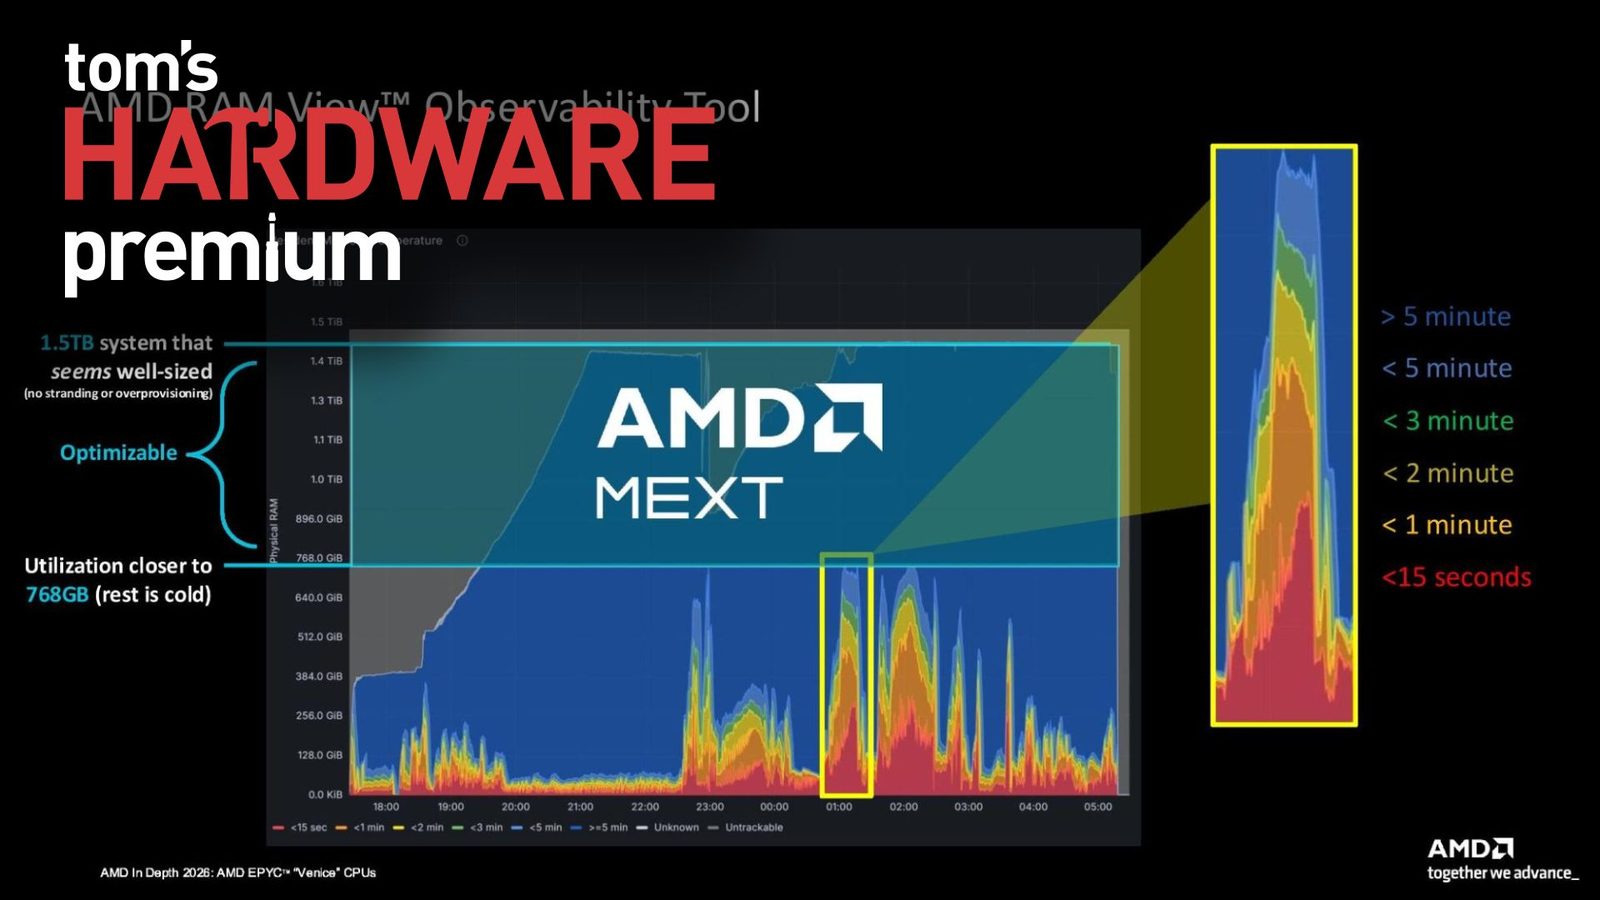
AMD מיישמת את MEXT תחילה ביישומי EDA קריטיים שהיא משתמשת בהם באופן פנימי, ובהם Synopsys PrimeTime, ובמקביל מייעלת עומסי בינה מלאכותית סוכנית, מסדי נתונים ומדיה ובידור. החברה אומרת שעומסים רבים יכולים להפחית קיבולת בכ-20% עד 25%, ואילו הפחתות גדולות יותר הופכות את היישומים למתמחים יותר ומלוות בפערי ביצועים גדולים יותר. AMD אומרת ש-RAM View מציג אילו דפים חמים ואילו קרים; בדוגמה כללית אחת, מערכת עם 1.5 TB זיכרון הראתה ניצול כמעט מלא, וכמחצית מהדפים לא נגעו בהם חמש דקות או יותר בכל רגע נתון. AMD לא הבהירה מהו עומס העבודה בדוגמה הזו, ולא שיתפה את הערות השוליים של כמה מהשקפים.
מקורות: Tom's Hardware · The Register
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.