Cerebras מסבירה כיצד היא פורסת מודלי AI של טריליון פרמטרים על שבבים בקנה מידה של פרוסות
Cerebras מתארת כיצד היא מפצלת מודלים גדולים מסוג frontier על פני פרוסות WSE-3T, ובאמצעות מודל Kimi K3 מסבירה כיצד פועלים הזיכרון על-השבב, צינור העיבוד והטיפול בבקשות בו-זמנית.
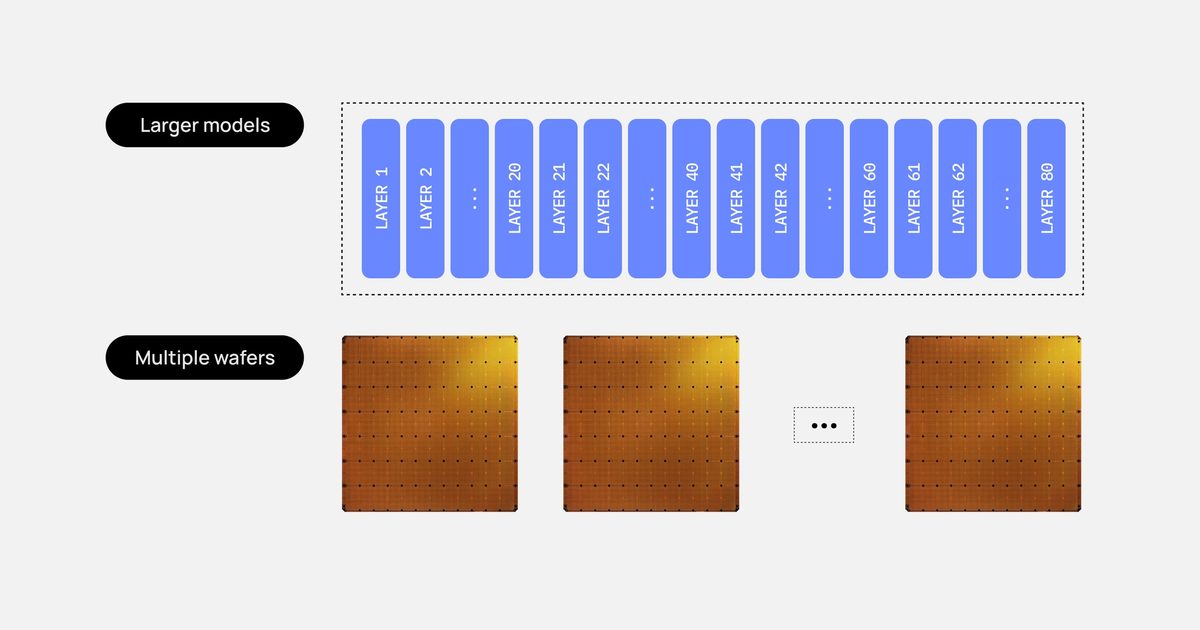
Cerebras פרסמה הסבר על האופן שבו היא פורסת מודלי חזית של טריליון פרמטרים על שבבי הפרוסה שלה. לפרוסת WSE-3T בודדת של Cerebras יש 44 GB של זיכרון על-השבב, בעוד מודלים של טריליון פרמטרים זקוקים לטרה-בייטים עבור המשקולות בלבד. החברה אומרת שהיא מפצלת מודל גדול על פני מספר פרוסות WSE-3T כדי להריץ מודלים מרובי-טריליון פרמטרים בקצב של 1000-2000+ אסימונים לשנייה.
Kimi K3 כדוגמה
Cerebras משתמשת במודל Kimi K3 בקוד פתוח כדוגמה להמחשה. ל-Kimi K3 יש כ-3 טריליון פרמטרים, עם 69 שכבות קשב ליניאריות ו-24 שכבות צפופות. Cerebras אומרת ש-Kimi K3 משיגה 88.3% ב-Terminal-Bench 2.1 לעומת 88.8% עבור GPT-5.6 Sol, ו-91.2% ב-BrowseComp לעומת 90.4% עבור GPT-5.6 Sol. Cerebras אומרת שתוצאות אלו מראות יכולות תכנות וסוכנות ברמת חזית, כאשר המודל עולה על מודלים קנייניים מובילים בכמה מדדים.
לצורך הדוגמה, Cerebras מניחה גודל בקשה ממוצע של 256k, קוונטיזציה של משקולות 4-bit ומטמון KV של 8-bit. היא מחשבת את גודל כל שכבה במודל, ולאחר מכן מחלקת את המודל על פני 93 שכבות. התוצאה היא כ-16 GB לשכבה.
מיפוי שכבות לפרוסות
הקיבולת של 44 GB בכל פרוסת WSE-3T קובעת כמה שכבות מתאימות לפרוסה, והתשובה תלויה בסוג השכבה. שכבות צפופות זקוקות למקום נוסף עבור מטמון KV מכיוון שכל שכבת קשב מלא צפופה מאחסנת מפתחות וערכים עבור כל אסימון בכל בקשה פעילה. לכן Cerebras ממקמת שכבה צפופה אחת בכל פרוסה ומשאירה את ה-SRAM הנותר למטמון ה-KV שלה.
שכבות קשב ליניאריות אינן זקוקות למקום נוסף עבור מטמון KV. במקום לאחסן מפתחות וערכים עבור כל אסימון, שכבת קשב ליניארית שומרת מצב קטן בגודל קבוע לכל בקשה ללא תלות באורך ההקשר. הדבר משאיר מקום לשתי שכבות ליניאריות בכל פרוסה, כלומר 2 x 16 GB = 32 GB. עם 69 שכבות ליניאריות ו-24 שכבות צפופות, המיפוי מניב 35 פרוסות עבור שכבות ליניאריות ועוד 24 פרוסות עבור שכבות צפופות, בסך הכל 59 פרוסות.
ביצוע צינור ומקביליות
Cerebras מבצעת מודלים בצינור. המהדר ממפה את שכבות המודל על פני אזורים של פרוסות, והסביבה בזמן ריצה ממפה את הנתיב עבור אסימונים לזרום בין פרוסות. רק הפעלות צריכות לעבור בין פרוסות, וניתן לעשות זאת באמצעות RDMA מעל Ethernet בכ-2 מיקרו-שניות לקפיצה. מכיוון שלכל פרוסה יש 44 GB של SRAM על-השבב וכל שכבה היא כ-16 GB, שכבות שלמות יכולות בדרך כלל להתאים ישירות על השבב. ברוב המקרים, משקולות המודל לעולם לא צריכות לזוז, והשכבות אינן צריכות להתפצל על פני פרוסות.
כל פרוסה משמשת כשלב אחד בפס ייצור. לדוגמה, פרוסה 1 מריצה שכבות 1-2 ושולחת הפעלות לפרוסה 2, שמריצה שכבות 3-4 ומעבירה תוצאות הלאה עד שהפרוסה האחרונה מייצרת את האסימון הבא. כדי לשרת בקשות רבות, Cerebras שומרת על הצינור מלא עם בקשות שונות. כל שלב יכול לעבוד על בקשה שונה בו-זמנית, וכל שלב יכול לעבד מיקרו-אצווה במקום בקשה בודדת. מיקרו-אצוות קטנות הופכות כל בקשה למהירה יותר, בעוד מיקרו-אצוות גדולות מגדילות את התפוקה הכוללת.
כמות הזיכרון על-השבב המוקצית למטמון KV קובעת את המספר המרבי של בקשות בו-זמניות. כל בקשה במעוף זקוקה למטמון KV משלה בכל פרוסת שכבה צפופה. Cerebras מציינת שמקביליות וגודל אצווה לבדם אינם מראים יעילות הסקה; מדד משמעותי יותר הוא תפוקת אסימונים כוללת ליחידת הספק, הנמדדת באותה מהירות יצירת פלט.
מקורות: cerebras.ai
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.