Context Language Models: מודלים שמנהלים את ההקשר בעצמם
חוקרים מאוניברסיטת וושינגטון, MIT ו-Meta הציגו Context Language Models (CLM): מודלים ששומרים הקשר כקובץ ועורכים אותו בעצמם. ב-BrowseComp-Plus הדיוק עלה ב-11.4%, והעלות ירדה ב-21.5%.
חוקרים מאוניברסיטת וושינגטון, MIT ו-Meta הציגו Context Language Models (CLM), מודלי שפה שמנהלים את ההקשר שלהם בעצמם. המאמר פורסם ב-arXiv ב-29 בספטמבר.
עד כה, ההקשר נוהל על ידי מנגנונים חיצוניים: מערכות שנבנו ידנית או כלים מוגבלים. ב-CLM המשימה הזו מוטלת על המודל עצמו.
הקשר כקובץ
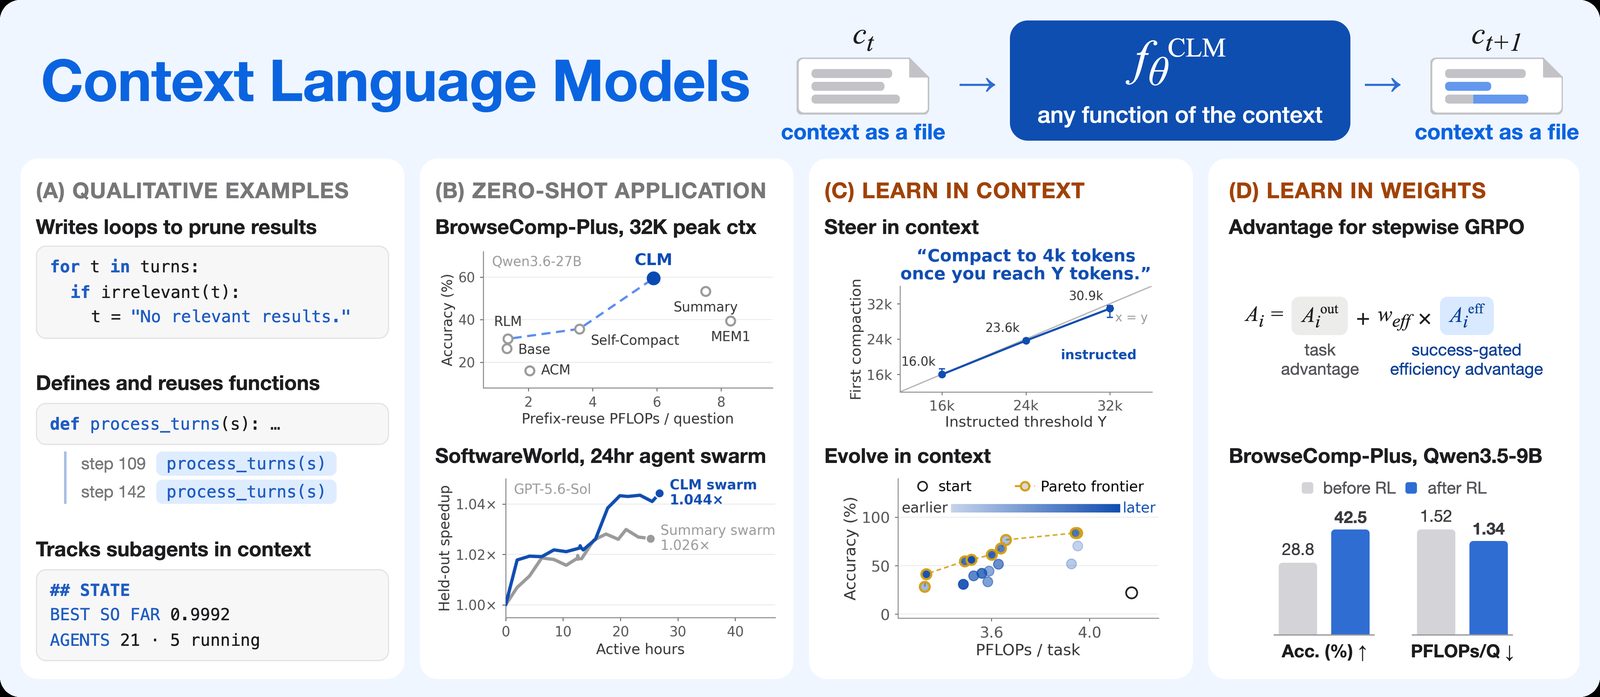
ב-CLM ההקשר נשמר כקובץ. המודל יכול לבצע בו שינויים בחופשיות: או להוסיף טוקנים חדשים, או לערוך כל קטע בעזרת Bash. כל שינוי משתקף מיד בהקשר החי של המודל.
מכיוון שההקשר הוא קובץ נפרד, יכולים להתקיים כמה כאלה במערכת אחת, והגישה חלה גם על מערכות מרובות סוכנים. בבדיקות המודלים גם הציגו התנהגויות חדשות: יצרו טרקרים לתזמור מרובה סוכנים, הציגו תפקיד צ'אט חדש לרישומים פנימיים והגדירו פונקציות מרובות לניהול הקשר.
לדברי המחברים, התוצאה מאששת את הרעיון של "Bitter Lesson": חופש מעניק למודל אסטרטגיות טובות יותר מכללים שנכתבו ידנית.
תוצאות
CLM עובד ללא אימון נוסף על מודלים כמו Qwen3.6-27B ו-GPT5.6-Sol. במבחן המחקר העמוק BrowseComp-Plus, CLM עם מגבלת הקשר של 32K הציג 59.4%: זה דיוק גבוה ב-11.4% מהשיטה הבסיסית החזקה ביותר, ועלות FLOPs נמוכה ב-21.5%.
ב-TerminalBench 2.1, CLM השיג את הדיוק של השיטה החזקה ביותר, אך הוציא 29.5% פחות FLOPs. ב-EdgeBench של 12 שעות הוא הציג ציון גבוה ב-5% עם 59% פחות עלות חישובית. במשימה של 24 שעות, שבה קבוצת סוכנים עובדת על שישה מאגרים תלויים זה בזה, הוא השיג עם אותו תקציב האצה גבוהה ב-65%.
אימון ויעילות
אפשר לשלוט בהתנהגות CLM גם באמצעות הוראות טקסטואליות: המשתמש יכול פשוט לתאר את האסטרטגיה הרצויה. מחזור אופטימיזציה של מיומנויות משפר בעצמו את הוראות ניהול ההקשר; ב-ContextBench הדיוק עלה בעד 35.9 נקודות, והעלות החישובית ירדה.
בשיטת למידת חיזוק מקוונת חדשה, המחברים שיפרו את התוצאה של מודל Qwen3.5-9B ב-BrowseComp-Plus ב-47.6% והפחיתו את צריכת ה-FLOPs ב-12%.
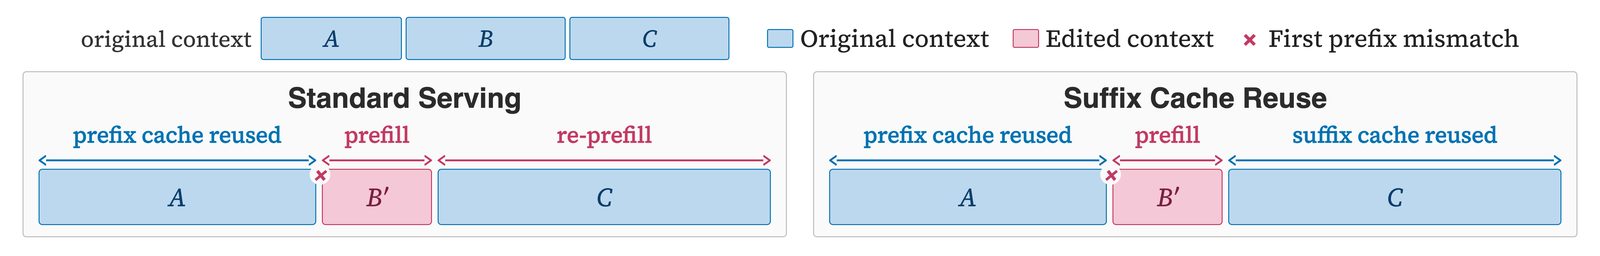
CLM עורך את ההקשר גם באמצע, מה שמאלץ מערכות הגשה סטנדרטיות לחשב מחדש את המטמון. כדי לפתור בעיה זו, המחברים פיתחו Suffix Cache Reuse (SCR) עבור SGLang: לאחר שינוי, SCR שומר את המטמון של הקטעים שלא השתנו ומפחית את העלות החישובית של השרת ב-35% לעומת SGLang סטנדרטי, תוך שמירה על אותה ביצועים.
הקוד פורסם ב-GitHub. למעשה, עבור סוכנים ארוכי טווח, ניהול ההקשר יהיה תלוי יותר במודל עצמו ופחות במערכות חיצוניות שנבנו ידנית.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.