SWE-Serve של NVIDIA חושף את הפער בין בדיקות מקומיות להגשה חיה
NVIDIA פרסמה את SWE-Serve, מדד שנבנה בסיוע צוות SGLang והופך 83 בקשות מיזוג ל-53 משימות הרצה. טלאים שעוברים את כל שאר הבדיקות נכשלים בבדיקות הגשה חיה בערך באחד מכל שלושה מקרים.
טלאי של סוכן קוד יכול לעבור את הבדיקות ועדיין להיכשל ברגע שהשרת טוען מודל אמיתי ומתחיל לטפל בבקשות. את הפער הזה מודד SWE-Serve, שפורסם על ידי NVIDIA ב-23 בספטמבר. המדד נבנה בסיוע צוות SGLang והופך 83 בקשות מיזוג של SGLang ל-53 משימות הרצה.
מה בודק SWE-Serve
המשימות מחולקות לשישה תחומים: פענוח ספקולטיבי ומתקדם (14), הפעלת מודלים ובקאנדים (12), קרנלים, קוונטיזציה וביצועים (8), ממשקי הגשה ונכונות בזמן ריצה (8), מטמון ומצב ריצה (7), והרצה מבוזרת ותזמון (4). שתים עשרה משימות פועלות על CPU ו-41 על H100 בודד של NVIDIA; המהדורה הראשונה אינה בודקת מנועי הסקה אחרים, הרצה על כמה מעבדים גרפיים או הגשה על כמה צמתים. הפתרון הממוצע משנה 553 שורות בשבעה קבצים, ותשע עשרה משימות מפעילות שרת אמיתי.
מה תופסות בדיקות ההגשה החיה
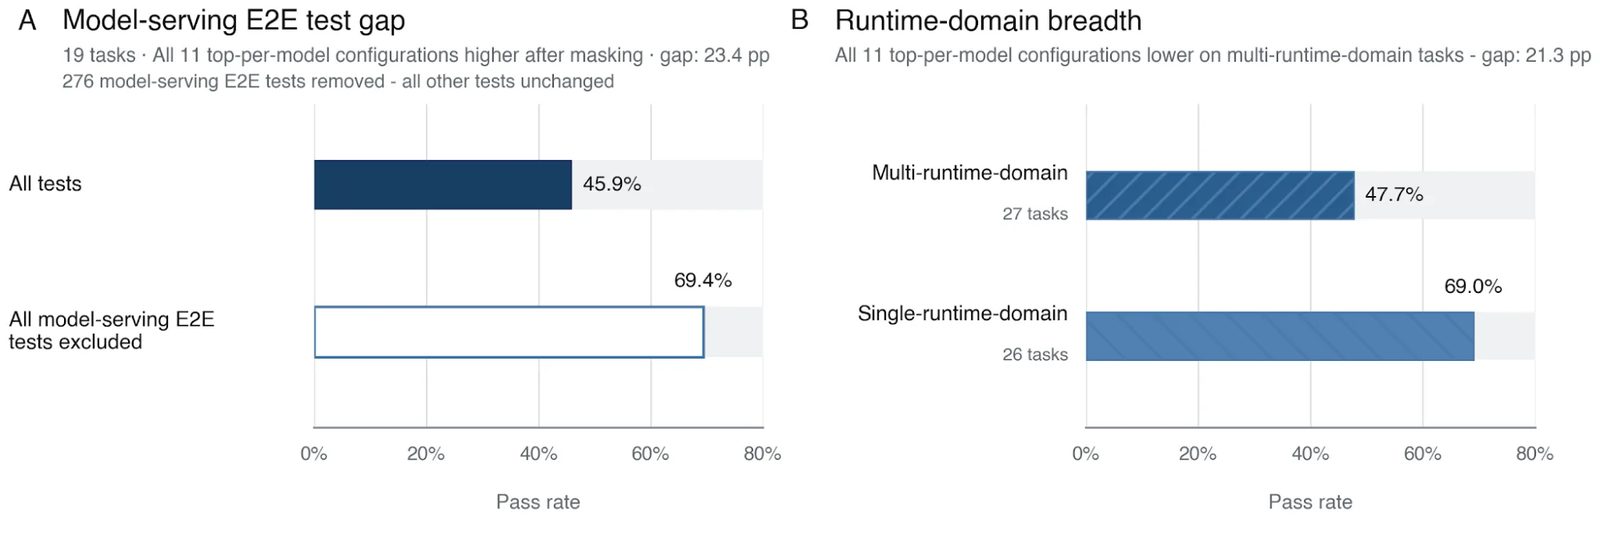
בתשע עשרה המשימות שמפעילות שרת אמיתי, אותם 627 טלאים עוברים ב-45.9% מהמקרים תחת המוודא המלא. כשמסירים את בדיקות ההגשה, השיעור עולה ל-69.4%: 147 טלאים עברו מכישלון להצלחה, וכשליש מהטלאים שעברו את כל שאר הבדיקות נכשלו בבדיקת הגשה. המשימות כוללות 276 בדיקות הגשה, 242 מהן נלקחו או הותאמו מ-SGLang. משימת Gemma 4 MoE ממחישה זאת: 16 מתוך 33 טלאים עברו כל בדיקה אחרת אך נכשלו בלפחות בדיקת הגשה אחת.
המחברים מדגישים כי להצלחה משמעות מצומצמת: היא מעידה רק שהטלאי עומד במוודא של המדד, ולא שהוא ניתן לפריסה, מוכן למיזוג או אושר על ידי מתחזקי SGLang.
היכן הסוכנים מאבדים נקודות
המסלול מהבקשה ועד הפלט מתחלק לארבעה תחומי ריצה: טיפול בבקשות וקלט-פלט, תזמון ומחזור החיים של הבקשה, הרצת המודל, וניהול KV-cache ומשאבים. 26 משימות בתוך תחום אחד עוברות ב-69.0% מהמקרים, ואילו 27 משימות החוצות כמה תחומים עוברות ב-47.7%, פער של 21.3 נקודות אחוז.
אחת עשרה מודלים ו-31 תצורות נבדקו באמצעות mini-swe-agent, סוכן מינימלי שמשתמש רק ב-Bash, בתנאים סגורים. ממוצע pass@1 נע בין 34.6% ל-75.5%. בראש הטבלה ניצבים Claude Opus 5 ו-GPT-5.6 Sol עם 75%, אך ארבעה מודלים שנעצרו על 64% נבדלים מאוד בעלות: מ-0.95 דולר עד 7.24 דולר למשימה, וזמן ריצה ממוצע שבין 25.5 ל-99.9 דקות.
כדי לבנות את המדד, הצוות סרק 786 מקורות, בנה 156 מועמדים ואישר 53; הקוד ללא שינוי היה חייב להיכשל בבדיקות ההתנהגות החדשה ועדיין לעבור את בדיקות הרגרסיה. בזמן ההערכה האינטרנט הציבורי ומאגרי המקור חסומים, כדי שהמודלים לא ימצאו פתרונות מוכנים.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.