Ai2 שיחררה את המודל AstaBrief 8B במשקלים פתוחים: מכין דוחות מדעיים מהר פי 3.5
Ai2 (Allen Institute for AI) שיחררה את המודל AstaBrief 8B במשקלים פתוחים: הוא מכין דוחות מצוטטים מקריאת מחקר וספרות שנאספה, ופועל ב-Fast mode בממוצע תוך 51.1 שניות, מהר פי 3.5 מ-Thinking mode.
Allen Institute for AI (Ai2) שיחררה ב-2 באוקטובר את המודל AstaBrief 8B במשקלים פתוחים. המודל מכין דוח מצוטט משאלות מחקר ומקטעי ספרות שנאספה, וכבר פועל ב-Asta כ-Fast mode, לצד Thinking mode.
בצינור המלא, Fast mode מכין דוח אחד בממוצע תוך 51.1 שניות, לעומת 178.5 שניות של Thinking mode, כלומר בערך פי 3.5 מהר יותר. המודל כותב את הדוח במעבר אחד ומדלג על שלבי הסיכום והאשכולות; לפי Ai2, האיכות לא נפגעה.
מודל פתוח לדוחות מדעיים
AstaBrief 8B הוא מודל של שמונה מיליארד פרמטרים על בסיס Qwen3-8B. חוקרי Ai2 עבדו בעיקר על נתוני post-training והערכה. המשקלים הפתוחים מאפשרים למוסדות להריץ את המודל על התשתית שלהם, מאחורי חומת אש, מה שחשוב למחקר רגיש.
כיצד אומן המודל
AstaBrief אומן בשני שלבים: supervised fine-tuning (SFT) ו-direct preference optimization (DPO). Ai2 בחרה בדרך פשוטה יותר במקום גישת RL יקרה ולא יציבה. שאלות האימון נלקחו מלוגים של משתמשים אמיתיים: לאחר סינון נותרו 90 אלף שאלות מחקר.
ל-SFT דוחות היעד נוצרו על ידי צינור ScholarQA (Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, GPT-4.1); לאחר סינון נותרו 47 אלף דוגמאות. ל-DPO זוגות הושוו על ידי שני מודלים שופטים (GPT-4.1 ו-DeepSeek-R1), ובמחץ הסופי יש עד 6 אלף דוגמאות. מבין ארבעה מסננים סטטיסטיים, הרווח הגדול ביותר הביאה הסרת דוגמאות בעלות צפיפות ציטוטים נמוכה.
תוצאות ושימוש
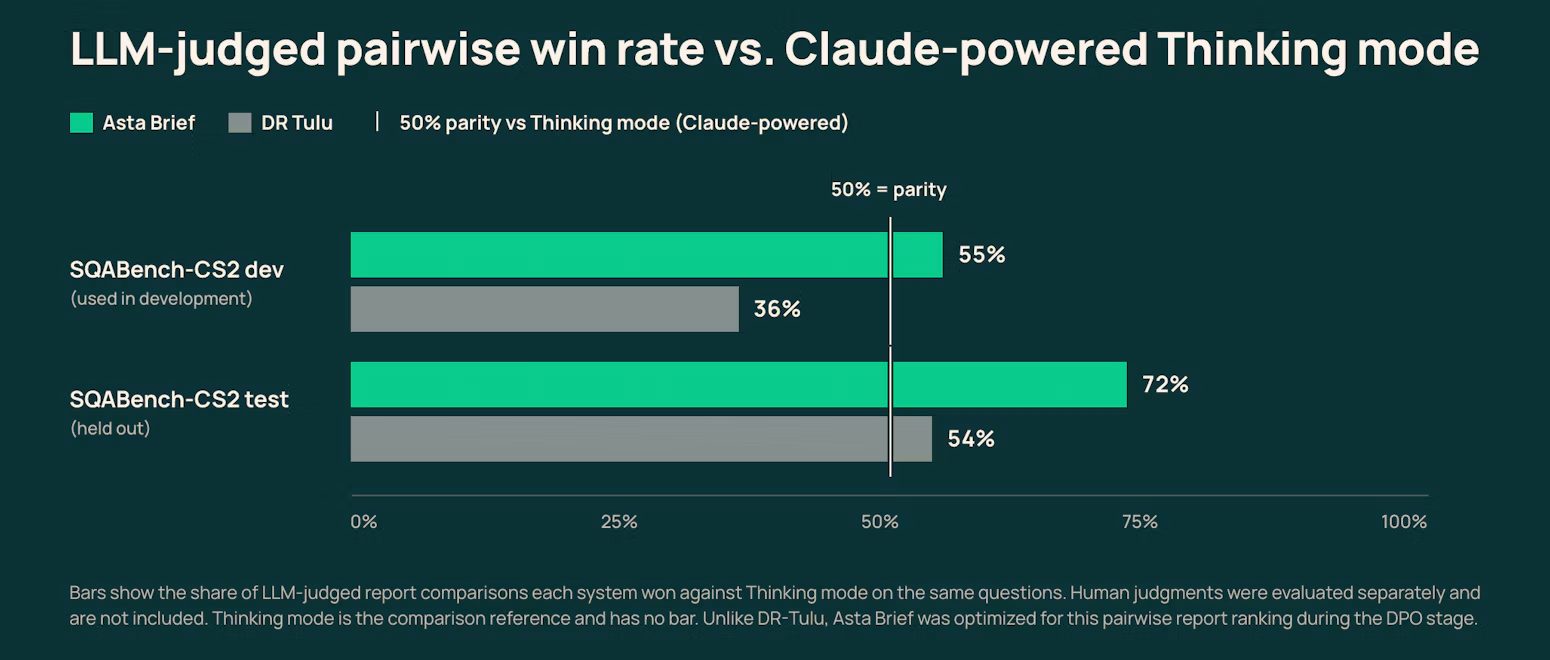
מטרת ההערכה העיקרית הייתה SQABench-CS2: 200 שאלות ממדעי המחשב. נמדדו ציון רובריקה, דיוק תשובה, דיוק ציטוטים והזיות; בנוסף נבדק ב-DeepScholarBench (63 שאלות) ונערך מחקר אנושי של 14 שאלות.
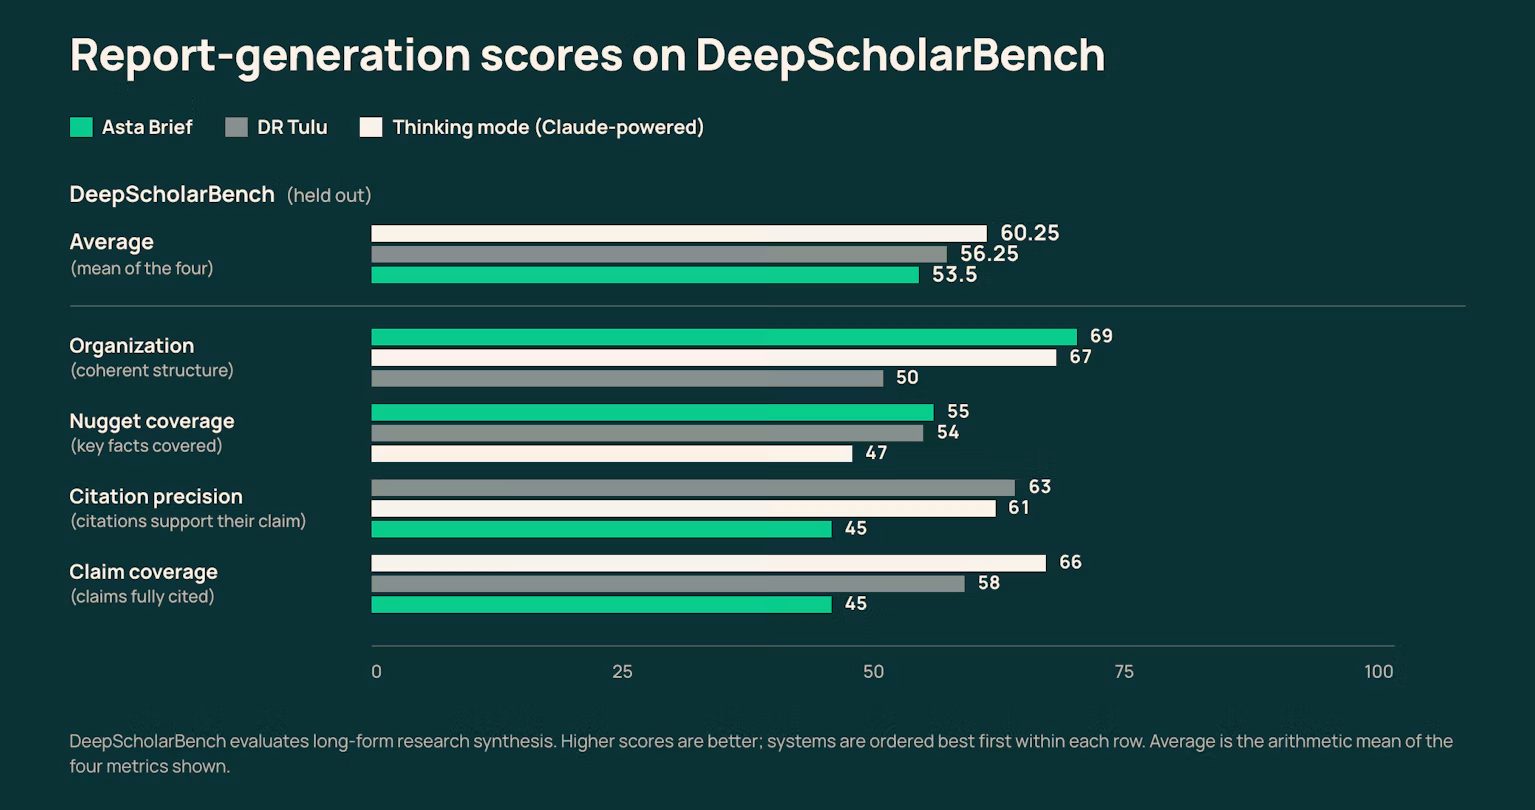
AstaBrief תחרותי מול צינור המבוסס על Claude ומול DR Tulu. במחקר האנושי DR Tulu מנצח ביתרון כללי, אך שניים מתוך שלושה חוקרים העניקו ל-AstaBrief יתרון בדיוק הציטוטים. Ai2 מציינת כי ההערכה נערכה בעיקר ב-2025 ולא חוזרה על מודלים נוכחיים.
שימוש מוקדם חיובי: 374 משתמשים ניסו את Fast mode, 29.1% מהם משתמשים בו יומיים או יותר, ובממוצע יוצרים 3.67 שרשורי דוחות. 23% העדיפו להישאר ב-Fast mode, 18% עברו בין מצבים ו-40% מהשרשורים רצו ב-Fast mode. משוב חיובי דומה בשני המצבים: 84.2% עבור Fast mode ו-85.2% עבור Thinking mode.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.