Qwen3.8-27B על RTX 3090 אחד מול שניים: 20%+ בפענוח, 14%+ ב-prefill קר ופי 3 בפרומפטים מהמטמון
בנצ'מרק אישי של Qwen3.8-27B ב-vLLM: כרטיס RTX 3090 אחד מול שניים במצב tensor parallelism. הכרטיס השני מוסיף 15–30% לפענוח ו-14% בממוצע ל-prefill קר, ושאר השיפור שייך למטמון ה-prefix.
Qwen3.8-27B, המודל הצפוף עם 27.8 מיליארד פרמטרים שיצא ב-14 באוגוסט, נכנס בכימות W4A16 לכרטיס בודד של 24 ג'יגה-בייט. ארסן אפוסטולוב מדד מה כרטיס RTX 3090 שני באמת מוסיף במצב tensor parallelism.
מה נמדד
שני השרתים רצים על vLLM עם prefix caching דלוק, מאותה תמונה ובאותן משקולות Qwen3.8-27B-W4A16-AutoRound-fast. כרטיס אחד מחזיק 22.6 ג'יגה-בייט VRAM והקשר של 131,072 טוקנים; הצמד מפצל את המשקולות ל-21.7 ג'יגה-בייט לכל כרטיס ומכפיל את ההקשר ל-262,144 טוקנים. המכונה נושאת שלושה כרטיסי RTX 3090, שני Xeon E5-2660 v4, 60 ג'יגה-בייט RAM ו-Ubuntu 26.04.
המדידה היא סקריפט של 150 שורות: בקשות בארבעה גדלים (מ-600 עד 9,300 טוקנים), כל אחת שלוש פעמים עם חציון, max_tokens=256 ו-temperature=0. כל בקשה קרה נושאת שורה ראשונה ייחודית, כך שאף prefix שמור לא מתאים.
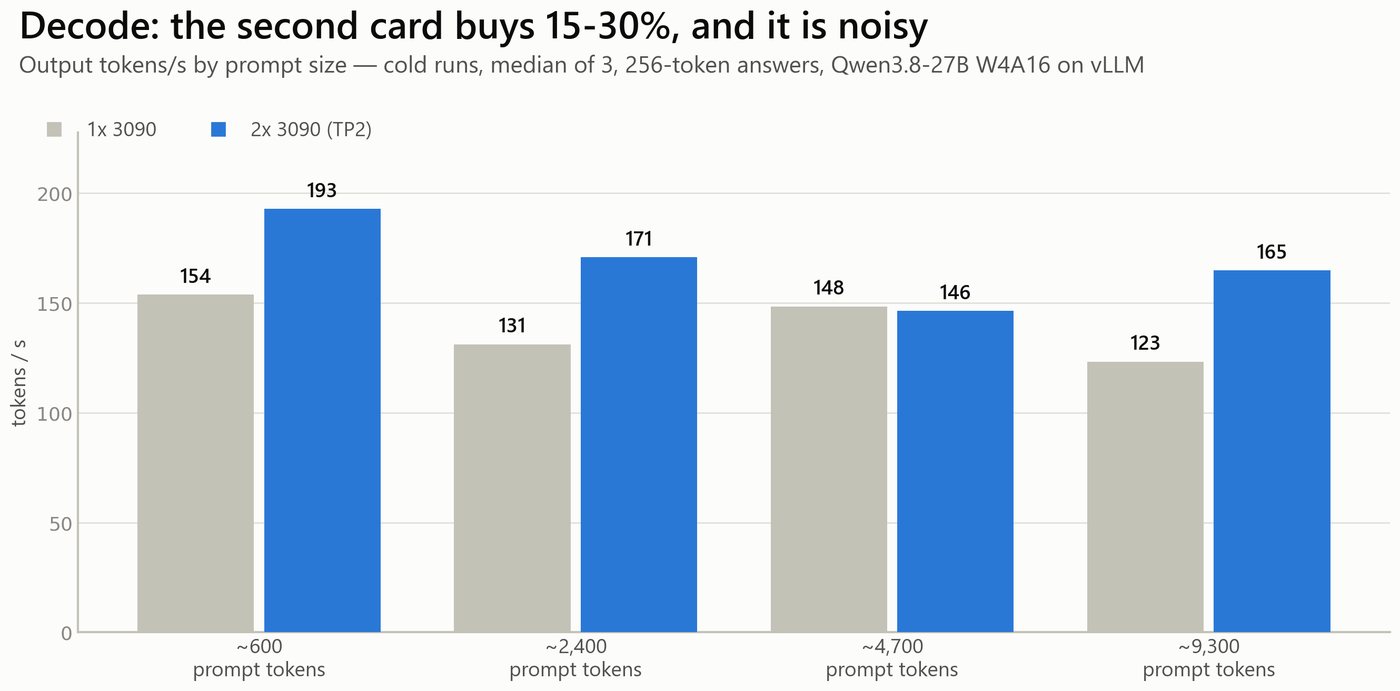
פענוח: 15–30% מהכרטיס השני
כרטיס אחד מחזיק 123–154 טוקנים לשנייה לאורך הטווח, הצמד 146–193. הרווח הממוצע היה 22%+ בהרצה הזו ו-13%+ בהרצה כשעה קודם, כי פענוח חד-זרימי נע בכ-10% בין הרצות בהפרש של שעה. המחבר משאיר את המספר לא מעוגל בכוונה: 15–30%, וצפו לקצה התחתון.
Prefill: הקר הוא הכרטיסים, החם הוא המטמון
prefill קר תלוי בחישוב: כרטיס אחד דוחף 1,100–1,220 טוקנים לשנייה, הצמד 1,230–1,360. הזמן לטוקן הראשון מטפס מ-0.53 שניות ל-8.5 בכרטיס אחד כשהפרומפט גדל מ-600 ל-9,300 טוקנים, ומ-0.50 ל-6.9 בשניים — פער של 6% ב-600 טוקנים, 23% ב-9,300, ובממוצע 14%.
בקשות חמות מספרות סיפור אחר: פרומפט חוזר תוך 0.5–0.75 שניות בצמד לעומת 0.5–1.7 בכרטיס הבודד; הפער של פי 2–3 שייך למטמון ה-prefix ולא לחומרה. הרמז באריתמטיקה: 8,600 טוקנים ב-0.56 שניות הם 15,000 טוקנים לשנייה, פי עשרה ממה ששני כרטיסי 3090 מספקים על מודל 27B.
כמה זה עולה
כששתי המכולות משרתות, המכונה צורכת 620 ואט מהשקע. מיליון טוקנים בקצב 150 טוקנים לשנייה אורכים כ-6,667 שניות, כלומר 1.15 קילוואט-שעה — 0.34 BGN ביום או 0.21 BGN בלילה בתעריף הבולגרי, בערך 0.20 או 0.12 דולר. DeepInfra מציגה את Qwen3.8-27B ב-3.00 דולר למיליון טוקני פלט.
אפוסטולוב אינו טוען שזה הופך את ה-API לעסקה גרועה: המחיר כולל חשמל, קירור וקיבולת פנויה של דאטה-סנטר. הנקודה הצרה: על חומרה שכבר פועלת, כל טוקן שמשרתים הוא כמעט מרווח נקי. הוא גם מסמן את גבול הבדיקה — בקשה בודדת, ו-continuous batching לא נבחן.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.