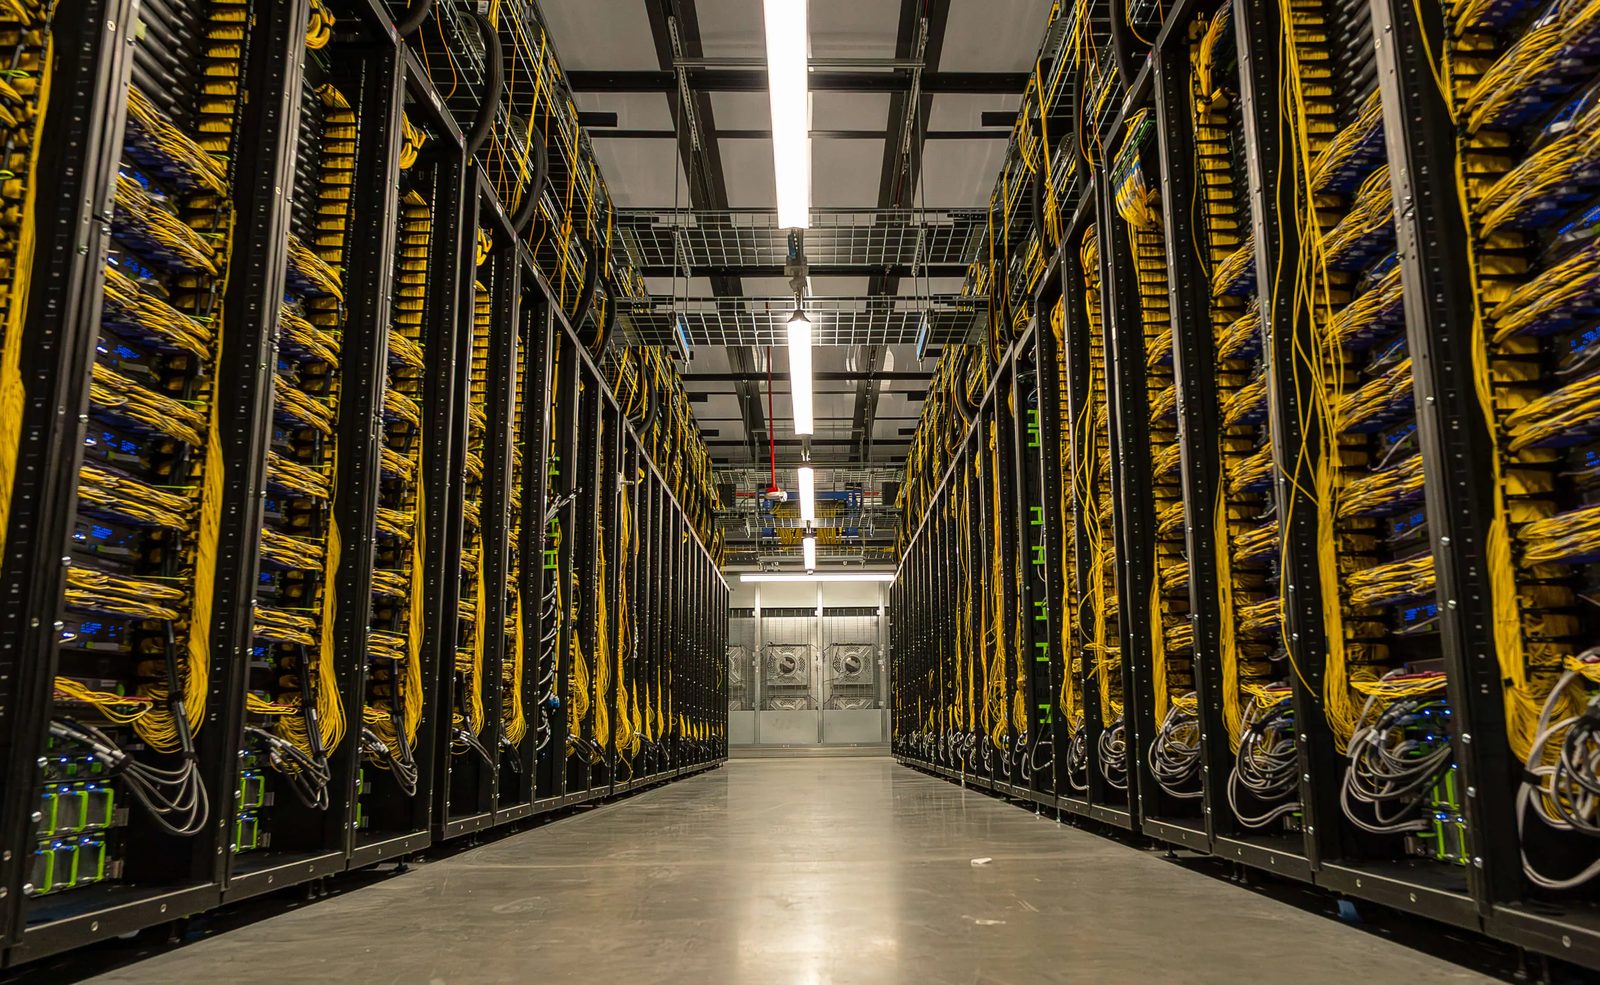
Meta משתמשת ב-GPU חלופיים שאינם בשימוש ובנקודות ביקורת כדי לשמור על אימון ה-AI של Prometheus
Meta מציינת שיותר מ-11 אחוז ממאיצי ה-GPU על-אשכול Prometheus שלה מתים או עומדים ללא שימוש כעתודה להגנה על אימון ה-AI. החברה מציינת נקודות ביקורת, עבודת NVLink והפרעות מעטות יותר תוך כדי שינוי קנה מידה לכיוון מיליון מאיצים.
עתודה סופגת כשלים
Meta אמרה שיותר מ-11 אחוז ממאיצי ה-GPU על-אשכול Prometheus שלה בניו אלבני, אוהיו, מתים או עומדים כעתודה ומחכים להחליף יחידה שנכשלה. מאגר הגיבוי הוא חלק מהתכנון של מערכת שתגיע, כך לפי Meta, בסופו של דבר לכ-ג'יגהואט של קיבולת ולכ-מיליון מאיצים, תוך שימוש במערכות מתלים של Nvidia Grace Blackwell ובהמשך במערכות Vera Rubin.
האשכול הנוכחי משתמש במערכות GB200 ו-GB300 עם 72 מאיצי GPU בכל תחום NVLink, אבל רק 64 מהם בשימוש בכל רגע נתון. שמונת הנותרים משמשים כעתודה חמה. Meta אמרה שזה משמעותי כי מאיץ GPU אחד שנכשל עלול אחרת להוריד מתלה שלם ולשבש ריצת אימון. עם גיבוי, יחידת החילוף יכולה להשבץ, למרות שהכשל עדיין גורם להפרעה קצרה יותר.
כאשר Prometheus התחיל את השלב הראשון שלו, Meta אמרה שהיא ראתה כ-1,000 הפרעות ביום לכל 8,000 מאיצי GPU. הפרעה משמעה שמשהו קרס, נכשל או שנגמר הזמן, וריצת האימון נסוג לנקודת הביקורת האחרונה הידועה כטובה. Meta אמרה שכעבור כשנה היא הפחיתה את מספר ההפרעות ב-99 אחוז, לכ-11 ביום לכל 8,000 מאיצי GPU.
נקודות ביקורת מגבילות את החזרה לאחור
Meta תיארה גם כיצד היא מכליאה כשלים בתוך משימות אימון גדולות שמשתמשות במקביליות נתונים, שבהן מספר עותקים של מודל שוכנים באשכול. אם ניתן לבודד כשל לעותק מודל אחד של מקביליות הנתונים, עותק זה עובר למצב לא מקוון בעוד שאר האשכול חוזר על השלב וממשיך לאמן. הפיסה הפגועה מופעלת מחדש על מארחי עתודה ומסנכרנת מחדש, ומה שיכול היה להיות עצירה מלאה הופך להפחתה זמנית בתפוקה הכוללת.
אם הכשל חורג מתחום מקביליות הנתונים, Meta נשענת על נקודות ביקורת. החברה אמרה שארכיטקטורת נקודות הביקורת המבוזרת שלה שומרת באופן א-סינכרוני את מצב המודל, כולל גרדיאנטים ונתוני אופטימיזציה, לרמות אחסון מרובות. זה מאפשר לריצה לחזור לעבודה ממצב שמור במקום להתחיל מחדש. Meta תיארה את העבודה כהכרחית כדי לשמור על מודלים כמו Muse Spark וה-Muse Wonder העדכני יותר במסלול.
אתגר אחד היה לגרום למרקמי NVLink להתנהג כמו מאיץ גדול אחד. Meta אמרה שבמערכות H100 ו-H200 הקודמות היו שמונה מאיצי GPU לכל תחום NVLink, בעוד Nvidia Blackwell הרחיבה זאת פי תשע. עם יותר מ-600,000 חיבורי NVLink, אפילו הדרדרות שולית באות הפעילה מחזורי שיקום תכופים. Meta אמרה שהשתמשה בטלמטריה רציפה ובצריבות אבחון L11 כדי לבודד קישורים חלשים לפני שהמערכות נכנסו לייצור.
חשמל היה נושא נוסף. Meta אמרה שהפעלה וכיבוי של עשרות אלפי מאיצי GPU עבור ריצת אימון עלולים ליצור טרנזיינטים חשמליים גדולים שעלולים להציף את ציוד אספקת החשמל. החברה אמרה שבאמצעות התמקדות ביציבות ובאמינות של האשכול היא הגיעה ל-goodput של יותר מ-85 אחוז עבור פרה-אימון וליותר מ-90 אחוז עבור למידת חיזוק על Muse Wonder. לקראת העתיד, Meta רוצה להפחית את שיעור ההפרעות לשתי הפרעות ביום לכל 8,000 מאיצי GPU, או כ-100,000 שעות GPU של זמן ממוצע בין הפרעות.
מקורות: The Register
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.