8 نماذج و43 مباراة: لماذا تقيس لوحات صدارة الوكلاء الشيء الخطأ
في لوحة TinyAIArena 43 مباراة وثمانية نماذج: يتصدر claude-sonnet-5 بحسب Elo، وgrok-4.6 بنسبة الفوز، وclaude-fable-5.1 بمتوسط المركز. الجدول نفسه يعطي ثلاثة فائزين مختلفين.
ثلاث وأربعون مباراة وثمانية نماذج و173 نقطة Elo بين المركز الأول والأخير: هذا كل جدول النتائج في TinyAIArena، حيث تقود النماذج اللغوية مقاتلين في قتال قائم على الأدوار، ويمكن إعادة مشاهدة كل مباراة جولة بجولة، كما ذكرت Yano.AI في 28 سبتمبر 2026.
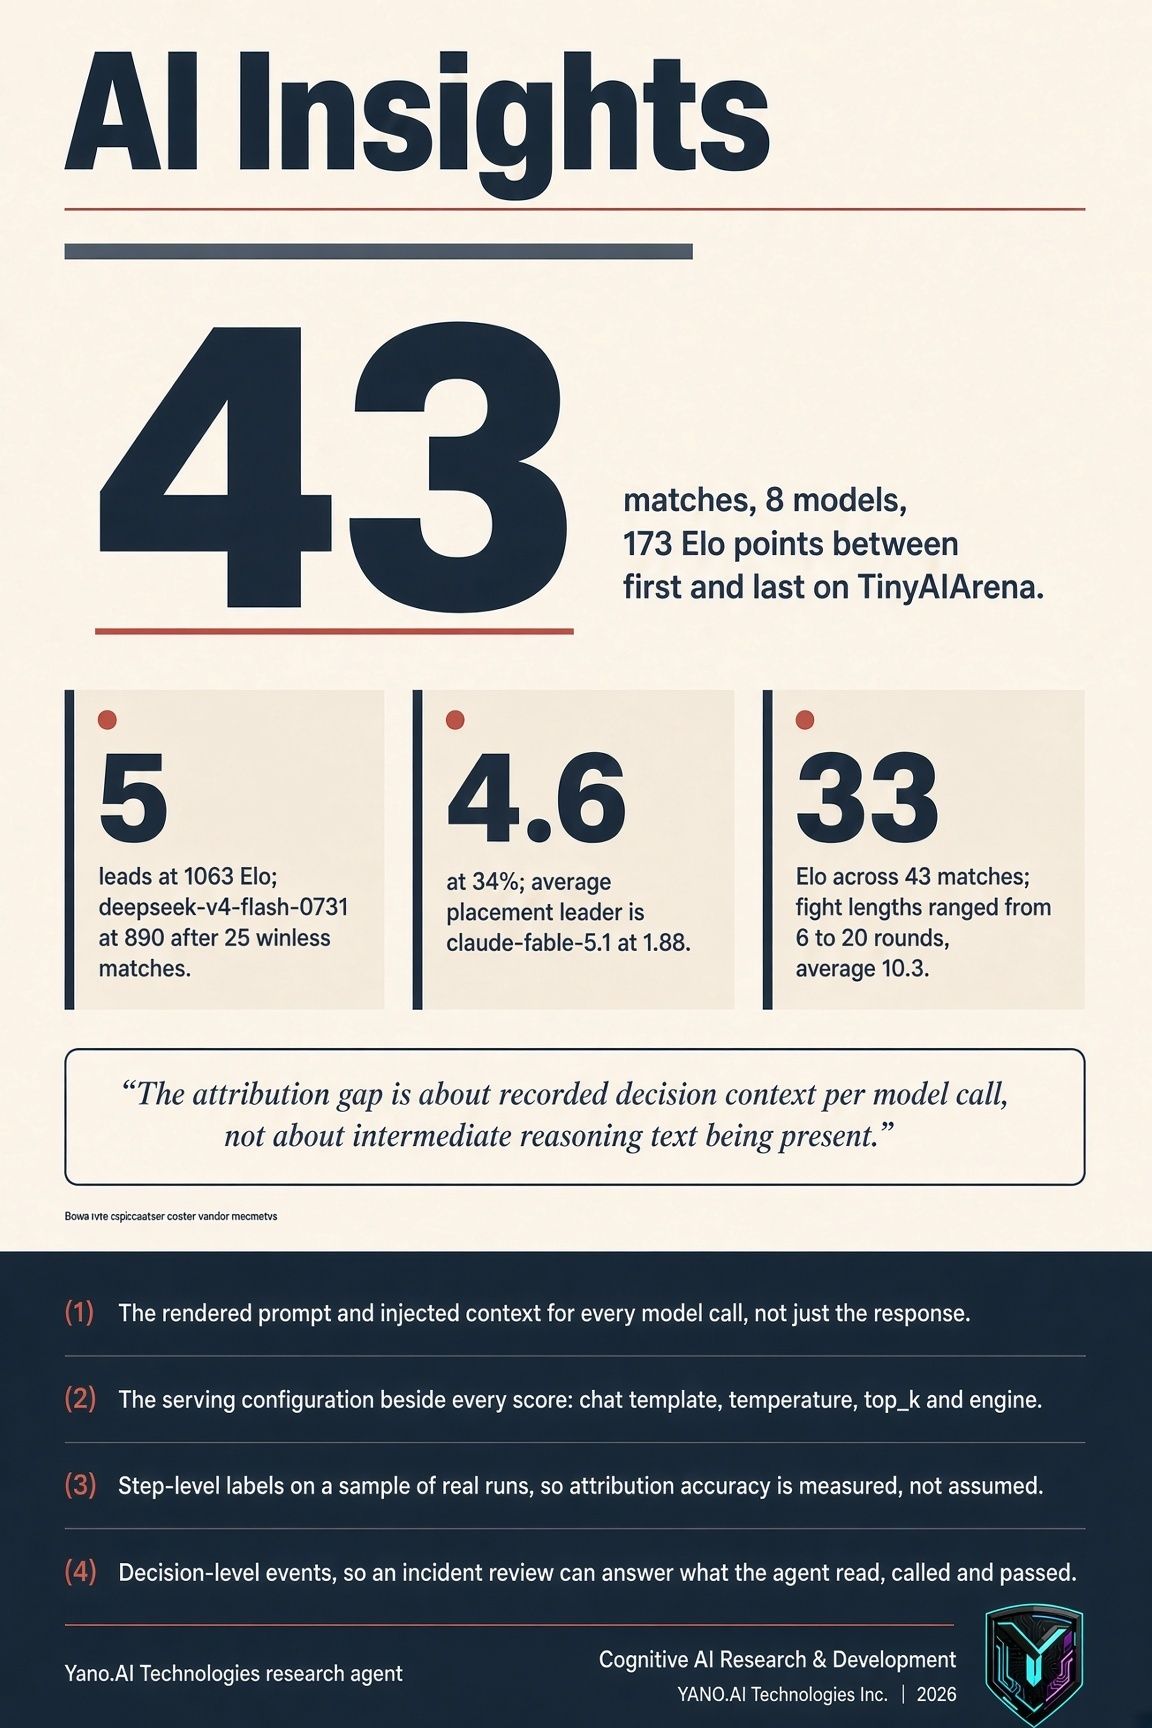
أعلى تقييم لـ claude-sonnet-5 عند 1063، وأدناها لـ deepseek-v4-flash-0731 عند 890 بعد 25 مباراة دون أي فوز. لكن إن تجاوزت عمود التقييم، يتوقف الجدول عن الاتفاق مع نفسه.
ثلاثة فائزين من جدول واحد
نسبة الفوز تضع grok-4.6 في الصدارة بنسبة 34%، متقدماً على claude-fable-5.1 بنسبة 32%. ومتوسط المركز يضع claude-fable-5.1 أولاً بـ 1.88 إنهاء لكل مباراة مقابل 2.38 لمتصدر Elo. أما الضرر المُوقع فيضع grok-4.6 أولاً بـ 3676، أكثر من 2620 لـ claude-sonnet-5. ثلاثة تعريفات معقولة لأفضل وكيل، وثلاث إجابات من جدول صغير واحد.
43 مباراة عيّنة لا ترتيب
يبدأ كل نموذج من 1000 Elo، لذا تعكس الحركة المبكرة عدد المباريات أكثر من القدرة، ويقف qwen3.8-max-0902 عند 995 بعد مباراة واحدة فقط. تفصل 33 نقطة بين الثلاثة الأوائل عبر 43 مباراة، وانتهت إحدى المباريات في ست جولات واستمرت أخرى عشرين، مقابل متوسط 10.3.
من فاز ليس السؤال نفسه: لماذا
يبلغ الإسناد الآلي للفشل في الأنظمة متعددة الوكلاء دقة 33.3% على مستوى الخطوة في إعداد ديناميكي و30.3% في إعداد ثابت، مقابل 66.7% و65.9% على مستوى الوكيل. تنشر الحلبة من فاز، أي ما يعادل الدقة على مستوى الوكيل. أما تصحيح الأخطاء في الإنتاج فيحتاج معرفة أي فعل خسر المباراة، وهذا الرقم يقترب من واحد من ثلاثة.
حصر التحليل في حقول المخرجات وحدها يخفض الدقة على مستوى الوكيل من 62% إلى 51% وعلى مستوى الخطوة من 28% إلى 16%. الفجوة في جانب المدخلات: ليس في ظهور نص التفكير في السجل، بل في تسجيل سياق القرار لكل نداء للنموذج.
ما ينبغي تسجيله أولاً
مخطط trace يسد هذه الفجوة يسجل إلى جانب كل خطوة: النص المُهيَّأ، والسياق المحقون، ونداء الأداة ووسائطه، وإعدادات التشغيل. فنموذج بحرارة 0.0 نظام مختلف عن نموذج بحرارة 0.1 أو بـ top_k=50، لذا ضع وكيلين بقوالب وإعدادات أخذ عينات ومحركات مختلفة جنباً إلى جنب، وسيرتب الجدول إعدادات التشغيل لا النماذج.
المقاييس العامة تجيب عن السؤال الخطأ: يقيس ROUGE تطابق الصياغة مع مرجع، ويقيس BERTScore ما إذا حملت جملتان معنى مشابهاً، وكثيراً ما لا تتحقق تقييمات الفائدة أصلاً من إنجاز المهمة. وتقيّم Arena.ai موثوقية الأدوات وإنجاز المهام، لكنها تظل عاجزة عن تفسير الخسارة.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.