Context Language Models: نماذج تدير السياق بنفسها
قدم باحثون من جامعة واشنطن وMIT وMeta نماذج Context Language Models (CLM): نماذج تخزن السياق كملف وتحرره بنفسها. في BrowseComp-Plus ارتفعت الدقة بنسبة 11.4%، وانخفضت التكلفة بنسبة 21.5%.
قدم باحثون من جامعة واشنطن وMIT وMeta نماذج Context Language Models (CLM)، وهي نماذج لغوية تدير سياقها بنفسها. نُشر البحث على arXiv في 29 سبتمبر.
حتى الآن كانت آليات خارجية تدير السياق: أنظمة مبنية يدويًا أو أدوات محدودة. في CLM تُوكل هذه المهمة إلى النموذج نفسه.
السياق كملف
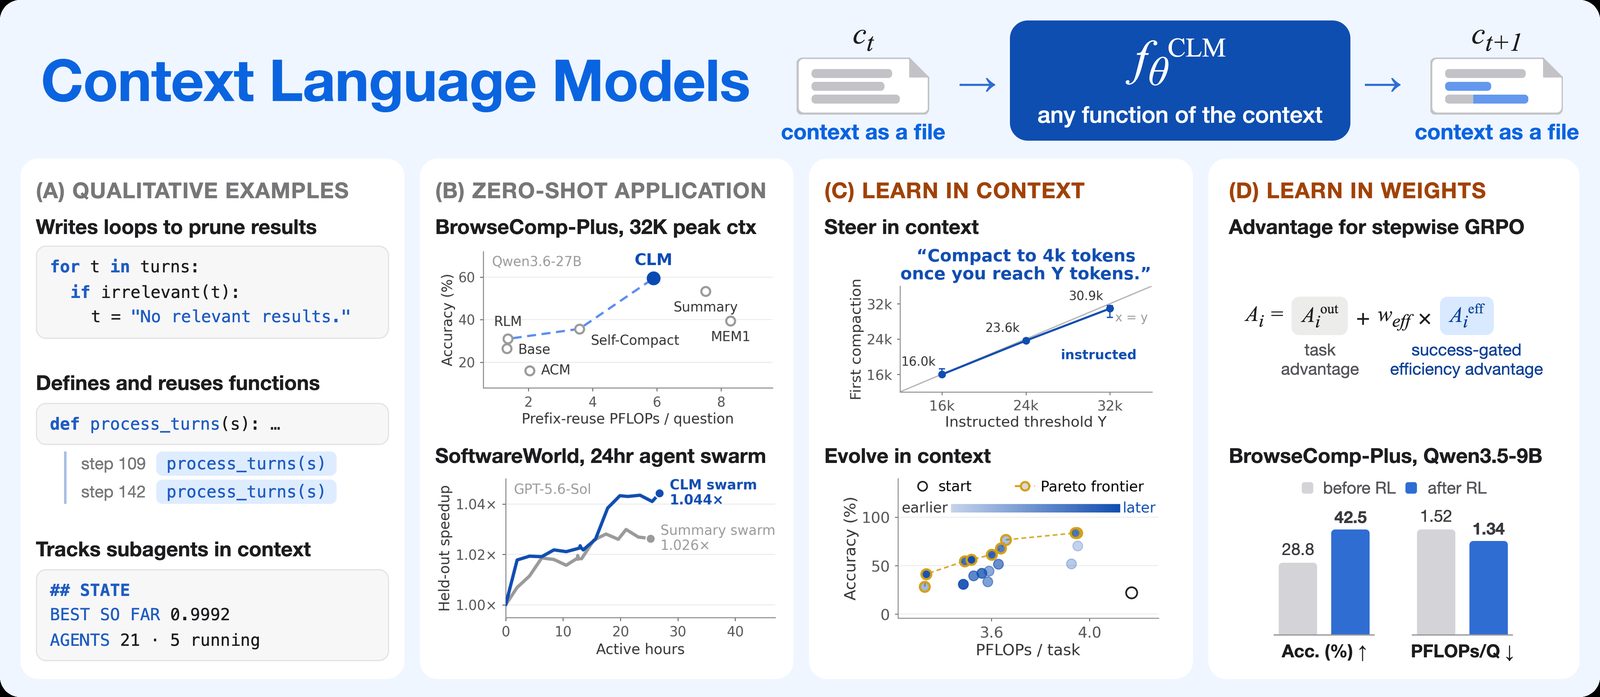
في CLM يُخزَّن السياق كملف. يستطيع النموذج إجراء تغييرات فيه بحرية: إما إضافة رموز جديدة، أو تحرير أي مقطع باستخدام Bash. كل تغيير ينعكس فورًا في السياق الحي للنموذج.
ولأن السياق ملف منفصل، يمكن وجود عدة ملفات منه في نظام واحد، ويمتد النهج إلى الأنظمة متعددة الوكلاء. في الاختبارات أظهرت النماذج سلوكيات جديدة أيضًا: أنشأت متتبعات لتنسيق الوكلاء المتعددين، وأدخلت دور محادثة جديد للسجلات الداخلية، وعرّفت وظائف متعددة لإدارة السياق.
وفقًا للمؤلفين، تؤكد النتيجة فكرة "Bitter Lesson": الحرية تمنح النموذج استراتيجيات أفضل من القواعد المكتوبة يدويًا.
النتائج
يعمل CLM دون تدريب إضافي على نماذج مثل Qwen3.6-27B وGPT5.6-Sol. في معيار البحث العميق BrowseComp-Plus، سجّل CLM بحد سياق 32K نسبة 59.4%: أي دقة أعلى بنسبة 11.4% من أقوى طريقة أساسية، وتكلفة FLOPs أقل بنسبة 21.5%.
في TerminalBench 2.1 حقق CLM دقة أقوى طريقة، لكنه أنفق FLOPs أقل بنسبة 29.5%. في EdgeBench لمدة 12 ساعة أظهر نتيجة أعلى بنسبة 5% مع تكلفة حسابية أقل بنسبة 59%. في مهمة لمدة 24 ساعة، حيث تعمل مجموعة وكلاء على ستة مستودعات مترابطة، حقق بنفس الميزانية تسريعًا أكبر بنسبة 65%.
التدريب والكفاءة
يمكن أيضًا التحكم في سلوك CLM بتعليمات نصية: يستطيع المستخدم ببساطة وصف الاستراتيجية المطلوبة. دورة تحسين المهارات تحسّن بنفسها تعليمات إدارة السياق؛ في ContextBench ارتفعت الدقة بحد أقصى 35.9 نقطة، وانخفضت التكلفة الحسابية.
بطريقة جديدة للتعلم المعزز عبر الإنترنت، حسّن المؤلفون نتيجة نموذج Qwen3.5-9B في BrowseComp-Plus بنسبة 47.6% وقللوا استهلاك FLOPs بنسبة 12%.
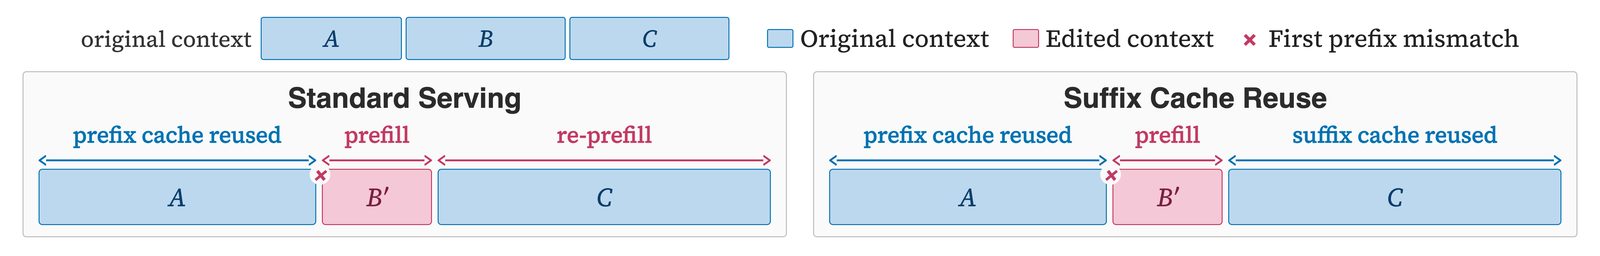
يحرر CLM السياق حتى في المنتصف، مما يدفع أنظمة الخدمة القياسية إلى إعادة حساب الذاكرة المؤقتة. لحل هذه المشكلة، طور المؤلفون Suffix Cache Reuse (SCR) لـ SGLang: بعد التغيير يحتفظ SCR بذاكرة المقاطع التي لم تتغير ويقلل التكلفة الحسابية للخادم بنسبة 35% مقارنة بـ SGLang القياسي، مع الحفاظ على الأداء نفسه.
الكود منشور على GitHub. عمليًا، بالنسبة للوكلاء طويلي الأمد، ستعتمد إدارة السياق أكثر على النموذج نفسه وأقل على الأنظمة الخارجية المبنية يدويًا.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.