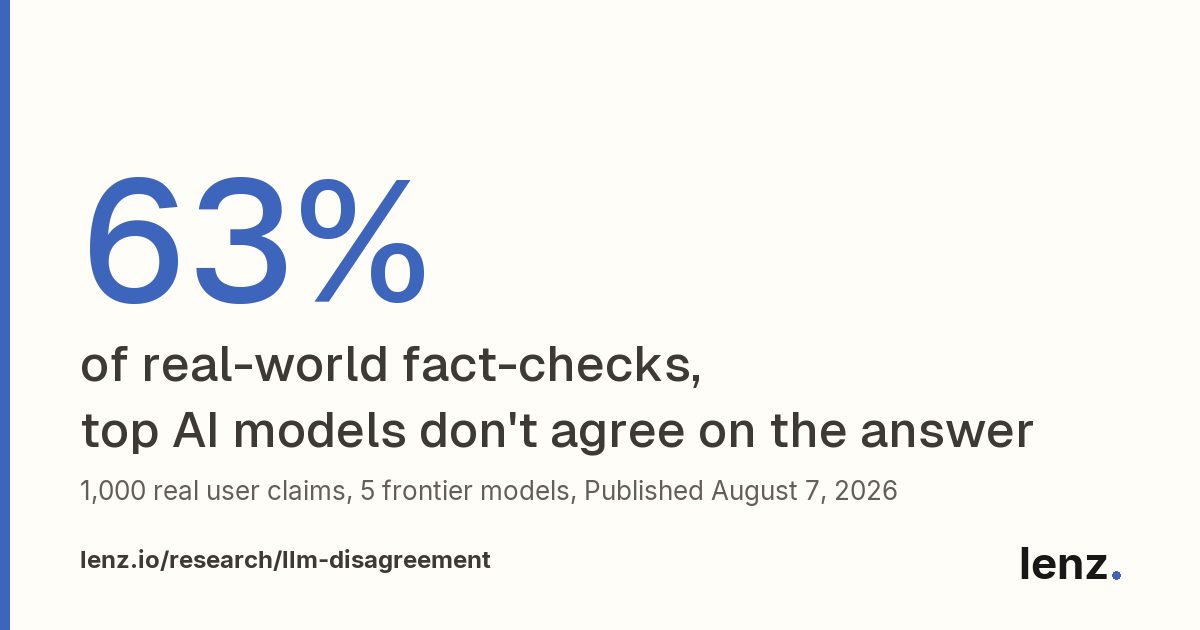
دراسة: نماذج LLM المتقدمة تختلف في 67% من عمليات التحقق الواقعية
قدّمت Lenz 1000 ادعاء حقيقي من مستخدمين إلى خمسة نماذج متقدمة: في 67% منها تنقسم اللجنة، وفي 34% يبلغ الفارق بين الأحكام مستويين أو أكثر، أي أن نموذجًا واحدًا على الأقل مخطئ.
نشرت منصة التحقق من المعلومات Lenz دراسة حول مدى تكرار اختلاف نماذج اللغة الرائدة حول عمليات التحقق من وقائع واقعية. قدّمت الشركة 1000 ادعاء حديث قدّمها مستخدمون إلى خمسة نماذج متقدمة — GPT-5.4 وClaude Opus 4.7 وGemini 3 Pro وGemini 3 Pro مع البحث وSonar Pro من Perplexity — وطلبت من كل منها اختيار حكم واحد من أربعة: صحيح، أو صحيح غالبًا، أو مضلّل، أو خاطئ.
ثلثا الادعاءات تقسم اللجنة
في 67% من الادعاءات (672 من 1000؛ بفاصل ثقة 95% بين 64 و70) خالف نموذج واحد على الأقل حكم الأغلبية أو لم تتشكل أغلبية أصلًا. وفي 34% أخرى من الادعاءات (343) ظهر فارق بمستويين أو أكثر بين النموذجين الأكثر اختلافًا — وهو خلاف جوهري حول الجواب لا مجرد تغيّر في درجة الثقة.
كان التوافق بين النماذج ملموسًا لكنه محدود: بلغت قيمة ألفا كريبندورف على المقياس الترتيبي 0.639. تتفق اللجنة على الأحكام القاطعة وتنشق في منتصف المقياس: من بين 328 ادعاءً اتفقت عليها النماذج الخمسة، جاءت أربعة فقط بإجماع على «مضلّل» ولا شيء على «صحيح غالبًا».
أين تتقارب النماذج
كان أقرب زوج هو Gemini 3 Pro ونسخته المدعومة بالبحث، باتفاق في 75% من الادعاءات — وهو أمر غير مفاجئ كما يلاحظ المؤلفون لأن النموذجين يتشاركان نموذجًا أساسيًا. أما أوسع الأزواج اختلافًا، بنسبة 53%، فكانت Claude Opus 4.7 مقابل نسختي Gemini وGemini 3 Pro مقابل Sonar Pro. وتراوح التوافق مع بقية اللجنة بين 69% و81%.
ولأن حكمًا واحدًا فقط يمكن أن يكون صحيحًا في كل ادعاء، تقدّم الدراسة أيضًا حدًا أدنى للخطأ. وبافتراض أن الحكم الأكثر شيوعًا في اللجنة هو الصحيح — وهو أكثر الفروض تسامحًا — فقد أخطأ نموذج واحد على الأقل في 67% من الادعاءات، ونموذجان على الأقل في 45%، وثلاثة على الأقل في 13% حيث لم يحقق أي حكم أغلبية.
ما لا تقوله الدراسة
تشدّد Lenz على أن أغلبية النماذج ليست حقيقة مطلقة: فالأغلبية تخطئ أحيانًا والنموذج المخالف يصيب أحيانًا، والشركة تستخدم الأغلبية كنقطة مرجعية بنيوية فقط. ولم تُدرج أحكام Lenz نفسها في التحليل. ويستبعد المجموعة الادعاءات الخاصة، وتقديمات الموظفين، والسجلات شبه المتطابقة، والحالات التي فشل فيها أي نموذج في إنتاج حكم قابل للتحليل.
الدراسة لقطة مجمّدة بالإصدار 1.0 وبيانات حتى 21 مايو 2026، وملف CSV لكل ادعاء متاح للعموم. وستضع دراسة لاحقة وسمًا بشريًا على كل ادعاء وتستخدم هذه الوسوم مرجعًا لرسم خريطة انحراف لجان النماذج المتقدمة وLenz نفسها عن الإجماع البشري.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.