معيار SWE-Serve من NVIDIA يكشف الفجوة بين الاختبارات المحلية والخدمة الحية
أعلنت NVIDIA عن معيار SWE-Serve المطوَّر بمشاركة فريق SGLang، والذي يحوّل 83 طلب دمج إلى 53 مهمة قابلة للتنفيذ. نحو ثلث الرقع التي تجتاز سائر الاختبارات تفشل في اختبارات الخدمة الحية.
قد تنجح رقعة يكتبها وكيل برمجي في اجتياز الاختبارات، لكنها تفشل بمجرد أن يحمّل الخادم نموذجاً حقيقياً ويبدأ في معالجة الطلبات. هذا هو الفارق الذي يقيسه معيار SWE-Serve الذي نشرته NVIDIA في 23 سبتمبر. طُوِّر المعيار بمشاركة فريق SGLang، ويحوّل 83 طلب دمج في SGLang إلى 53 مهمة قابلة للتنفيذ.
ما الذي يختبره SWE-Serve
تتوزع المهام على ست عائلات: الفك التخميني والمتقدم (14)، تفعيل النماذج والخلفيات (12)، الأنوية والتكميم والأداء (8)، واجهات الخدمة وصحة التنفيذ (8)، التخزين المؤقت (7)، والتنفيذ الموزع والجدولة (4). تعمل اثنتا عشرة مهمة على المعالج المركزي و41 مهمة على بطاقة NVIDIA H100 واحدة؛ ولا يغطي الإصدار الأول محركات استدلال أخرى ولا التنفيذ على عدة بطاقات أو الخدمة على عدة عقد. يعدّل الحل المرجعي الوسيط 553 سطراً في سبعة ملفات، وتسعة عشر مهمة تشغّل خادماً حقيقياً.
ما الذي تكشفه اختبارات الخدمة الحية
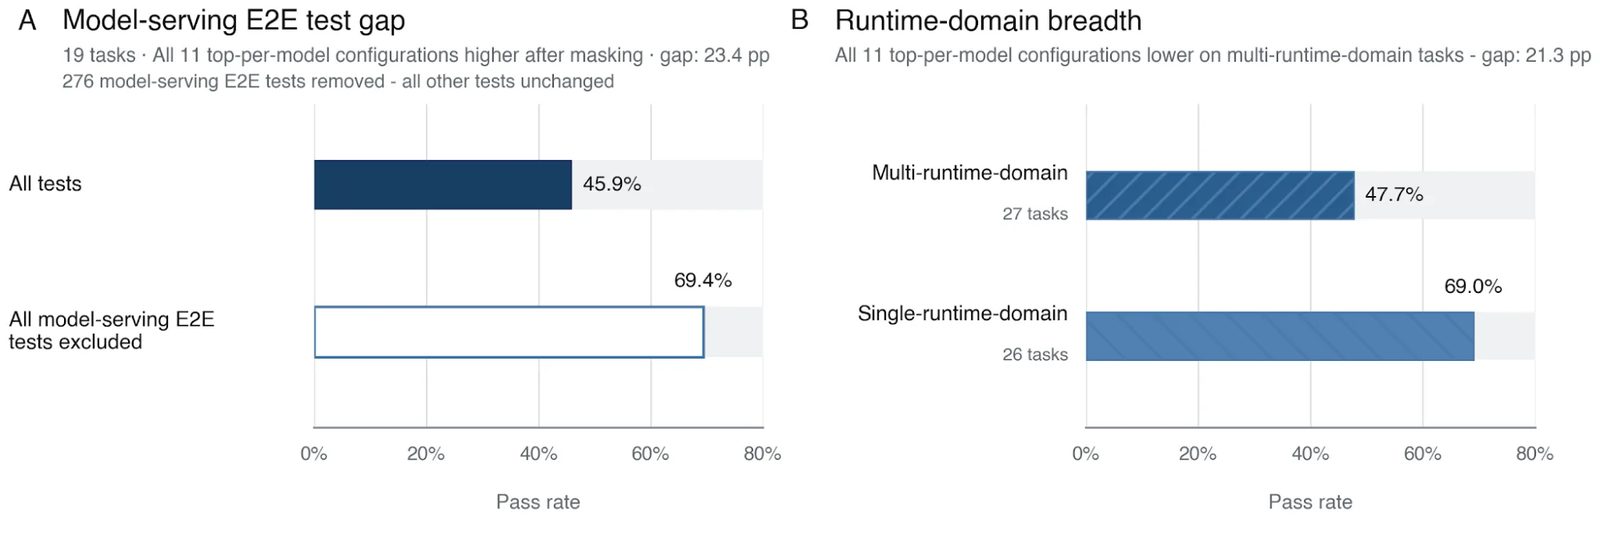
في المهام التسع عشرة التي تشغّل خادماً حقيقياً، تجتاز الرقع نفسها وعددها 627 ما نسبته 45.9% عند استخدام المدقق الكامل. وعند استبعاد اختبارات الخدمة يرتفع المعدل إلى 69.4%، أي إن 147 رقعة انتقلت من الفشل إلى النجاح، ويفشل نحو ثلث الرقع التي اجتازت سائر الفحوص في اختبار خدمة على الأقل. وتضم هذه المهام 276 اختبار خدمة، 242 منها مأخوذة أو مقتبسة من SGLang. وتوضح مهمة Gemma 4 MoE ذلك: فقد اجتاز 16 من 33 رقعة كل الفحوص الأخرى لكنها فشلت في اختبار خدمة حية واحد على الأقل.
يشدد المؤلفون على أن معنى النجاح محدود: فهو يعني فقط أن الرقعة تستوفي مدقق المعيار، وليس أنها جاهزة للنشر أو للدمج أو أنها حظيت بموافقة مطوري SGLang.
أين يخسر الوكلاء النقاط
ينقسم المسار من الطلب إلى النتيجة إلى أربعة نطاقات تشغيل: معالجة الطلبات والإدخال والإخراج، والجدولة ودورة حياة الطلب، وتنفيذ النموذج، وإدارة ذاكرة KV-cache والموارد. فالمهام الست والعشرون المحصورة في نطاق واحد تجتاز بنسبة 69.0%، أما السبع والعشرون الممتدة على عدة نطاقات فتبلغ 47.7%، أي فارق قدره 21.3 نقطة مئوية.
اختُبر أحد عشر نموذجاً و31 إعداداً عبر mini-swe-agent، وهو وكيل بسيط يستخدم Bash فقط، في ظروف مغلقة. وتراوح متوسط pass@1 بين 34.6% و75.5%. ويتصدر Claude Opus 5 وGPT-5.6 Sol القائمة بنسبة 75%، لكن أربعة نماذج تعادلت عند 64% تختلف كلفتها اختلافاً حاداً: من 0.95 دولار إلى 7.24 دولار للمهمة، وبزمن تنفيذ وسطي بين 25.5 و99.9 دقيقة.
ولبناء المعيار، راجع الفريق 786 مصدراً وبنى 156 مرشحاً واعتمد 53 منها؛ وكان على الكود دون تعديل أن يفشل في اختبارات السلوك الجديد مع استمراره في اجتياز اختبارات الانحدار. وأثناء التقييم تحجب الشبكة العامة ومستودعات المصدر الأصلية كي لا يجد النموذج حلولاً جاهزة.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.