Ai2 تُطلق Olmo-core 3 لتدريب نماذج MoE القابلة للتوسع حتى تريليون معامل
أطلقت Ai2 نظامها المفتوح Olmo-core 3، الذي يرفع تدريب نماذج MoE إلى تريليون معامل. في أحد الاختبارات المرجعية، زاد عدد الخبراء من 8 إلى 128، بينما انخفضت كفاءة التدريب بأقل من 5%.
أطلقت Ai2 (Allen Institute for AI) نظام Olmo-core 3 في الأول من أكتوبر. وهو تحديث لإطارها المفتوح مع نظام تدريب MoE (مزيج الخبراء) المُعاد تصميمه. وفقاً لبيان المعهد، تم تصميمه للتوسع حتى تريليون معامل وهو أحد الأنظمة الأساسية لجيل Olmo القادم.
يستخدم نموذج MoE جزءاً فقط لكل بيانات، إلا أن تخزين النموذج بالكامل وإعادة توجيه البيانات إلى الخبراء المناسبين يخلق تكاليف تزداد مع الحجم.
ما الذي يغيّره Olmo-core 3
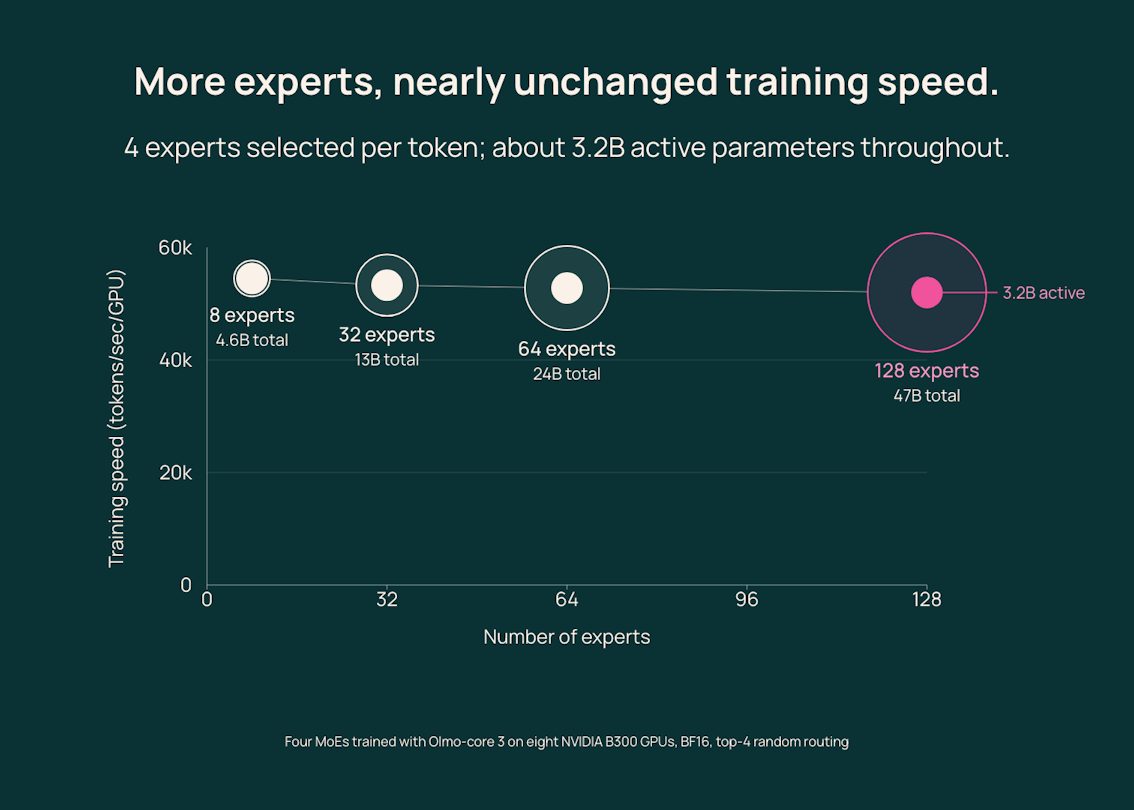
في أحد الاختبارات المرجعية، زاد عدد الخبراء من 8 إلى 128، مع اختيار أربعة خبراء لكل رمز، وحافظ عدد المعاملات النشطة على مستوى حوالي 3,2 مليار لكل رمز. ارتفعت السعة الإجمالية للمعاملات من 4,6 مليار إلى 47 مليار، بينما انخفضت الكفاءة بأقل من 5%.
استخدمت النسخة القديمة التوازي الكامل لتجزئة البيانات (FSDP)، بينما انتقل Olmo-core 3 إلى مخطط التوازي الموزع للبيانات (DDP): يبقى الخبراء على وحدات GPU وتُوجّه البيانات إليهم.
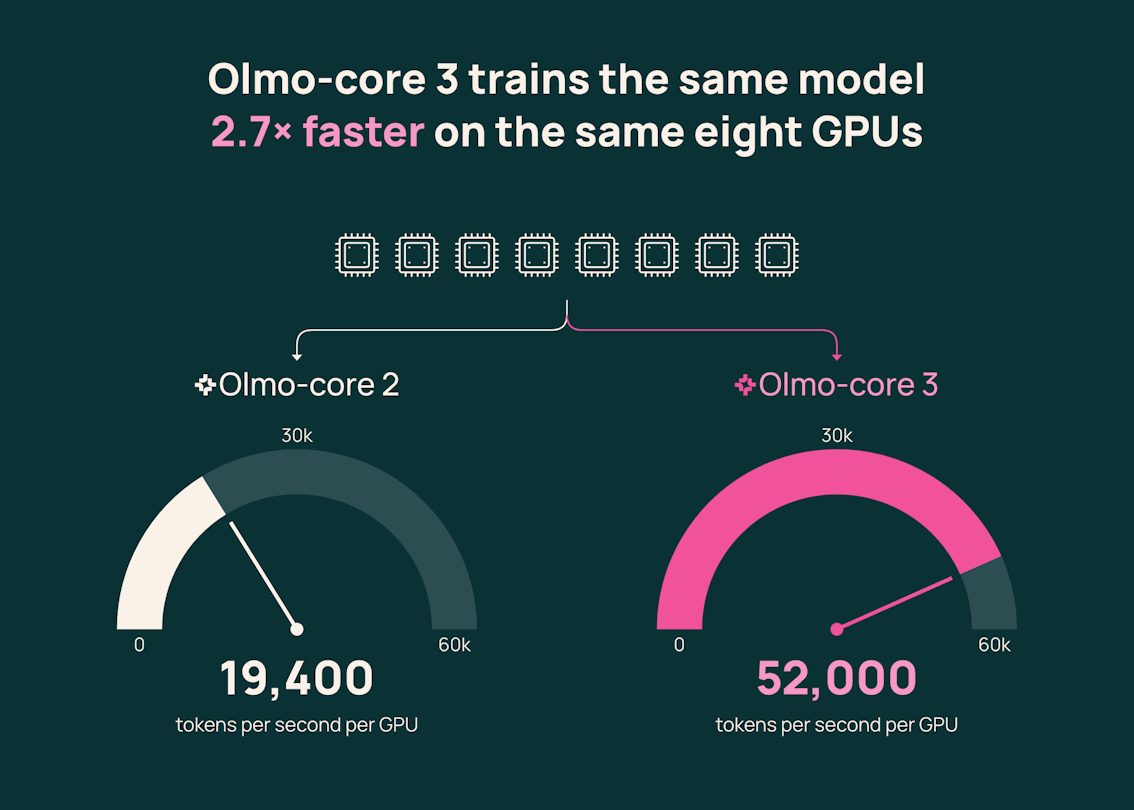
عالج نموذج MoE بـ 47 مليار معامل على ثماني وحدات B300 GPU من NVIDIA 52 000 رمز في الثانية لكل وحدة GPU بالنظام الجديد، مقارنة بـ 19 400 بالنسخة القديمة، أي حوالي 2,7 مرة أكثر.
التوسع حتى تريليون معامل
يقسّم Olmo-core 3 النماذج على الأجهزة باستخدام توازي الخبراء وخطوط الأنابيب مع مُحسِّن موزع. تبقى البيانات الوصفية على وحدات GPU، وتصل البيانات الموجّهة مباشرة إلى مخزن الخبراء المؤقت، بينما يجمع GEMM المجمّع العمليات الحسابية الصغيرة.
يدعم النظام أيضاً MXFP8، وهو تنسيق منخفض الدقة: على أربع وحدات B300 GPU أظهر كفاءة أعلى بنحو 21% مقارنة بـ BF16، وانخفضت الذاكرة النشطة القصوى من 103 GiB إلى 95 GiB.
اختبرت Ai2 أيضاً نموذجاً بـ 1,2 تريليون معامل على 512 وحدة GPU، حيث كان 58,36 مليار معامل نشطاً لكل رمز؛ وبلغت الكفاءة القصوى 858 TFLOP/s لكل وحدة GPU. قيست الاختبارات أداء النظام بتوجيه عشوائي وليس جودة النموذج؛ ووصل تجريب DeepEP v2 إلى 2,38 تريليون معامل في اختبار قصير.
بنية تحتية مفتوحة
سيستخدم معمارية Olmo MoE من الجيل القادم ويُفترض أن يصبح أقوى نموذج Olmo، مدرّب على أكبر مجموعة بيانات وبأطول سياق. النظام مفتوح بالكامل: يمكن للباحثين تدريب نماذج MoE الخاصة بهم عليه وتكييفها مع أجهزة أخرى؛ التقرير التقني والشيفرة والعرض التفاعلي متاحة بالفعل.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.