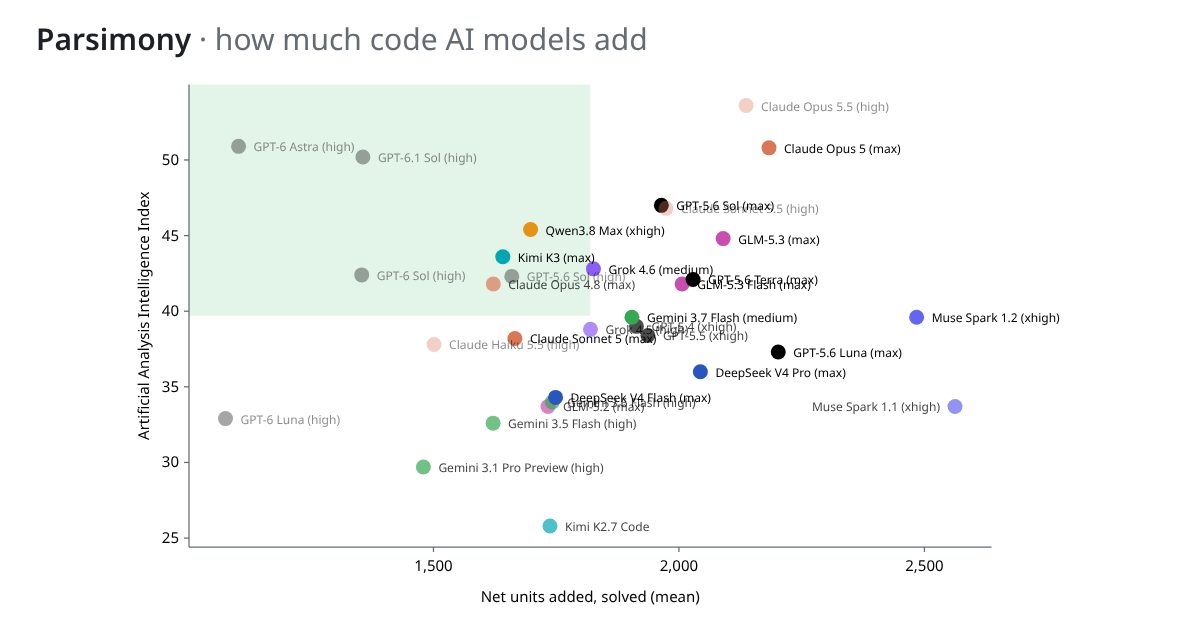
معيار Parsimony الجديد يقيّم وكلاء ترميز الذكاء الاصطناعي بناءً على الكود المضاف
Parsimony هو معيار يقيس مقدار الكود الذي يضيفه وكلاء ترميز الذكاء الاصطناعي عند حل المشكلات. يحسب الوحدات النحوية وليس الأسطر، يطرح الكود المحذوف، ويرتّب النماذج حسب متوسط الوحدات النظيفة المضافة على SWE-bench Verified.
معايير ترميز الذكاء الاصطناعي الحالية تقيس نسبة الحل والتكلفة، لكنها لا تعاقب الكود الزائد، مما قد يعقّد العمل مع قاعدة الكود بمرور الوقت. Parsimony، معيار جديد، يتبع منهجاً مختلفاً: يقيس مقدار الكود الذي تضيفه نماذج الذكاء الاصطناعي عند حل المشكلات.
كيف يعمل Parsimony
يأخذ Parsimony التصحيحات التي تنشرها المعايير بالفعل، ويحسب وحدات الترميز، أي العناصر النحوية مثل التعليمات والاستدعاءات والمقارنات والأسماء والحرفية. لا تُحسب الأسطر، لذا لن يُكافأ ضغط الكود في أسطر أقل. يُطرح الكود المحذوف، مما يعطي صيغة بسيطة: الوحدات النظيفة تساوي المضاف ناقص المحذوف. يُطبَّق كل تصحيح على كود المشكلة ويُحلَّل كلا إصدارَي كل ملف معدَّل؛ لا يُنفَّذ شيء. تُستبعد الاختبارات والتوثيق والملفات المولَّدة، ويُقاس Python فقط. تأتي النتائج الناجحة والفاشلة من نتائج SWE-bench المنشورة، ولا تُعاد تشغيل الاختبارات.
كيف تُقرأ لوحة المتصدرين
تُرتَّب النماذج حسب متوسط الوحدات النظيفة المضافة في المشكلات التي حلتها، بدءاً من الأدنى. يشمل مخطط «Net units added (mean)» أيضاً المحاولات الفاشلة. يأتي عمود «Solved» من SWE-bench Verified، بينما يُظهر «Measured» عدد المحاولات المحلولة التي كان يمكن قياسها. يظهر Artificial Analysis Intelligence Index كدرجة خارجية، مقارنةً بالنموذج وقوة الاستدلال، لكنه لا يؤثر على الترتيب. شغّل المؤلف السجلات الموثقة على لوحة المعلومات لأول 3 إلى 10 مشكلات DeepSWE بلغة Python، باستخدام pi لنماذج OpenAI وClaude Code لنماذج Anthropic، وقيّم كل مشكلة باختباراتها الخاصة؛ وهي غير متحقق منها أو مرتّبة. اجتاز GPT-5.6 Sol كلا المسارين، وأضاف تشغيل المؤلف 0,88 ضعف كود التشغيل المنشور.
القيود والتحذيرات
يشير المشروع إلى أن الأصغر ليس الأفضل دائماً: الوحدات تقيس الحجم وليس قابلية القراءة أو التصميم. النماذج التي تكتب كوداً أكثر تحل مشكلات أكثر عادةً، بارتباطات Spearman من 0,33 إلى 0,60 على لوحات تضم 26 نموذجاً أو أكثر. يستخدم كل نموذج الوكيل نفسه، mini-SWE-agent، لكن الوكيل يؤثر مع ذلك على مقدار الكود المكتوب.
إضافة معيارك الخاص
يمكن للقارئ الذي لديه أرقام حجم الكود من معيار آخر تنزيل ملف JSON نموذجي، وملء نتائجه الخاصة، وفتحه للحصول على نفس المخطط والجدول. يبقى الملف في المتصفح.
المصادر: parsimony.lasu.dev
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.