ضريبة Tokenizer: لماذا يدفع المستخدمون غير الناطقين بالإنجليزية المزيد من الرموز
تقول دراسة من ائتلاف الإنصاف اللغوي في أبحاث الذكاء الاصطناعي إن نماذج الذكاء الاصطناعي قد تستخدم عددًا أكبر بكثير من الرموز لبعض اللغات، مما يرفع التكاليف وزمن الاستجابة وحدود السياق للمستخدمين غير الناطقين بالإنجليزية.
خلصت دراسة نُشرت الشهر الماضي وأجراها ائتلاف الإنصاف اللغوي في أبحاث الذكاء الاصطناعي إلى أن نماذج الذكاء الاصطناعي قد تحتاج إلى عدد أكبر بكثير من الرموز في بعض اللغات مقارنة بلغات أخرى، وهو ما يسميه الباحثون ضريبة ترميز خفية. ويمكن أن يجعل ذلك الذكاء الاصطناعي أكثر تكلفة بالنسبة إلى من يستخدمون لغات أقل انتشارًا، لا سيما حين يكون حضور تلك اللغات على الإنترنت أصغر. والرموز هي وحدات النص أو البيانات التي تعالجها النماذج.
كيف تختلف أعداد الرموز من لغة إلى أخرى
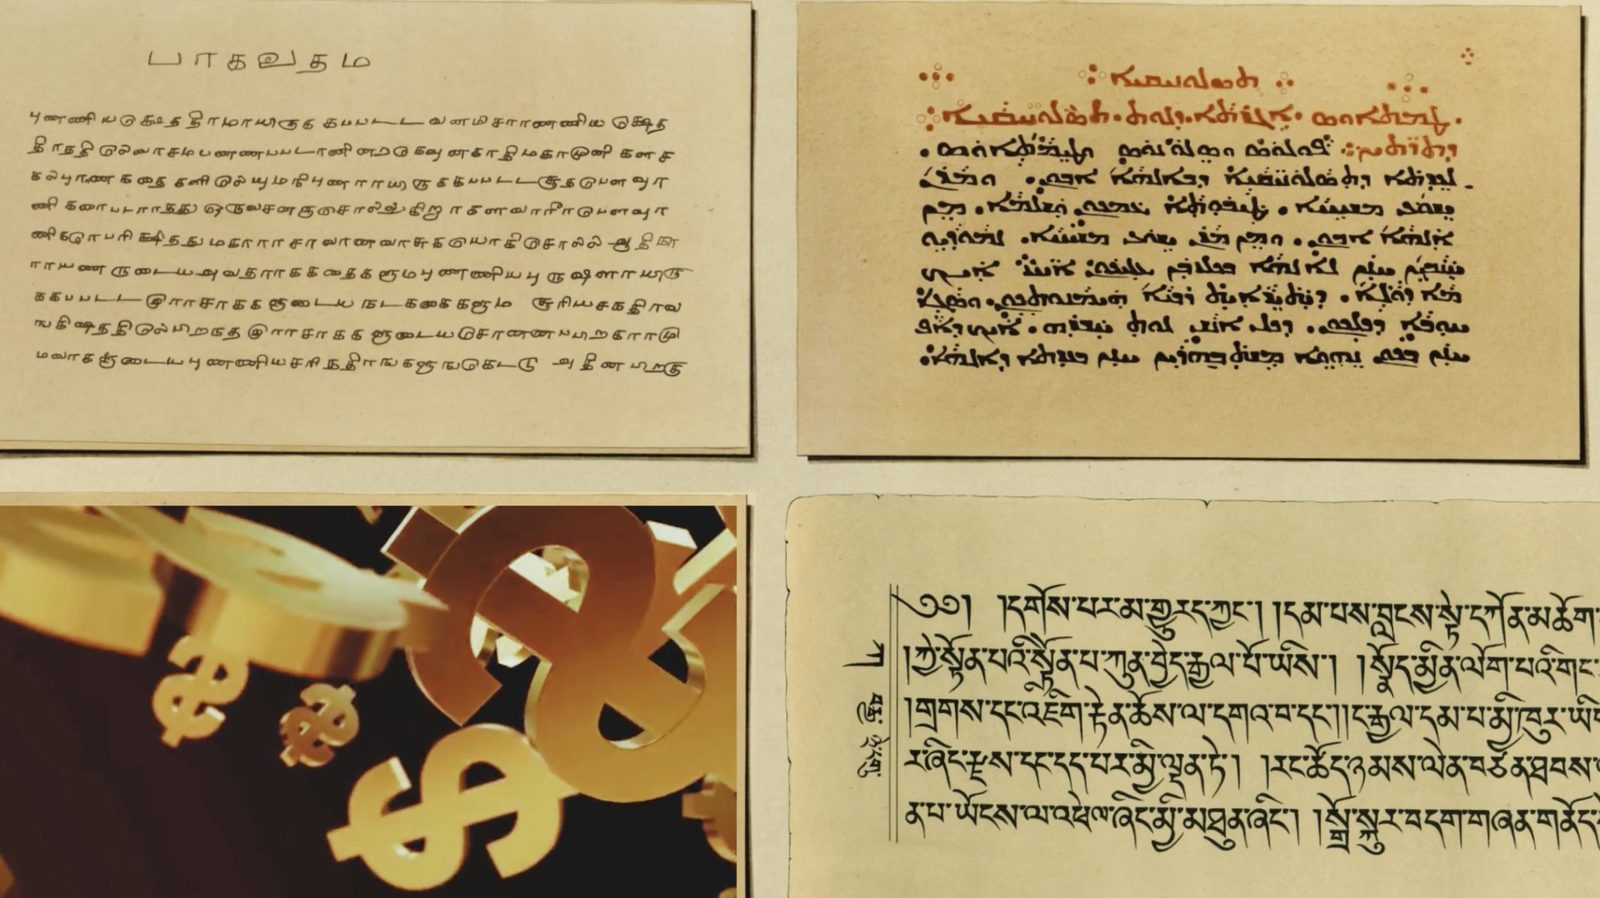
تقسم أدوات الترميز النص الخام أو الصور أو الصوت إلى رموز. وفي أحد الأمثلة جرى تقسيم جملة بالإنجليزية إلى كلمات يمكن التعرف عليها، بينما جرى تقسيم الجملة نفسها بالمالايالامية إلى أجزاء متعددة لكل كلمة، دون مراعاة للحروف متعددة البايتات. وحتى ضمن اللغات العشرين الأكثر شيوعًا على الإنترنت، وجد البحث فجوة في استهلاك الرموز، إذ استخدمت أغلى تلك اللغات ما بين 1.5 و5 أضعاف عدد الرموز التي استخدمتها أرخصها. وعندما وُسّعت المجموعة إلى 200 لغة اتسعت فجوة تكلفة الرموز في أحد النماذج 17 ضعفًا. وقالت الدراسة إن شركة ناشئة في بنغالورو قد تدفع رسومًا إضافية عن كل طلب وإجابة، في حين لا يفعل منافسها في أوستن.
التكلفة ليست العقوبة الوحيدة
وذكرت الدراسة أن ارتفاع عدد الرموز يعني أيضًا زمن استجابة أطول وسعة سياق فعالة أقل. وقال براتيوش تشودري، الشريك المؤسس لشركة Activate AI، أول صندوق لرأس المال الاستثماري في الهند مخصص حصريًا للذكاء الاصطناعي، إن اللغات غير الإنجليزية تترك مساحة أقل للمستندات أو سجل المحادثة وتتطلب عملًا أكبر لتوليد الإجابة. وشبّه المشكلة بمدرّس يحتفظ بأخطاء الطالب السابقة وشروحه، فإذا كان هذا السجل يستهلك نافذة السياق بوتيرة أسرع بكثير في لغة ما، فإن الضرر يمتد إلى جودة الخدمة. وأضافت الدراسة أن هذه العقوبات تقع بأشد وطأة حيث تكون قدرات الحوسبة والاتصال محدودة أصلًا، وأن تفاوت أدوات الترميز يمثل قيدًا على من يستطيع المشاركة في اقتصاد الذكاء الاصطناعي.
الخط والبيانات والتصميم كلها عوامل مؤثرة
وليست ندرة اللغة العامل الوحيد في استهلاك الرموز، فللخط دور كبير. فالأستورية، التي لديها عدد قليل نسبيًا من المتحدثين ولا تتوفر لها بيانات في Common Crawl، تستفيد من ميزة الخط اللاتيني ومن تمثيل لغات رومانسية قريبة مثل الإيطالية. أما اللغات المكتوبة بخطوط قلّما رأتها أدوات الترميز، ومنها البورمية والتبتية والتيفيناغ والخميرية واللاوية وأول تشيكي، فقد كانت في أسوأ وضع على نحو مستمر في جميع النماذج تقريبًا داخل التحليل. وقال ديمانت ريدي، الرئيس التنفيذي لشركة Maya Research، إن كثيرًا من أدوات الترميز لا تزال محسّنة بشكل غير متناسب للإنجليزية وغيرها من اللغات الغنية بالموارد، وإن المشكلة الجذرية هي غياب بيانات رقمية عالية الجودة. وإحدى طرق تحسين معالجة اللغة تكمن في تحسين البيانات الأساسية. وأشار راؤول نانافاتي، الشريك المؤسس والرئيس التنفيذي لشركة Navana.ai، إلى RESPIN، وهي مبادرة تعاونية مع المعهد الهندي للعلوم بتمويل من مؤسسة غيتس، جمعت نصوصًا من متحدثين أصليين لـ38 لهجة إلى جانب كلام مقروء.
سد الفجوة
وحذّر ريدي من أن تحسين بيانات التدريب وحده لا يصلح أداة الترميز. وأسعار الرموز تنخفض بسرعة، ولذلك يفترض أن تصبح التكلفة المباشرة أقل حدة مع الوقت، وأن تؤدي البيانات متعددة اللغات والبيانات الاصطناعية الأفضل إلى تحسين جودة النموذج. غير أن إصلاح فجوة الترميز فعليًا سيظل يتطلب من المختبرات أن تصمم عن قصد أدوات ترميز مستقبلية تتعامل مع هذه اللغات والخطوط على نحو أفضل. وقال تشودري إن كفاءة اللغة ينبغي أن تكون متطلبًا للمنتج إلى جانب الدقة والسرعة والموثوقية. وقال إن المساواة الكاملة قد تكون غير واقعية، لكن التفاوتات الكبيرة المستمرة ينبغي أن تستلزم تفسيرًا وخطة تحسين، ودعا كل مختبر كبير إلى نشر بطاقة تقييم لكل لغة تُظهر تكلفة إنجاز مهام قابلة للمقارنة بنجاح، وإلى الالتزام بتحسينات قابلة للقياس في أسوأ اللغات خدمة لديه.
المصادر: Rest Of World · Techmeme
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.