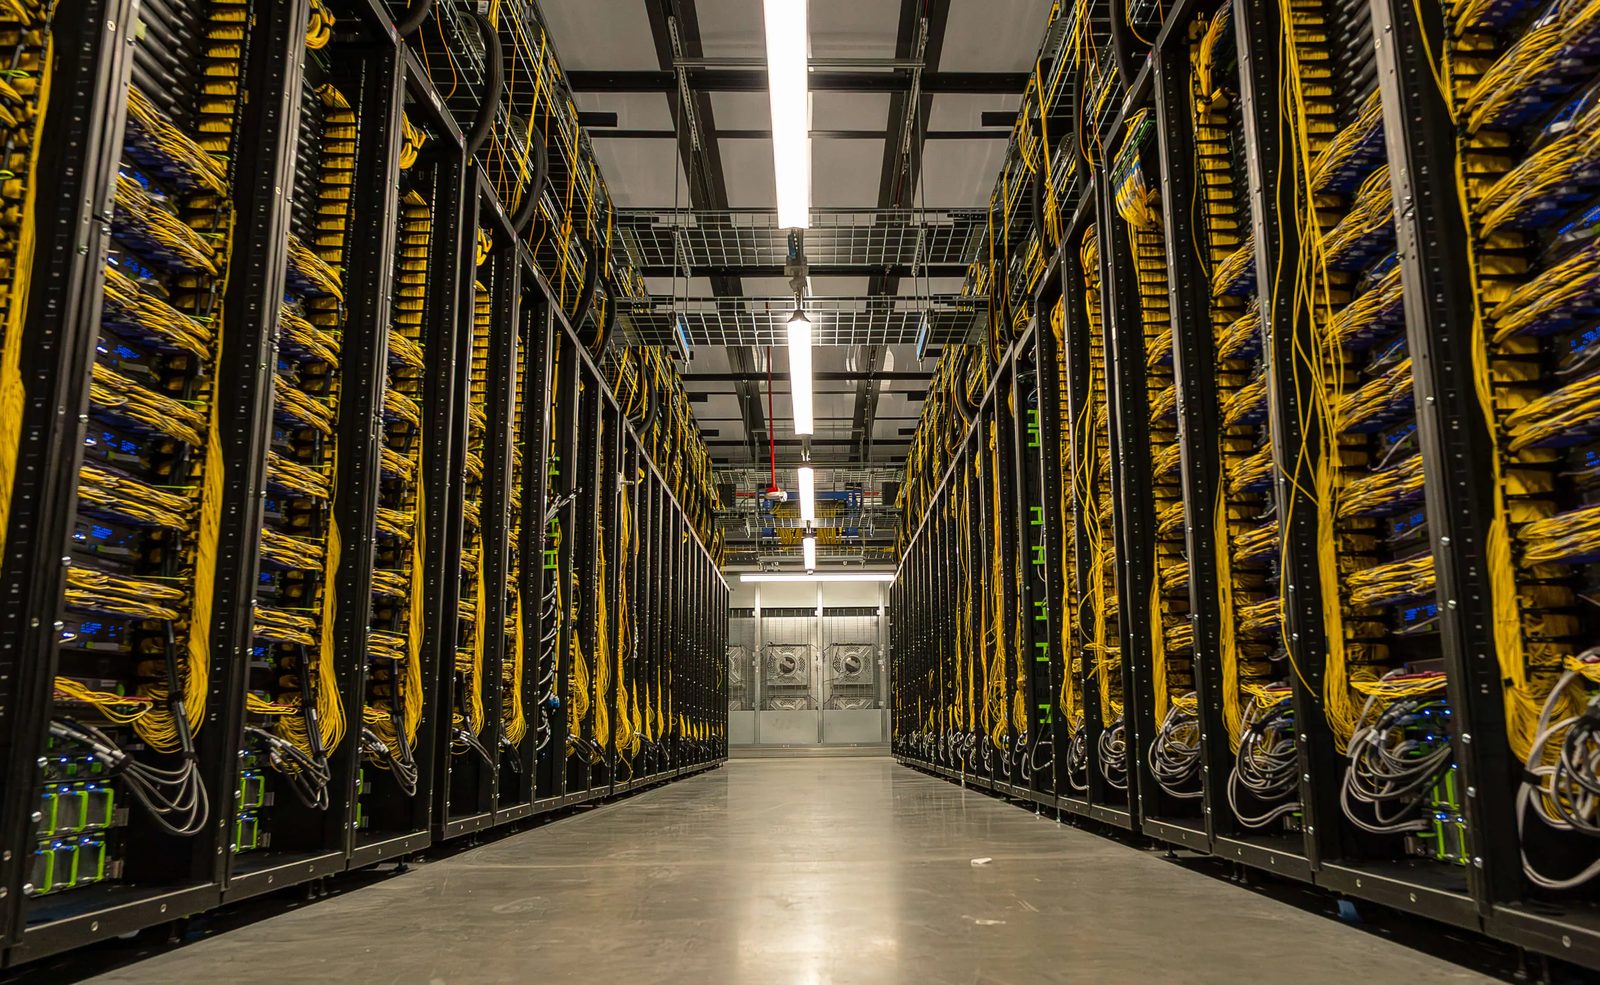
Meta تستخدم وحدات GPU الاحتياطية الخاملة ونقاط التوقف لمواصلة تدريب Prometheus للذكاء الاصطناعي
تقول Meta إن أكثر من 11 في المئة من وحدات GPU في مجموعتها الفائقة Prometheus معطلة أو خاملة كاحتياطية لحماية تدريب الذكاء الاصطناعي. وتستشهد بنقاط التوقف وعمل NVLink وانقطاعات أقل أثناء التوسع نحو مليون مسرّع.
الاحتياطيات تمتص الأعطال
قالت Meta إن أكثر من 11 في المئة من وحدات GPU في مجموعتها الفائقة Prometheus في نيو ألباني بولاية أوهايو معطلة أو خاملة بانتظار استبدال وحدة معطلة. ويشكل مجمع الاحتياط جزءا من تصميم نظام تقول Meta إنه سيصل في النهاية إلى حوالي جيجاواط واحد من السعة ونحو مليون مسرّع، باستخدام أنظمة Nvidia Grace Blackwell للرفوف ولاحقا أنظمة Vera Rubin.
تستخدم المجموعة الحالية أنظمة GB200 وGB300 مع 72 وحدة GPU في كل نطاق NVLink، ولكن يتم استخدام 64 فقط في أي لحظة. وتعمل الثماني الأخرى كاحتياطية ساخنة. وقالت Meta إن هذا مهم لأن وحدة GPU معطلة واحدة كان يمكن أن تُسقط رفا كاملا وتقطع تشغيل التدريب. ومع وجود بديل، يمكن للوحدة البديلة أن تُثبَّت، رغم أن العطل لا يزال يتسبب في انقطاع أقصر.
عندما بدأت Prometheus مرحلتها الأولى، قالت Meta إنها سجلت نحو 1,000 انقطاع يوميا لكل 8,000 وحدة GPU. الانقطاع يعني أن شيئا ما تعطل أو فشل أو انتهت مهلته، ثم تم التراجع بتشغيل التدريب إلى آخر نقطة توقف صالحة معروفة. وقالت Meta إنها بعد نحو عام واحد خفضت الانقطاعات بنسبة 99 في المئة، إلى حوالي 11 انقطاعا يوميا لكل 8,000 وحدة GPU.
نقاط التوقف تحد من التراجع
وصفت Meta أيضا كيف تحدّ من الأعطال داخل مهام التدريب الكبيرة التي تستخدم توازي البيانات، حيث توجد نسخ متعددة من النموذج مقيمة في المجموعة. إذا كان يمكن عزل عطل في نسخة نموذج واحدة متوازية للبيانات، فإن تلك النسخة تنقطع عن العمل بينما تكرر بقية المجموعة الخطوة وتواصل التدريب. ثم يُعاد تشغيل الشريحة المتضررة على مضيفات احتياطية وتعيد المزامنة، مما يحول ما كان يمكن أن يكون توقفا كاملا إلى انخفاض مؤقت في معدل الإنتاجية الإجمالية.
إذا تجاوز العطل نطاق توازي البيانات، تعتمد Meta على نقاط التوقف. قالت الشركة إن بنية نقاط التوقف الموزعة لديها تحفظ حالة النموذج بشكل غير متزامن، بما في ذلك التدرجات وبيانات المُحسِّن، إلى طبقات تخزين متعددة. يتيح ذلك للتشغيل أن يستأنف من حالة محفوظة بدلا من البدء من جديد. ووصفت Meta هذا العمل بأنه ضروري لإبقاء نماذج مثل Muse Spark والأحدث Muse Wonder على المسار الصحيح.
الروابط والطاقة تشكلان الحجم
يتمثل أحد التحديات في جعل شبكات NVLink تتصرف كمسرّع واحد كبير. قالت Meta إن أنظمة H100 وH200 الأقدم كانت تحتوي على ثماني وحدات GPU لكل نطاق NVLink، بينما وسّع Nvidia Blackwell ذلك بتسع مرات. مع أكثر من 600,000 اتصال NVLink، أدى حتى التدهور الهامشي في الإشارة إلى دورات استرداد متكررة. وقالت Meta إنها استخدمت القياس عن بعد المستمر واختبارات الاحتراق التشخيصية L11 لعزل الروابط الضعيفة قبل دخول الأنظمة مرحلة الإنتاج.
كانت الطاقة قضية أخرى. قالت Meta إن تشغيل وإيقاف عشرات الآلاف من وحدات GPU لمهمة تدريب يمكن أن يخلق تحولات كبيرة في الطاقة قد ترهق معدات تزويد الطاقة. وقالت الشركة إنها بإعطاء الأولوية لاستقرار المجموعة وموثوقيتها حققت أكثر من 85 في المئة من الإنتاجية الجيدة للتدريب المسبق وأكثر من 90 في المئة للتعلم المعزز على Muse Wonder. وتتطلع Meta إلى خفض معدل الانقطاع إلى اثنين يوميا لكل 8,000 وحدة GPU، أو حوالي 100,000 ساعة GPU كمتوسط زمن بين الانقطاعات.
المصادر: The Register
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.