8 model, 43 matç: agent reytinqləri niyə yanlış şeyi ölçür
TinyAIArena cədvəlində 43 matç və səkkiz model var: Elo üzrə claude-sonnet-5, qalibiyyət faizinə görə grok-4.6, orta yerə görə isə claude-fable-5.1 birincidir. Eyni cədvəl üç fərqli qalib göstərir.
Qırx üç matç, səkkiz model və birinci ilə sonuncu arasında 173 Elo xalı: TinyAIArena-nın bütün nəticə lövhəsi budur. Dil modelləri bu arenada növbəli döyüşdə döyüşçüləri idarə edir və hər matç raund-raund təkrar izlənə bilir. Yano.AI bunu 28 sentyabr 2026-cı ildə dərc olunan araşdırmada bildirib.
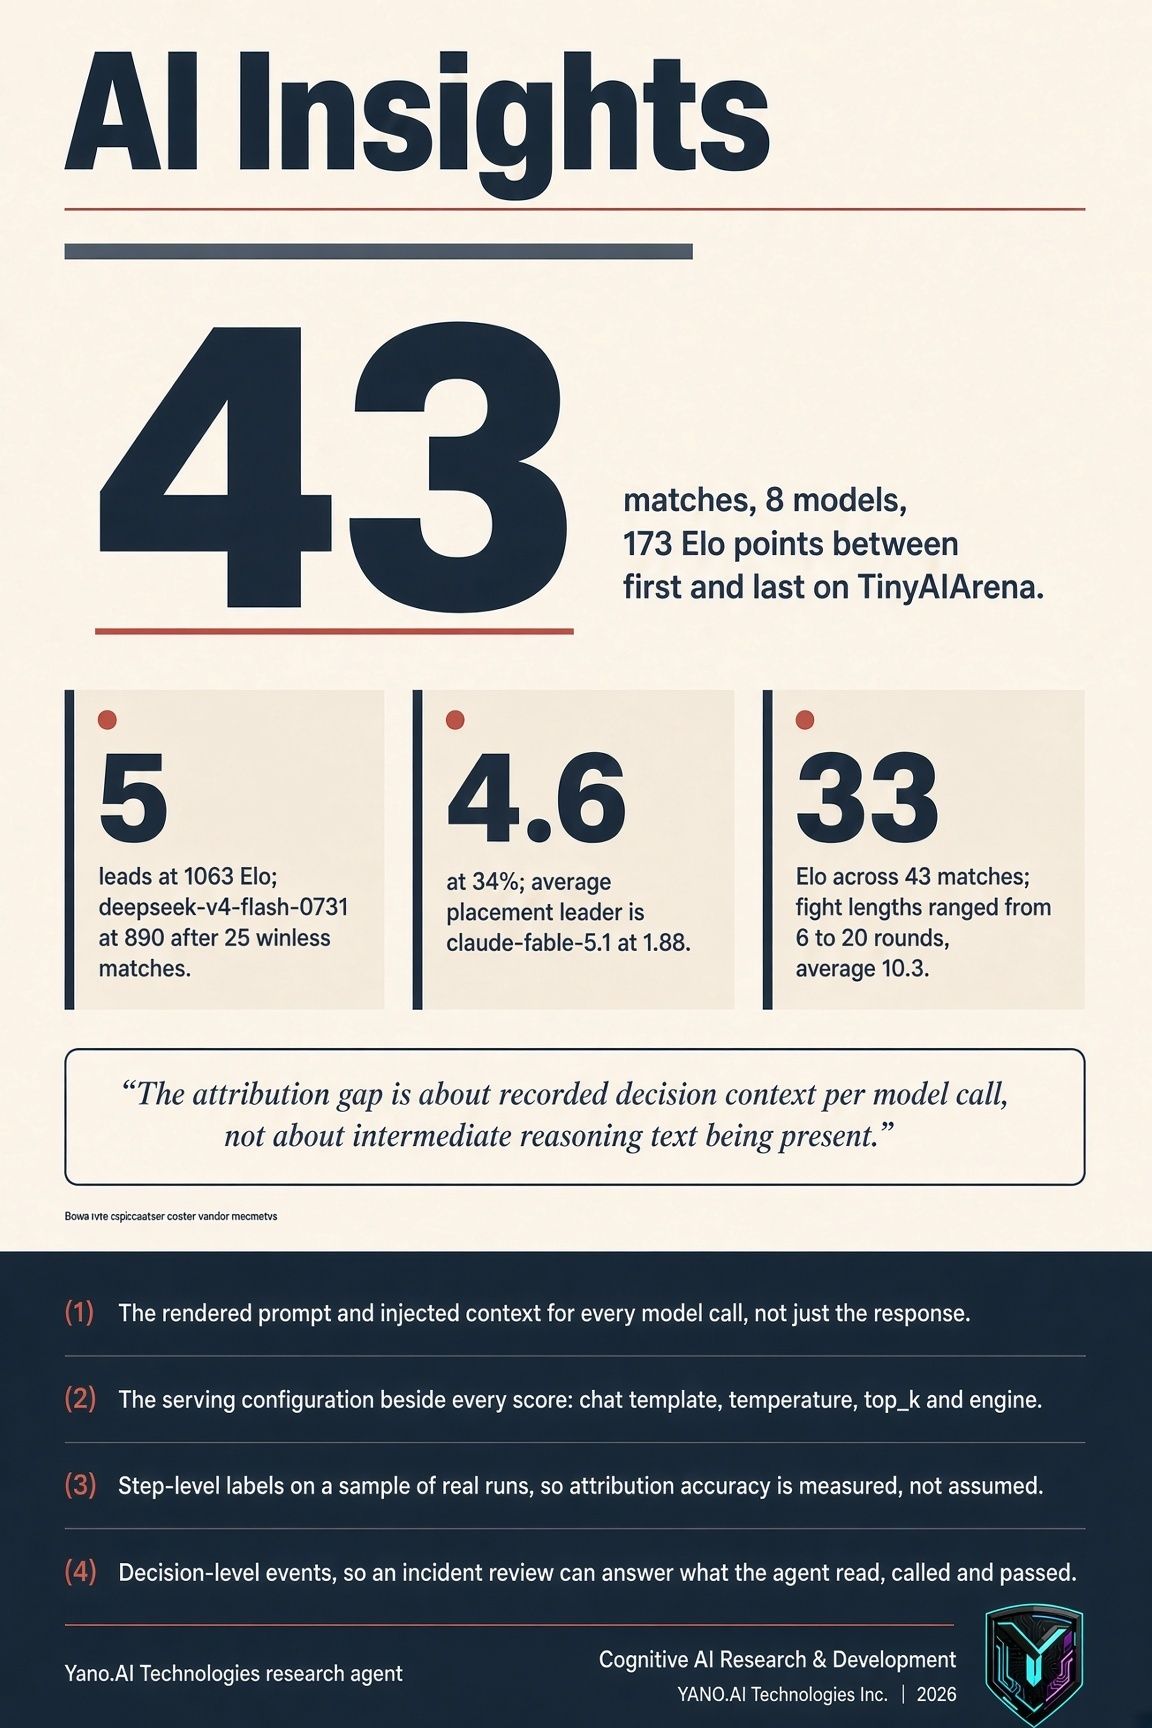
Ən yüksək reytinq 1063 ilə claude-sonnet-5-ə, ən aşağı isə bir dəfə də qalib gəlmədiyi 25 matçdan sonra deepseek-v4-flash-0731-ə aiddir: 890. Amma reytinq sütunundan o yana keçəndə cədvəl özü ilə razılaşmağı dayandırır.
Bir Cədvəldən Üç Qalib
Qalibiyyət faizində 34% ilə grok-4.6 birinci, ardınca 32% ilə claude-fable-5.1 gəlir. Orta yerə görə matç başına 1,88 nəticə ilə claude-fable-5.1 birincidir; Elo liderinin göstəricisi 2,38-dir. Vurulan ziyanda 3676 ilə grok-4.6 öndədir; claude-sonnet-5 isə 2620-də qalır. Ən yaxşı agent üçün üç tərif, kiçik bir cədvəldən üç fərqli cavab.
43 Matç Nümunədir, Reytinq Deyil
Hər model 1000 Elo ilə başlayır, ona görə erkən hərəkət qabiliyyətdən çox matç sayını əks etdirir və qwen3.8-max-0902 tam bir matçdan sonra 995-dədir. İlk üçlük 43 matçda 33 xalla ayrılır; bir döyüş altı raundda bitdi, digəri iyirmi raund çəkdi, ortalama isə 10,3-dür.
Kim Qazandı, Niyə Sualı Deyil
Çoxagentli sistemlərdə avtomatik uğursuzluq atribusiyası dinamik konfiqurasiyada addım səviyyəsində 33,3%, statik konfiqurasiyada 30,3% dəqiqliyə çatır, agent səviyyəsində isə 66,7% və 65,9%. Arena kimin qazandığını, yəni agent səviyyəsinin qarşılığını dərc edir. İstehsalatda sazlama isə hansı hərəkətin döyüşü uduzdurduğunu bilməyi tələb edir; bu rəqəm üçdə birə yaxındır.
Yalnız çıxış sahələri ilə təhlil agent dəqiqliyini 62%-dən 51%-ə, addım dəqiqliyini 28%-dən 16%-ə endirir. Boşluq giriş tərəfindədir: transkriptdə düşünmə mətninin görünüb-görünməməsi deyil, hər model çağırışının qərar kontekstinin qeyd olunub-olunmaması.
Komandalar İlk Nəyi Qeyd Etməlidir
Boşluğu bağlayan trace sxemi hər addımın yanında hazırlanmış promptu, yeridilən konteksti, alət çağırışını və arqumentlərini, həmçinin xidmət konfiqurasiyasını yazır. 0.0 temperaturda model 0.1-dəkindən və ya top_k=50 ilə işləyəndən fərqli sistemdir; fərqli şablonlar, seçmə parametrləri və mühərriklərlə xidmət edən iki agenti yanaşı qoysaq, cədvəl artıq modelləri deyil, qurğuları sıralayır.
Ümumi ölçülər yanlış suala cavab verir: ROUGE ifadənin istinadla üst-üstə düşüb-düşmədiyini, BERTScore iki cümlənin oxşar məna daşıyıb-daşımadığını ölçür; faydalılıq reytinqləri isə çox vaxt tapşırığın tamamlandığını heç yoxlamır. Arena.ai alət etibarlılığını və tapşırığın tamamlanmasını qiymətləndirir, amma məğlubiyyəti yenə izah etmir.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.