Context Language Models: konteksti özləri idarə edən modellər
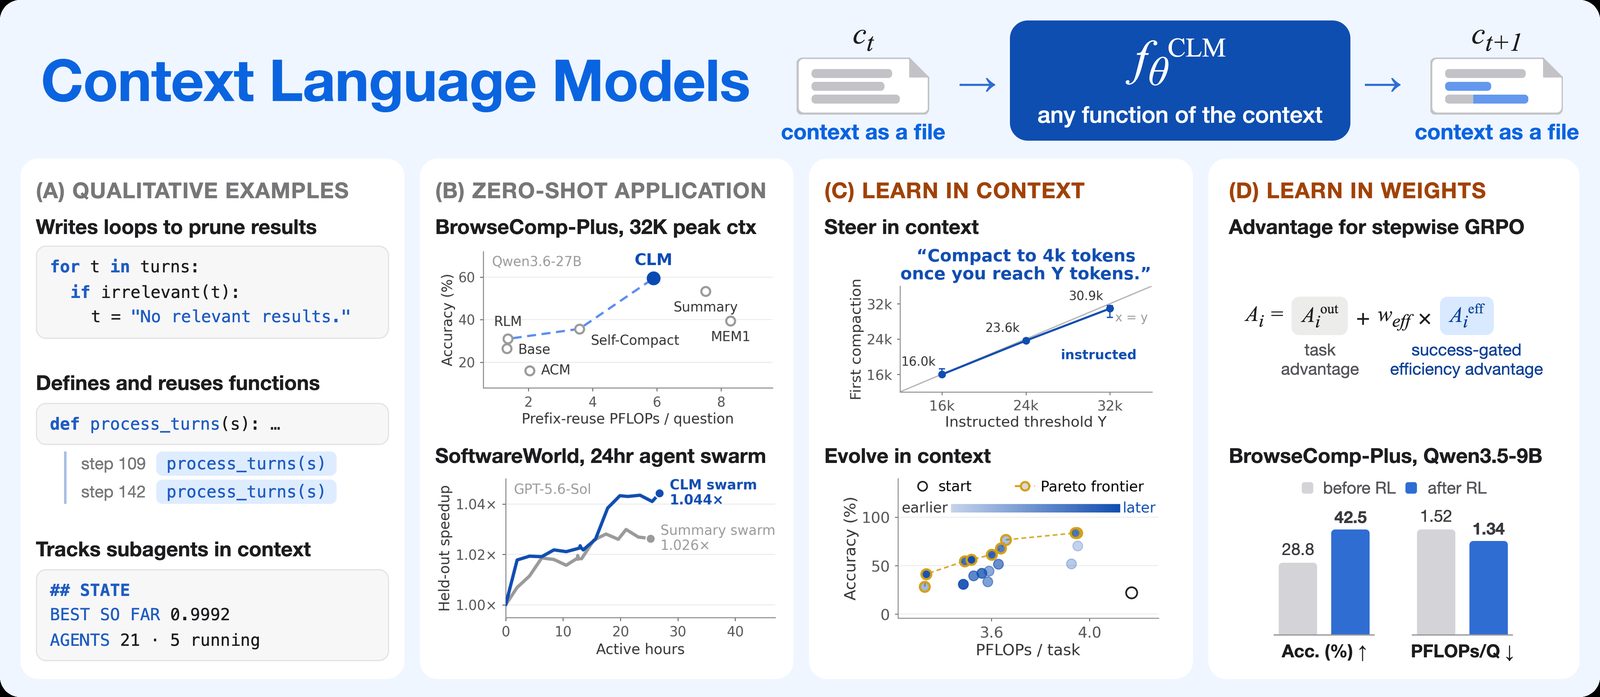
Vaşinqton Universiteti, MIT və Meta tədqiqatçıları Context Language Models (CLM)-i təqdim edib: modellər konteksti fayl kimi saxlayır və özləri redaktə edir. BrowseComp-Plus-da dəqiqlik 11,4% artıb, xərc isə 21,5% azalıb.
Vaşinqton Universiteti, MIT və Meta tədqiqatçıları öz kontekstini idarə edən dil modelləri olan Context Language Models (CLM)-i təqdim edib. Məqalə 29 sentyabrda arXiv-də dərc olunub.
İndiyədək konteksti xarici mexanizmlər idarə edirdi: əl ilə qurulmuş sistemlər və ya məhdud alətlər. CLM-də bu iş modelin özünə tapşırılır.
Kontekst fayl kimi
CLM-də kontekst fayl kimi saxlanılır. Model ona sərbəst dəyişikliklər edə bilər: ya yeni tokenlər əlavə edir, ya da Bash köməyi ilə istənilən hissəni redaktə edir. Hər dəyişiklik dərhal modelin canlı kontekstində əks olunur.
Kontekst ayrı fayl olduğu üçün bir sistemdə bir neçəsi mövcud ola bilər və yanaşma çoxagentli sistemlərə də şamil olunur. Testlərdə modellər yeni davranışlar da nümayiş etdirdilər: çoxagentli orkestrasiya üçün trekerlər yaratdılar, daxili qeydlər üçün çatın yeni rolunu təqdim etdilər və kontekst idarəsi üçün çoxsaylı funksiyalar təyin etdilər.
Müəlliflərə görə, nəticə "Bitter Lesson" ideyasını təsdiqləyir: azadlıq modelə əl ilə yazılmış qaydalardan daha yaxşı strategiyalar verir.
Nəticələr
CLM əlavə təlim olmadan Qwen3.6-27B və GPT5.6-Sol kimi modellərdə işləyir. Dərin tədqiqat benchmarkı BrowseComp-Plus-da CLM 32K kontekst limiti ilə 59,4% göstərdi: bu, ən güclü baza metodundan 11,4% daha yüksək dəqiqlikdir və FLOPs xərci 21,5% daha aşağıdır.
TerminalBench 2.1-də CLM ən güclü metodun dəqiqliyinə çatdı, lakin 29,5% daha az FLOPs xərclədi. 12 saatlıq EdgeBench-də 59% daha az hesablama xərci ilə 5% daha yüksək bal göstərdi. Aqentlər qrupunun altı bir-birindən asılı repozitoriyada işlədiyi 24 saatlıq tapşırıqda eyni büdcə ilə 65% daha çox sürətlənmə əldə etdi.
Təlim və səmərəlilik
CLM-in davranışı mətn təlimatları ilə də idarə oluna bilər: istifadəçi istədiyi strategiyanı sadəcə təsvir edə bilər. Bacarıqların optimallaşdırılması dövrü kontekst idarəsi təlimatlarını özü yaxşılaşdırır; ContextBench-də dəqiqlik maksimum 35,9 bənd artdı, hesablama xərci isə azaldı.
Onlayn gücləndirilmiş öyrənmənin yeni metodu ilə müəlliflər Qwen3.5-9B modelinin BrowseComp-Plus-dakı nəticəsini 47,6% yaxşılaşdırdı və FLOPs sərfiyyatını 12% azaltdı.
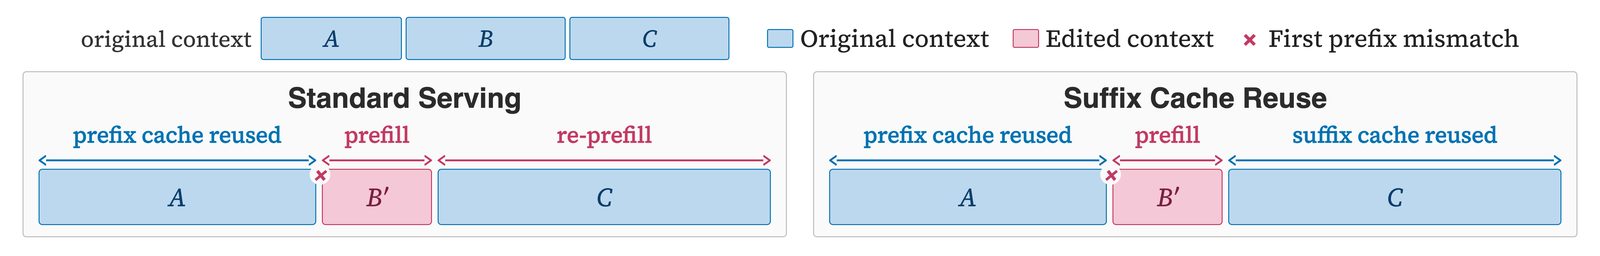
CLM konteksti ortada da redaktə edir, bu da standart xidmət sistemlərini keşi yenidən hesablamağa məcbur edir. Müəlliflər bu problemi həll etmək üçün SGLang üçün Suffix Cache Reuse (SCR) hazırladılar: SCR dəyişiklikdən sonra dəyişməz qalan hissələrin keşini saxlayır və serverin hesablama xərcini standart SGLang ilə müqayisədə 35% azaldır, eyni məhsuldarlığı qoruyaraq.
Kod GitHub-da dərc olunub. Təcrübədə uzunmüddətli agentlər üçün kontekst idarəsi daha çox modelin özündən, daha az əl ilə qurulmuş xarici sistemlərdən asılı olacaq.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.