NVIDIA-nın Məxfi Hesablaması Blackwell-də AI inferensinin 96%-ni saxlayır
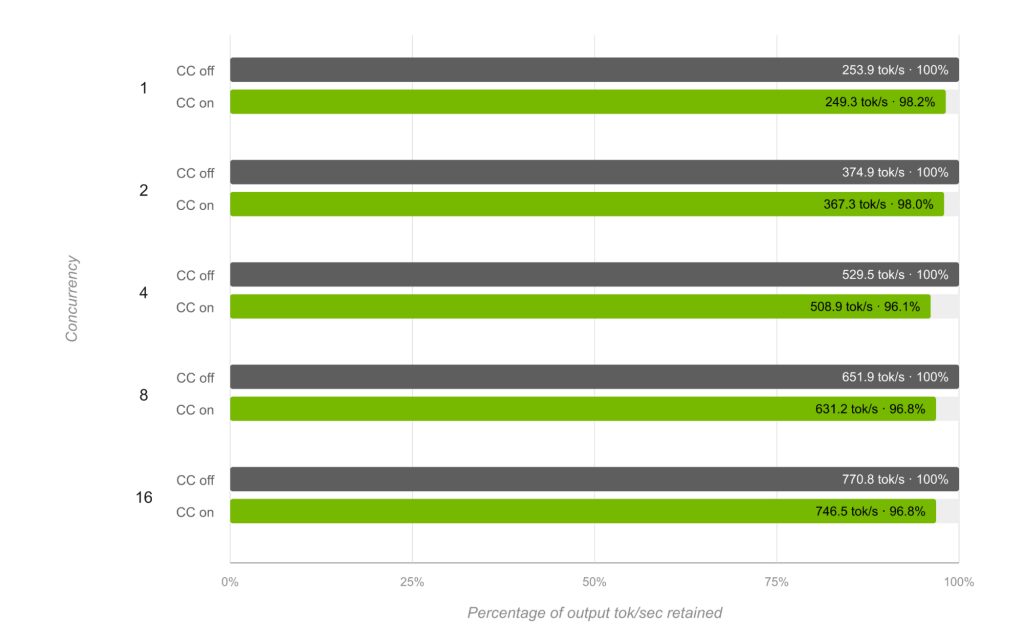
NVIDIA-nın texniki bloquna görə, TensorRT LLM məxfi hesablama aktiv ikən səkkiz Blackwell B200 GPU üzərində çıxış token məhsuldarlığının 96,1-98,2%-ni qoruyub saxlayıb və şirkət hansı varsayımların dəyişdiyini izah edir.
NVIDIA, məxfi hesablamanın (confidential computing) böyük dil modellərinin inferensinə necə təsir etdiyini və TensorRT LLM çərçivəsinin Blackwell GPU-larda şifrələnmiş icra zamanı sürəti necə saxladığını izah edən texniki təhlil dərc edib.
Şifrələnmiş yaddaş iş rejimi fərziyyələrini dəyişir
Məxfi hesablama iş yüklərini yaddaşı şifrələnmiş virtual maşınlarda, məxfi GPU-larda və şifrələnmiş NVLink üzərində icra edir. Lakin təhlükəsiz icra inferens iş rejiminin yaddaş hərəkəti, vaxt ölçməsi, planlaşdırma və çoxsaylı GPU arasında əlaqə barədə fərziyyələrini dəyişir və çərçivə uyğunlaşmasa, bu məhsuldarlığa başa gəlir.
Yükü görünən etmək üçün komanda uzun giriş konteksti, uzadılmış generasiya və aşağı paralellik seçdi: TensorRT LLM-in PyTorch backend-ində DeepSeek-R1-0528-NVFP4, 32K giriş və 1K çıxış tokeni, 1-dən 16-ya qədər eyni vaxtlı sorğu, TP=8 və FP8 KV keşi.
Məhsuldarlığın 96%-i qorunub
Yalnız məxfi hesablama vəziyyəti dəyişdi, qalan bütün parametrlər dəyişməz qaldı. Stend: səkkiz B200 GPU-lu bir NVIDIA DGX B200 sistemi, Intel TDX, CUDA 13.2, NCCL 2.30 və TensorRT LLM 1.3.0rc22.
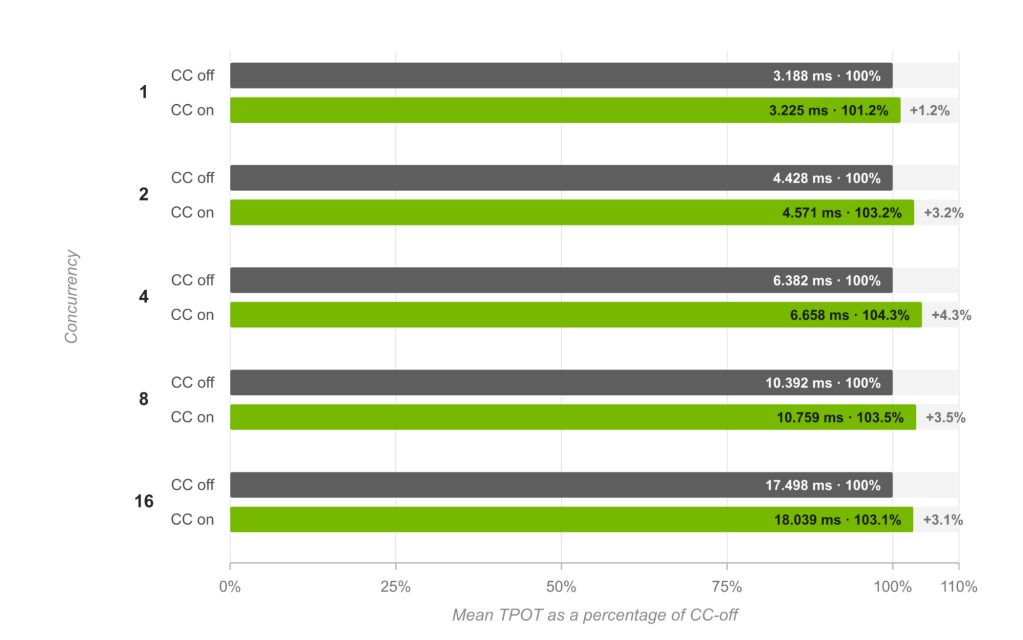
1-dən 16-ya qədər paralellik səviyyələrində məxfi hesablama aktiv ikən çıxış token məhsuldarlığının 96,1-98,2%-i qorundu, bir çıxış tokeninə orta vaxt isə baza səviyyəsindən 1,2-4,3% aralığında qaldı.
Çərçivənin uyğunlaşdığı üç yer
Host-device ötürmələri şifrələnmiş bounce buffer-dən keçir, çünki GPU qorunan CVM yaddaşına birbaşa müraciət edə bilmir. Bu səbəbdən pinned memory asinxron üstünlüyünü itirir və bəzi köçürmələr çağıran thread-i bloklaya bilir; TensorRT LLM yaddaş tipini məxfi hesablamanı nəzərə alaraq seçir və token oxunuşlarını asinxron worker-ə keçirir (PR #11573).
Kernel avtotyuneri taktikaları CUDA events ilə müqayisə edir, amma məxfi hesablama altında vaxt siqnalı qeyri-sabit oldu; indi o, GPU-nun %globaltimer-ından istifadə edir (PR #11657). NVLink SHARP multicast B200-ün məxfi konfiqurasiyalarında mövcud deyil, ona görə çərçivələr NVLS-i aşkarlamalı və uyğun alqoritmlər seçməlidir.
Öz iş yükünüzü ölçün
NVIDIA-nın tövsiyəsi təhlükəsizlik konfiqurasiyası ilə inferens optimallaşdırmasını vahid yerləşdirmə problemi kimi qəbul etməkdir: məxfi hesablamanı aktivləşdirin, attestasiyanı keçin və məhz xidmət göstərəcəyiniz iş yükü ilə nəticələri müqayisə edin.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.