Homelab istifadəçisi 2 RTX 3090 və Optane ilə 2.8T Kimi modelini 3.11 t/s işlədir
Bir homelab istifadəçisinin ikinci nəsil Optane qurğusuna iki RTX 3090 əlavə olunub; Moonshot-un 2.8 trilyon parametrli Kimi K3 modeli 3.11 token/saniyə ilə işləyir, RAM disk generasiyanı təxminən 41% artırıb.
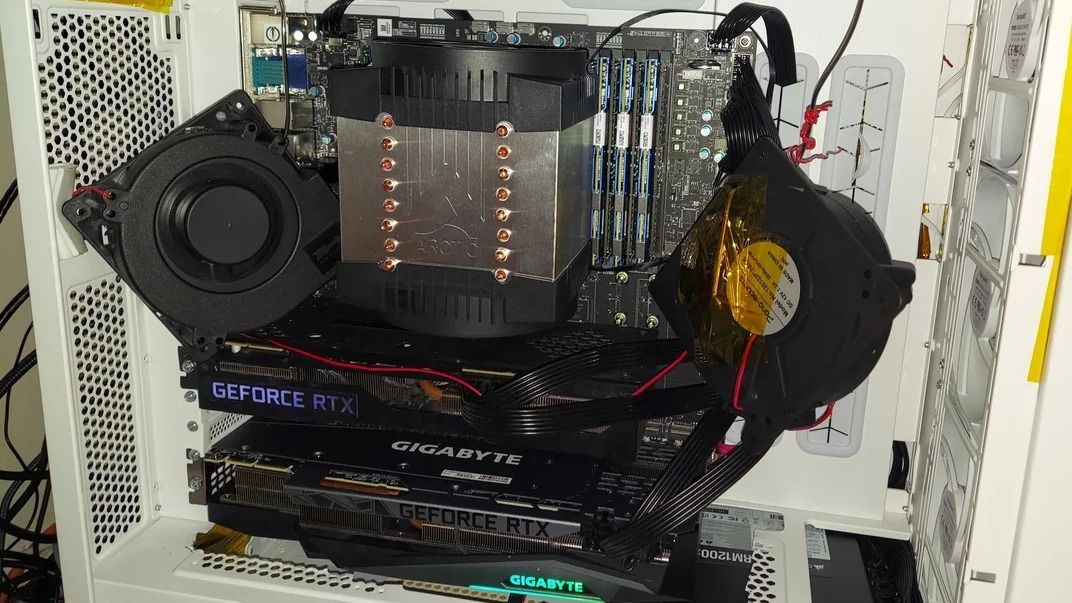
Bir homelab istifadəçisi Reddit-dəki davam postunda ikinci nəsil Optane AI qurğusuna edilən təkmilləşdirmələri təsvir edib; iki RTX 3090 əlavə olunaraq 2.8 trilyon parametrli Moonshot Kimi K3 modeli 3.11 token/saniyə sürətlə işlədilib. Modelin demək olar ki, yarısı RAM diskə köçürüləndə generasiya sürəti təxminən 41%, prompt qiymətləndirməsi isə təxminən 26% artıb. Optane yaddaşı çox qızdığı üçün qurğunun əlavə ventilyatorlara ehtiyacı qalır.
RAM disk ilə və RAM disksiz performans
Hər iki GPU olduqda, amma RAM disk olmadıqda, qurğu generasiya üçün 2.20 token/saniyə, prompt qiymətləndirməsi üçün isə 13.3 token/saniyə sürətlə işləyib. 94 parçadan 45-i, yəni 865 GB modelin 414 GB-ı tmpfs RAM diskdə, qalan hissəsi isə Optane-də olduqda generasiya 3.11 token/saniyəyə, prompt qiymətləndirməsi isə 16.8 token/saniyəyə çatıb. Qurucusunun ölçmələri Optane hissəsində DAX açıq olmaqla llama.cpp istifadə edib.
Sistem yaddaşını çox sürətli performans üçün, disk kimi görünən yarımdaimi bir üsulda ayırmaq entuziastlar üçün yeni deyil; hərçənd bu günlərdə hamının o qədər boş RAM-i yoxdur.
GPU-lar və yaddaş necə istifadə olunur
Hər RTX 3090-da 24 GB VRAM var, yəni cəmi 48 GB; bu, 865 GB model faylının təxminən 5.5%-dir, ona görə də onlar modeli saxlamırlar. Model 896 ekspertli mixture-of-experts tipidir; token başına 16 ekspert seçilir, üstəgəl iki paylaşılan ekspert, 2.8 trilyondan 104 milyard aktiv parametr var. Yönləndirilmiş ekspert tensorları CPU tərəfində, Optane və RAM diskdə qalır, RTX 3090-lar isə attention, dense feed-forward şəbəkə qatı, paylaşılan ekspertlər, digər aktiv-dense komponentlər, KV cache, saxlanılmış söhbət konteksti və GPU hesablama buferlərini idarə edir.
DRAM VRAM-dən daha yavaşdır, amma yenə də yaxşı sürətləndirmə verə bilir; GPU-larla sürət qurucusunun gözlədiyi aralıqda olub, o, ilkin qurğu thread-ində 2 ilə 4 token/saniyə arasında bir yer təxmin etmişdi.
Modelin ölçüsü və kvantizasiya
Bütün 2.8 trilyon parametr 16-bit dəqiqlikdə təxminən 5.6 TB yer tutardı. Moonshot-un öz buraxılışı 4-bit MXFP4 formatından istifadə edir və təxminən 1.56 TB olur, burada istifadə olunan Q2_K faylı isə modeli orta hesabla parametr başına 3 bitdən az olmaqla 865 GB-a qədər kiçildir. Hesabat qeyd edir ki, 865 GB rəqəmi çox güman ki, gibibaytlardadır, amma homelab istifadəçisinin yazdığı GB dəyərlərindən istifadə edir.
Soyutma və gələcək planlar
GPU quraşdırılması qismən korpus dəyişiklikləri gözləyib; bu, GPU-lar və onların soyutması üçün yer açmaq məqsədilə metalın kəsilməsini və enerji blokunun yerinin dəyişdirilməsini tələb edib. Soyutma böyük problem olaraq qalır və Optane DIMM-lər üçün iki 12W blower ventilyator iki 350W sinifli GPU ilə birlikdə belə yerində saxlanılır. Qurucu "customized quantization" daxil olmaqla daha çox optimizasiya görür; bu, vəkil Nick Mermiges tərəfindən istifadə olunan üsullara bənzəyə bilər və sürətin təkbaşına yetərli olmadığını, çıxış keyfiyyətinin də nəzərə alınmalı olduğunu qeyd edir.
Mənbələr: Tom's Hardware
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.