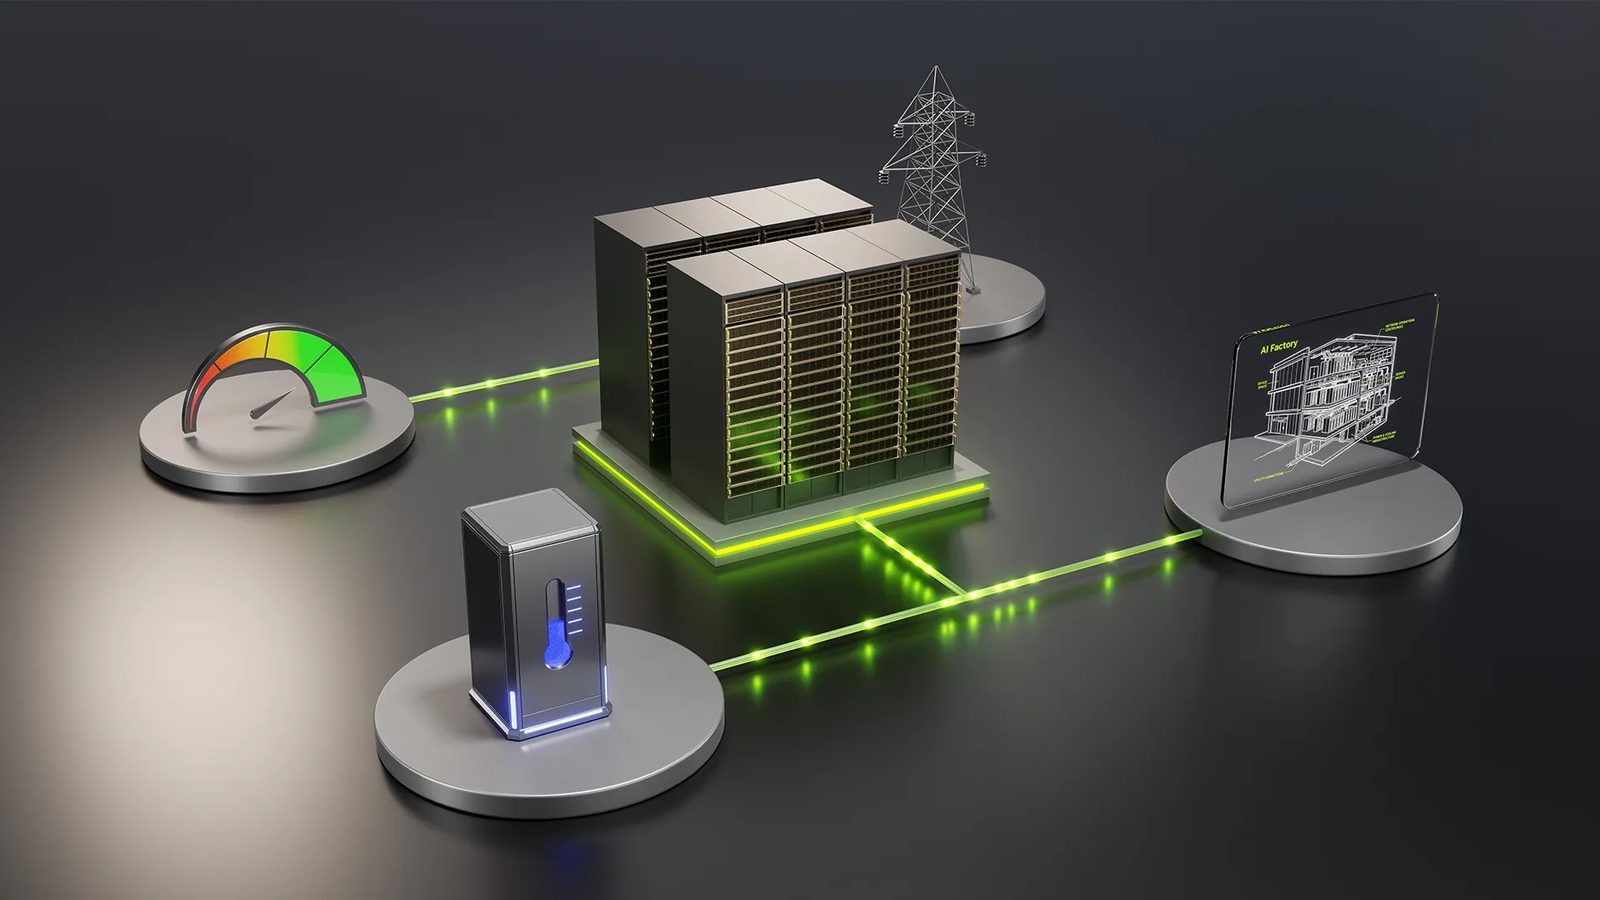
NVIDIA DSX MaxLPS eyni güc büdcəsində AI fabrikinin məhsuldarlığını 49% artırıb
NVIDIA və Nscale-in İslandiyadakı GB300 NVL72 sistemlərində apardığı birgə test eyni 264,4 kVt büdcə ilə 140 yerinə 192 GPU işə saldı; ümumi məhsuldarlıq 49,2% artdı, ayrı-ayrı instansiyaların sürəti isə demək olar ki, dəyişmədi.
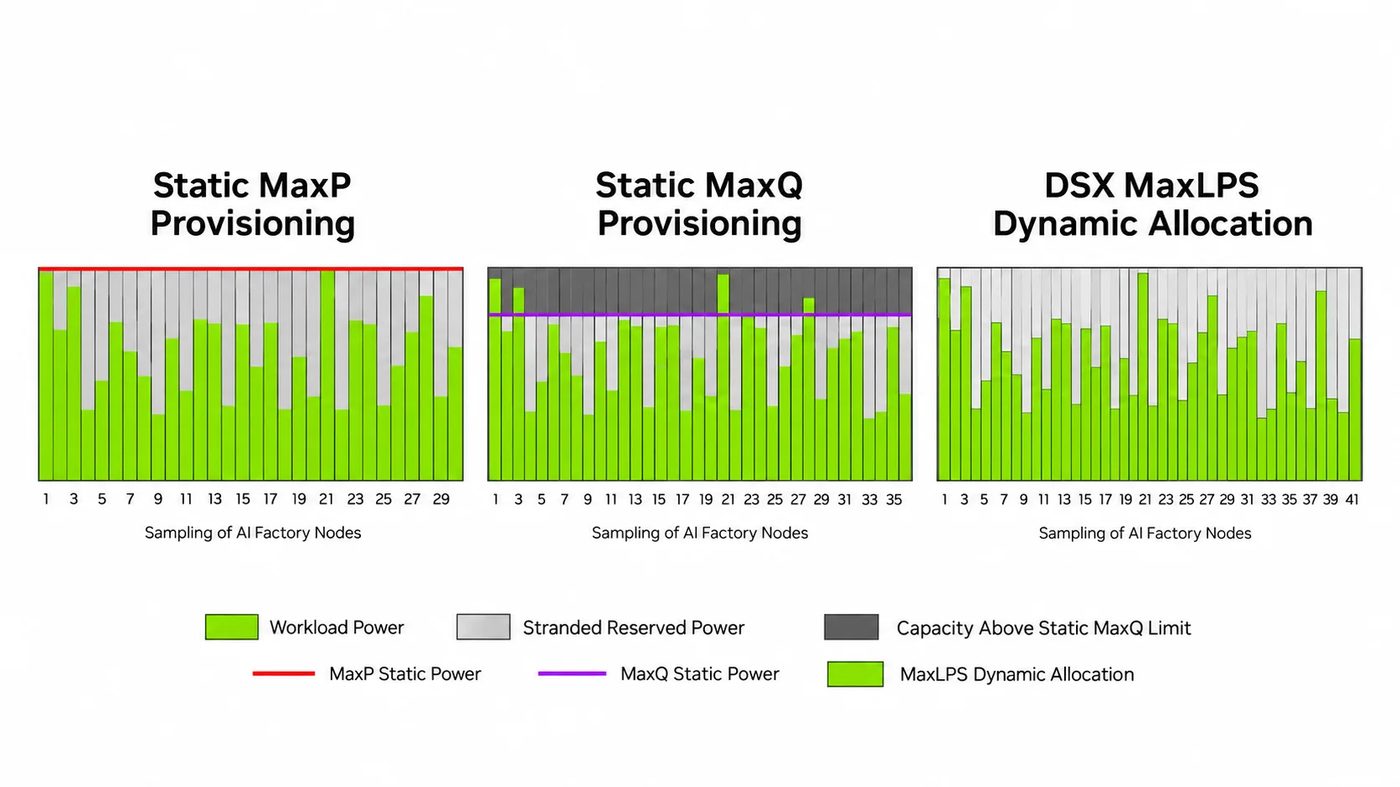
NVIDIA developer bloqunda DSX MaxLPS haqqında texniki icmal dərc edib. Bu qat verilənlər mərkəzində hər node üçün sabit pik güc payı ayırmaq əvəzinə gücü GPU-lar arasında dinamik bölüşdürür. 27 sentyabr 2026-cı il tarixli yazının müəllifləri Sarah McKenney və Harry Petty-dir; onların sözlərinə görə, yanaşma eyni təsdiqlənmiş büdcə daxilində 40%-ə qədər çox GPU yerləşdirməyə imkan verir.
Statik ayrım gücü niyə istifadəsiz qoyur
AI fabriki elektrik məhdudiyyətləri iyerarxiyası içində işləyir: şəbəkə qoşulması və yarımstansiyalardan rəflərə, node-lara və GPU-lara qədər. Operatorlar adətən bütün sürətləndiricilərin eyni anda pik gücə çatmasına kifayət edəcək ehtiyat ayırır, halbuki real iş yükləri belə davranmır: təlimdə hesablamalar rabitə və yoxlama nöqtələri ilə növbələşir, çıxarışda isə prefill, decode, yaddaşla məhdud iş və boş gözləmə arasında keçid olur. Node başına statik ehtiyat ayrıldıqda boş güc digərinə ötürülə bilmir, DSX MaxLPS isə real sərfi izləyir və gücü operatorun siyasətləri çərçivəsində yenidən bölüşdürür.
Qiymətləndirmə necə aparılıb
Nscale proqramı İslandiyadakı Keflavík Verne kampusundaki məlumat mərkəzində yerləşdirib, iş yüklərini isə NVIDIA Blackwell Ultra GPU-lu GB300 NVL72 sistemlərində və FP4 dəqiqliyində Kimi K2.5 ilə işə salıb. Baza konfiqurasiyası 140 GPU, MaxLPS konfiqurasiyası isə eyni 264,4 kVt büdcə ilə 192 GPU istifadə edib.
Ölçmələr nə göstərdi
Normallaşdırılmış ümumi məhsuldarlıq 49,2% artaraq saniyədə 1 084 503 tokendən 1 618 443 tokenə çatıb, ayrılmış vatt başına məhsuldarlıq isə 4,10-dan 6,12 token/s/Vt-ə yüksəlib. Ayrı-ayrı instansiyaların çıxışı demək olar ki, dəyişməyib: yüksək məhsuldarlıqlı instansiyalarda saniyədə 59 220 token, bazadakı 59 153-ə qarşı.
Orta GPU gücü 97,0 kVt-dan 131,8 kVt-a, büdcədən istifadə isə 62,9%-dən 75,2%-ə qalxıb. Median və P75 gecikmə baza səviyyəsinin 5%-i daxilində qalıb, lakin ilk tokenə qədər vaxtın P99 göstəricisi 17% pisləşib.
Operatorlar nəyi yoxlamalıdır
NVIDIA beş mərhələli yol təklif edir: idarəetmə sərhədini və tətbiq oluna bilən limiti müəyyən etmək, statik ayrım şəraitində təmsiledici baza ölçmək, siyasətləri bu bazaya yaxın dəyərlərlə tətbiq etmək, gücü hər mərhələdə sınaqdan keçirərək artırmaq və istehsalat limitlərini yalnız bundan sonra təsdiqləmək.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.