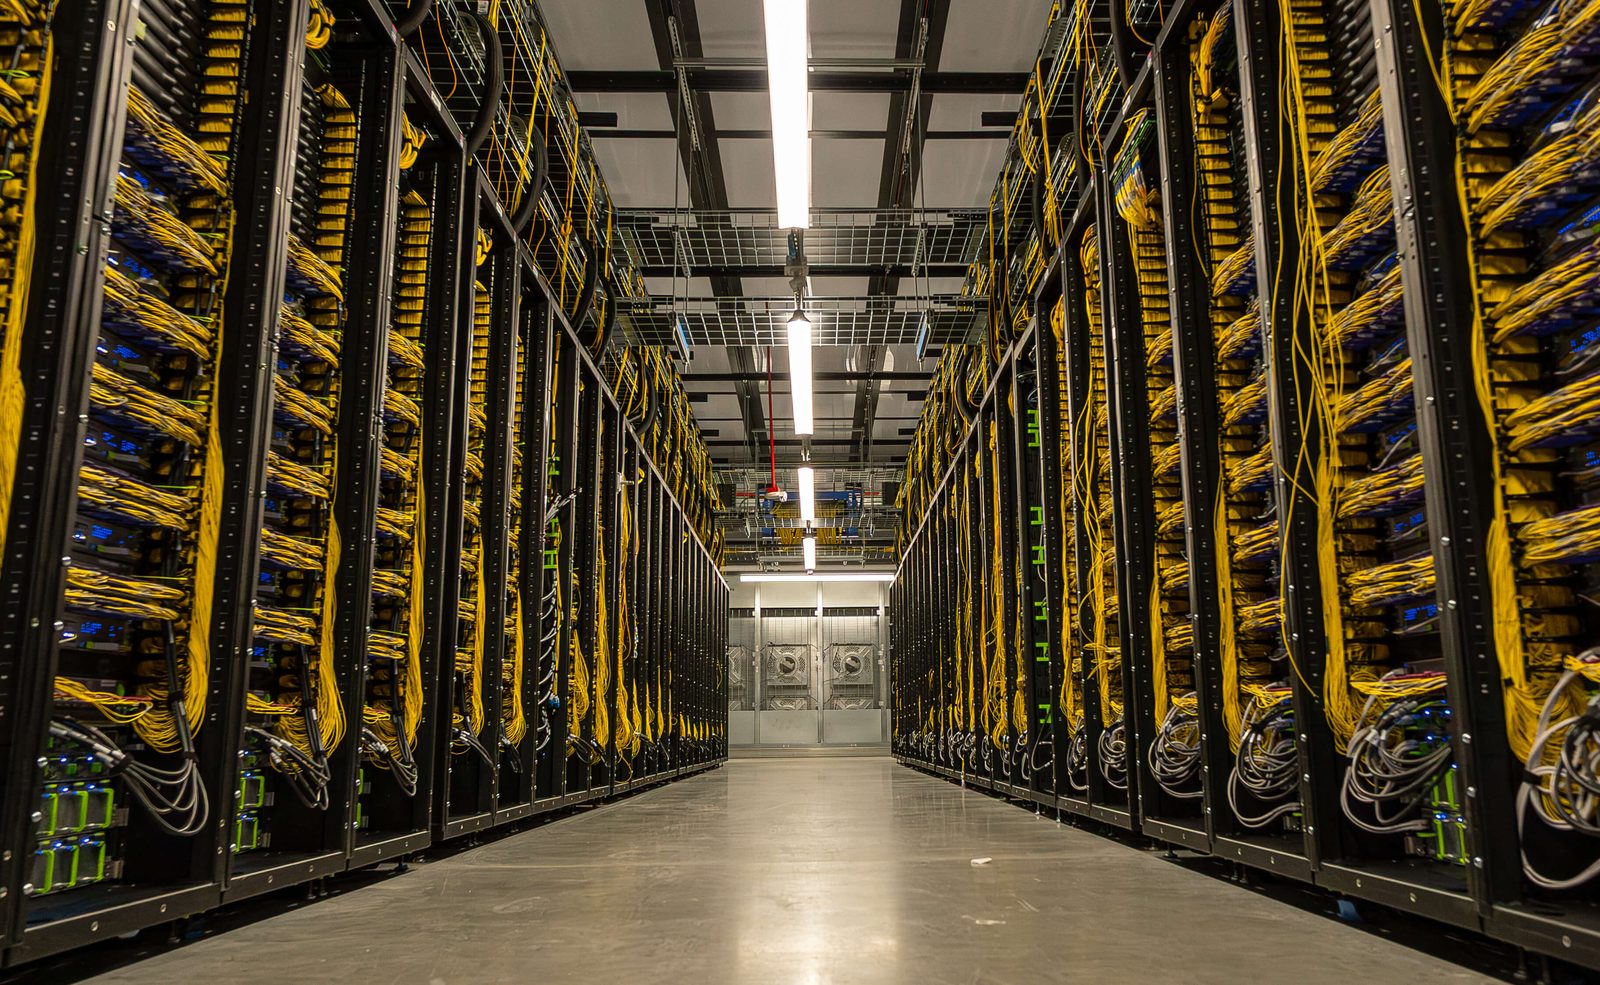
Prometheus-un içi: New Albany-də Meta-nın gigavat miqyaslı AI superklasteri
New Albany, Ohiodakı Prometheus superklasterinin ilk mərhələsi başa çatdı. O, yüz minlərlə GPU üzərində Muse əsas modellər ailəsini təlim edir və təxminən bir milyon GPU-a qədər miqyaslanmağı planlaşdırır.
Meta New Albany, Ohio məlumat mərkəzində gigavat miqyaslı AI superklasteri olan Prometheus-un ilk mərhələsini tamamlayıb. İki il əvvəl adi veb trafik məlumat mərkəzi olan bu obyekt indi Muse ailəsi daxil olmaqla qabaqcıl əsas modellərin təlimini aparır.
Bir milyon GPU miqyası
Prometheus, bir neçə birləşmiş bina üzərində yüz minlərlə GPU-dan ibarətdir və millərlə fiber ilə bir maşın kimi işləmək üçün birləşdirilib. Tam miqyasda təxminən bir milyon paylanmış GPU-dan ibarət olacaq. Sistem hazırda iki NVIDIA platformasından istifadə edir, üçüncüsü isə tezliklə Vera Rubin NVL72 əsasında gələcək. GB200 NVL72 əsaslı Catalina 72 GPU, 13.4 TB HBM3e və 720 pik PFLOPS FP8 hesablama gücü təqdim edir, GB300 əsaslı Clemente isə hər GPU-nun yaddaşını 288 GB-a qaldırır və pik FP4 hesablama gücü bir exaFLOP-u aşır.
Şəbəkə və etibarlılıq
Standart məlumat mərkəzi şəbəkəsindən əlavə, xüsusi Ethernet Back-End şəbəkəsi binalar daxilində və binalar arasında birbaşa GPU-lar arasında əlaqəni təmin edir. Bina səviyyəli şəbəkə strukturları 20,736 GPU-a qədər birləşdirir, Backend Aggregation şəbəkəsi isə bir neçə Pbps regional bant genişliyi ilə 2 km-dən 100 km-dən çox məsafəyə qədər uzanır. Meta öncədən təlim işlərində 85%-dən çox, gücləndirmə öyrənmə işlərində isə 90%-dən çox faydalı ötürücülük bildirir; mikroproqram düzəlişləri kəsilmələr arası orta müddəti təxminən 47,000 GPU saatdan 54,000 GPU saatdan çoxuna qaldırıb.
Sabitlik mühəndisliyi
Kəsilmələr 2025-ci ilin ortalarında gündə hər 8K GPU üzrə təxminən 1,000 hadisə ilə zirvəyə çatdı; bir illik, bir neçə funksiyanı əhatə edən iş bu nəticəni 99% azaltdı. Hədəflənmiş düzəlişlər 600,000-dən çox bağlantıda NVLink siqnal bütövlüyünü, HBM və LPDDR yaddaş xətalarını, keçid sağlamlığını və arxa şəbəkə hadisələrini əhatə etdi. Hər 72 GPU-lu NVL72 sahəsi səkkiz rəf daxili ehtiyat GPU ilə 64 GPU dilimini işlədir, xəta bərpası paralelliyə həssas xəta davamlılığını asinxron paylanmış yoxlama nöqtələri ilə birləşdirir. 30-40% güc dalğalanmaları rəf batareyaları və obyekt enerji anbarı ilə dəstəklənən Dynamo Dimmer məhdudlaşdırma çərçivəsi tərəfindən idarə olunur, hava köməkli və obyekt maye soyutmanın qarışığı isə heterogen parkı dəstəkləyir.
Mənbələr: Engineering at Meta
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.