Ai2 Olmo-core 3-ü trilyon parametrə qədər miqyaslaşdırıla bilən MoE modellərini öyrətmək üçün buraxdı
Ai2 açıq sistem Olmo-core 3-ü buraxdı, ki bu MoE modellərinin öyrədilməsini trilyon parametrə qədər artırır. Bir benchmark-da ekspertlər sahəsi 8-dən 128-ə qədər böyüdü, öyrətmə tutumu isə 5%-dən azalmaqla azaldıldı.
Ai2 (Allen Institute for AI) 1 oktyabrda Olmo-core 3-ü buraxdı. Bu onun yenidən qurulmuş MoE (ekspertlərin qarışığı) öyrətmə sistemi ilə açıq çərçivəsinin yenilənməsidir. İnstitutun elanına görə, o, trilyon parametrə qədər miqyaslaşdırmaq üçün nəzərdə tutulub və növbəti nəsil Olmo-nun əsas sistemlərindən biridir.
MoE modeli hər məlumat üçün yalnız bir hissə istifadə edir, lakin bütün modelin saxlanması və məlumatların düzgün ekspertlərə yönləndirilməsi ölçü ilə birlikdə böyüyən xərclər yaradır.
Olmo-core 3 nəyi dəyişir
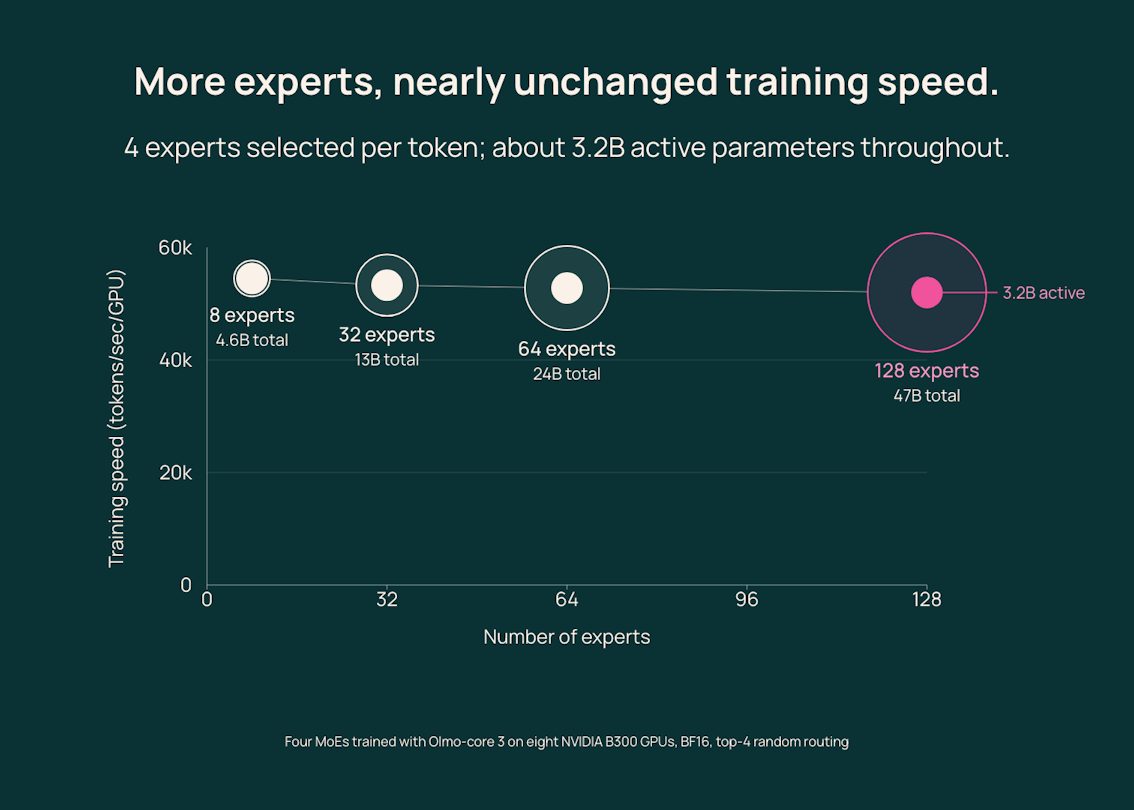
Bir benchmark-da ekspertlər sahəsi 8-dən 128-ə qədər böyüdü, hər token-də yenidən dörd ekspert seçildi, aktiv parametrlərin sayı token-də təxminən 3,2 milyard səviyyəsində qaldı. Parametrlərin ümumi tutumu 4,6 milyarddan 47 milyarda qədər böyüdü, tutumu isə 5%-dən azalmaqla azaldıldı.
Köhnə versiya tam paylanmış məlumat paralellizmindən (FSDP) istifadə edirdi, Olmo-core 3 isə paylanmış məlumat paralellizminin (DDP) sxeminə keçdi: ekspertlər GPU-lərdə qalır, məlumatlar onlara yönəlir.
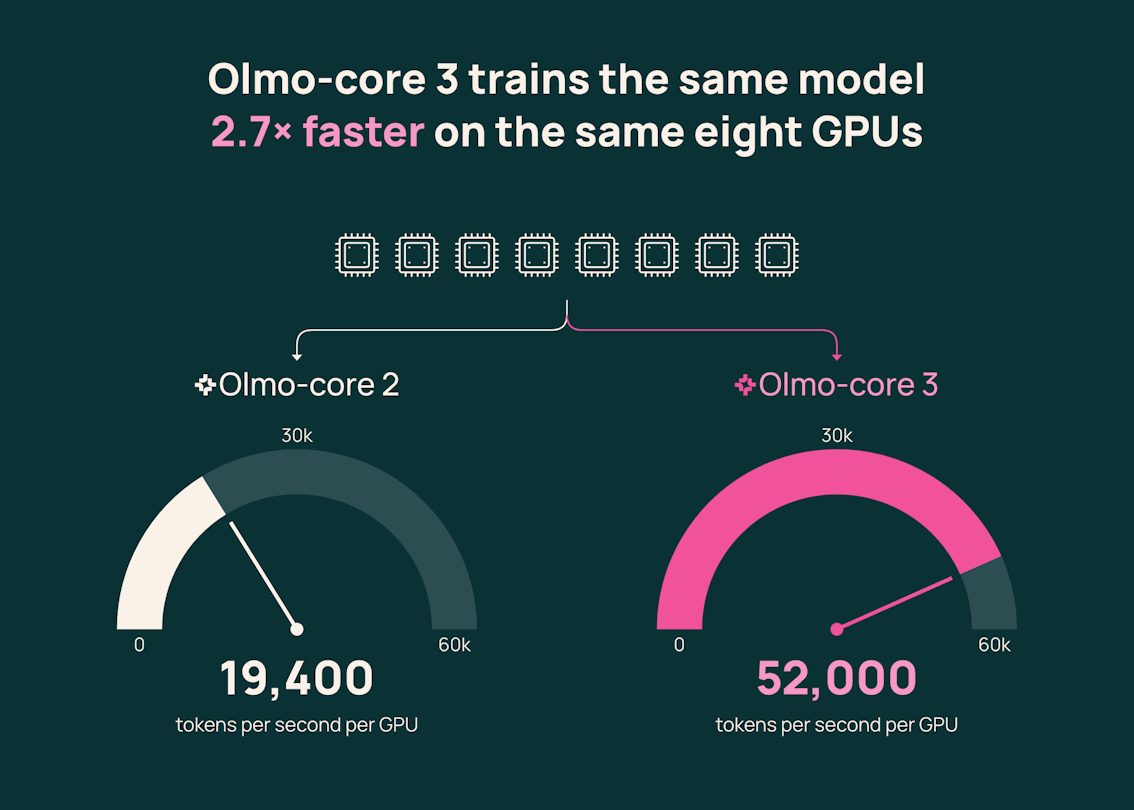
NVIDIA-nın səkkiz B300 GPU-sında 47 milyard parametrə malik MoE modeli yeni sistemlə bir GPU-də saniyədə 52 000 token emal etdi, köhnə versiyayla isə 19 400, yəni təxminən 2,7 dəfə daha çox.
Trilyon parametrə qədər miqyaslaşdırma
Olmo-core 3 modelləri aparat üzərində ekspertlərin və pipeline paralellizmi ilə və paylanmış optimizer ilə paylayır. Meta məlumatlar GPU-lərdə qalır, marşrutlaşdırılmış məlumatlar birbaşa ekspertin buferinə düşür, qruplaşdırılmış GEMM isə kiçik hesablamaları birləşdirir.
Sistem həmçinin aşağı dəqiqlik formatı olan MXFP8-i dəstəkləyir: dörd B300 GPU-da BF16 ilə müqayisədə təxminən 21% daha çox tutum göstərdi, pik aktiv yaddaş isə 103 GiB-dən 95 GiB-ə qədər düşdü.
Ai2 həmçinin 512 GPU-da 1,2 trilyon parametrə malik modeli test etdi, orada bir token-də 58,36 milyard parametr aktiv idi; maksimum tutum bir GPU-də 858 TFLOP/s idi. Testlər təsadüfi marşrutlaşdırma ilə sistemin işini ölçdü, modelin keyfiyyətini yox; DeepEP v2 eksperimenti qısa testdə 2,38 trilyon parametrə çatdı.
Açıq infrastruktur
Növbəti nəsil Olmo MoE arxitekturasından istifadə edir və ən güclü Olmo olmalıdı, ən böyük məlumat dəsti üzərində öyrədilmiş və ən uzun kontekstə malik. Sistem tamamilə açıqdır: araşdırıcılar öz MoE modellərini onun üzərində örəyə və digər aparat üzərinə adaptasiya edə bilərlər; texniki hesabat, kod və interaktiv demo artıq əlçatandır.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.