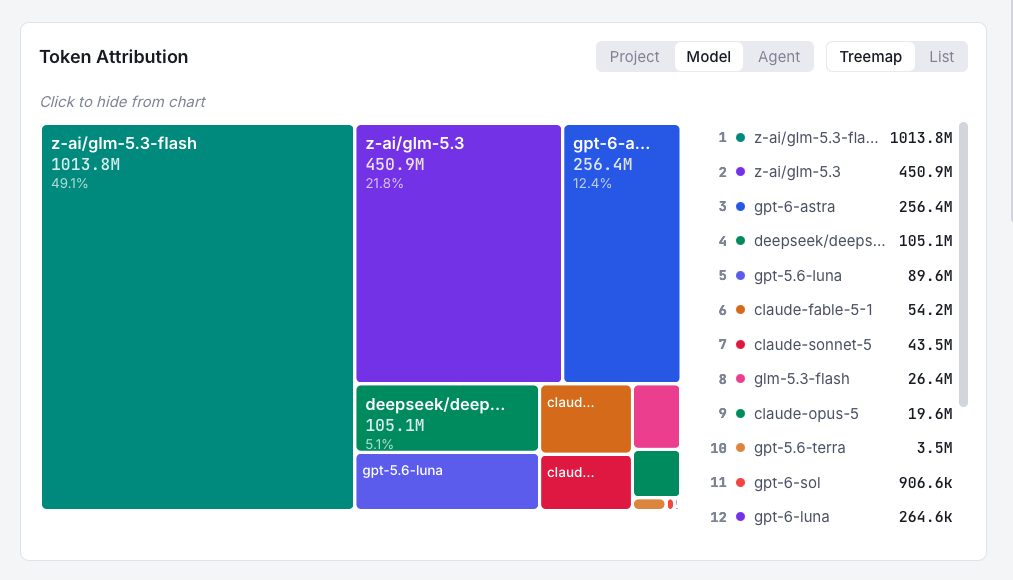
Bir aylıq GLM 5.3 Flash çağırışı 50% istifadə ilə başa çatdı
Bir aylıq cəhd, bütün AI işlərini GLM 5.3 Flash-a keçirmək, 50% istifadə ilə başa çatdı: 2 milyard tokendən yarısı hədəf model tərəfindən emal edildi. Prototip xərcləri, provayder limitləri və effektivliyin ölçülməsi dəyəri ortaya çıxdı.
İstifadə bölgüsü və prototip xərcləri
Sentyabrda bir effektiv açıq modellə keçirmə eksperimenti bizə 50% istifadə göstəricisi verdi. 2 milyard tokendən yalnız 1 milyardı GLM 5.3 Flash ilə emal olundu, baxmayaraq ki, ayın birinci yarısında o, bütün işi yerinə yetirdi. Onun qeydə alınan istifadəsi büdcəyə sığdı: 68 dollar, təxminən 4 kVt/saat enerji və 365 qram karbon emissiyası. İkinci yarısı üçün digər modellərə 1 milyard token lazım oldu.
Bir gözlənilməz məqam eksperimental Wagtail MCP serveri ilə bağlı idi, onu “vibe-coded” prototip kimi təsvir edirdilər. Model seçimi təxminən bir gecədə 450 milyon token, 150 dollar və 5 kVt/saat enerji sərf etdi. Server yaxşı işlədi və imkanlarını da göstərdi, lakin komanda hesab edir ki, oxşar nəticə xərcin beşdə biri və azacıq əlavə səylə əldə oluna bilər. Bu epizod bir daha göstərdi ki, eksperimentlər üçün büdcə lazımdır və modellər diqqətlə seçilməlidir.
İnfrastruktur mövcudluğu
Provayderlərin əlçatanlığı daha bir problem idi. Komandanın istifadə etdiyi inferens provayderləri tez-tez işləyirdi, lakin populyar seçimin böyük laboratoriyalara bənzər imkanları yox idi. GLM 5.3 Flash performansın pisləşməsini göstərdi, ehtimal ki, komandanın işi üçün Pareto cəbhəsində daha yüksəkdə otururdu. Mövcud seçim həmçinin Avropa data mərkəzlərində təsdiqlənmiş açıq modellərlə məhdudlaşırdı. Bu, oxşar modellərə keçidə səbəb oldu: DeepSeek V4.1 Flash və Qwen 3.8 Flash, bu asan dəyişiklik idi və gözlənilmirdi.
Rutin inkişafda xərc
Bir modelin rutin mühəndisliyində istifadəsi geniş seçimin sınaqdan keçirilməsi ehtiyacını aradan qaldırmadı. Komanda Wagtail tapşırıqları üzrə modellərin benchmark edilməsinə başlayır və agent bacarıqları üçün daha yüngül variantları və agentlərlə yaxşı işləməyi hədəfləyən yeni CLI prototipini tövsiyə etmək üçün müqayisə edilə bilən məlumatlara ehtiyac duyur.
GLM 5.3 Flash yenə də istehsalat işləri üçün əla qiymətləndirildi: 1 milyon token kontekst pəncərəsi, vizual dəstək və bir çox provayderlərdə əlçatanlıq sayəsində. O, Wagtail-də və onun üzərində qurulmuş saytlarda, həmçinin UI tapşırıqlarında, AI tədqiqat və inkişafında, sənədləşmə və qiymətləndirmələrdə istifadə olunurdu.
Növbəti test üçün dərslər
Oktyabr üçün çağırış yalnız rutin istehsalat işləri üzrə davam edəcək, tədqiqat və inkişaf üzrə deyil. Planlaşdırılan dəyişikliklər token istifadəsi, enerji sərfiyyatı, xərclər və konkret nəticələrin davamlı yerli hesabatlılığını əhatə edir. Komanda həmçinin eksperimentlər üçün aydın büdcələr müəyyən etməyi, prompt seçimini yaxşılaşdırmağı, rol əsaslı çoxagentli iş axınlarından istifadə etməyi və effektiv modellərin sınaqdan keçirilməsini davam etdirməyi planlaşdırır.
Daha geniş məqsəd AI inferens işlərinin əksəriyyətinin bir və ya iki ucuz flash səviyyəli modeldən istifadə etməsi, tərəqqinin isə qiymət və ya enerji sərfiyyatı ilə ölçülməsi, təkcə token sayı ilə deyil. Komanda həmçinin Jev tipli qərar diffuziya modellərini izləyəcək; əgər onlar səmərəli işləsələr, o zaman yeni flaqman modellər düzgün istiqamətə doğru addım kimi görünür.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.