Yeni Parsimony benchmark'i AI kodlaşdırma agentlərini əlavə edilən koda görə qiymətləndirir
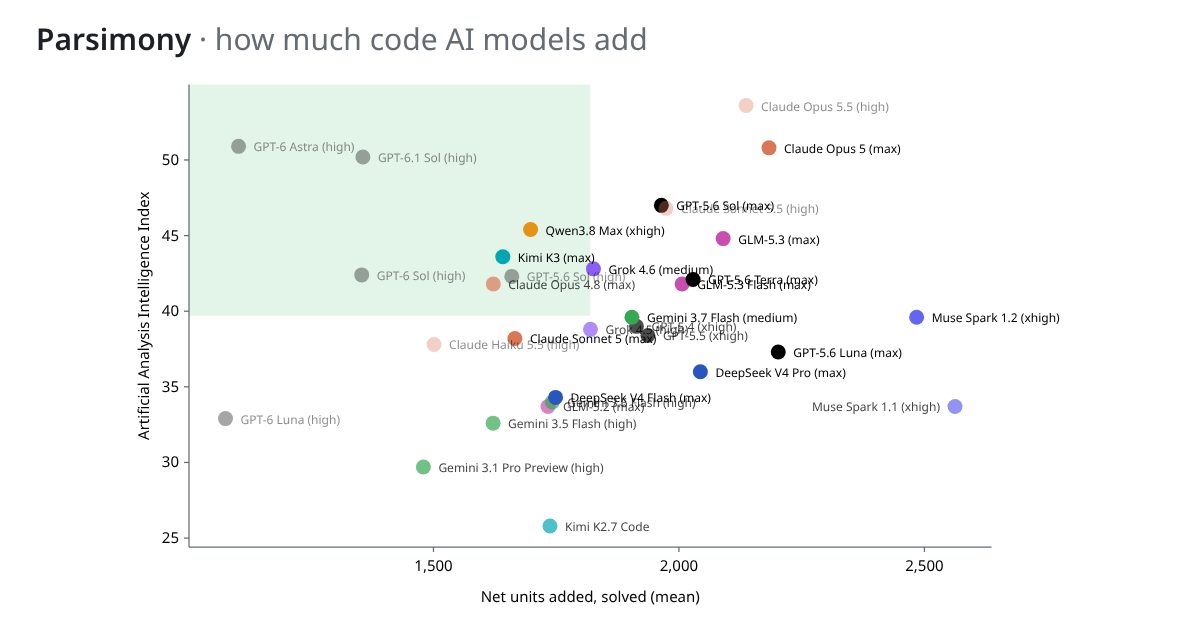
Parsimony benchmark'i AI kodlaşdırma agentlərinin tapşırığı həll edənə qədər neçə kod əlavə etdiyini ölçür. Sintaksis vahidlərini sayır, sətirləri yox, silinən kodu çıxır və modelləri SWE-bench Verified-də əlavə edilən orta təmiz vahidlərlə sıralayır.
Mövcud AI kodlaşdırma benchmark'ləri həll faizini və xərci ölçür, lakin artıq kod yazanları cəzalandırır ki, bu zamanla kod bazası ilə işi çətinləşdirə bilər. Parsimony, yeni benchmark, fərqli yanaşma istifadə edir: AI modellərinin tapşırığı həll edənə qədər neçə kod əlavə etdiyini ölçür.
Parsimony necə işləyir
Parsimony benchmark'lərin artıq dərc etdiyi patch'ləri götürür və kodlaşdırma vahidlərini, yəni təlimatlar, çağırışlar, müqayisələr, adlar və literallar kimi sintaksis elementlərini sayır. Sətirlər sayılmır, buna görə daha az sətirə kod yazmaq üstünlük sayılmır. Silinən kod çıxılır ki, bu sadə formulu verir: təmiz vahidlər = əlavə edilən - silinən. Hər patch tapşırığın kodu üzərində tətbiq olunur və hər dəyişdirilmiş faylın hər iki versiyası parse olunur; heç nə icra edilmir. Testlər, sənədlər və generasiya edilmiş fayllar istisna edilir və yalnız Python ölçülür. Uğurlu və uğursuz nəticələr SWE-bench-in dərc edilmiş nəticələrindən gəlir və testlər yenidən işə salınmır.
Liderboard necə oxunur
Modellər həll etdikləri tapşırıqlar üzrə əlavə edilən orta təmiz vahidlərlə, ən aşağıdan başlayaraq sıralanır. „Net units added (mean)" göstərici həmçinin uğursuz cəhdləri də əhatə edir. „Solved" sütunu SWE-bench Verified-dən gəlir, „Measured" isə neçə həll edilmiş cəhd ölçülə biləcəyini göstərir. Artificial Analysis Intelligence Index xarici bal kimi göstərilir, model və məntiq gücünə görə müqayisə edilir, lakin sıralamaya təsir etmir. Dərc edilmiş qeydlər müəllif tərəfindən ilk 3-dən 10-a qədər DeepSWE Python tapşırığı üzərində, OpenAI modelləri üçün pi və Anthropic modelləri üçün Claude Code istifadə etməklə işə salınır və hər tapşırığın öz testləri ilə qiymətləndirilir; onlar verifikasiya edilməyib və sıralanmayıb. GPT-5.6 Sol hər iki yolla işə salınır və müəllifin işə salması dərc edilmiş işə salma kodunu 0,88 dəfə artırır.
Məhdudiyyətlər və xəbərdliklər
Layihə kiçik olmağın həmişə daha yaxşı olmadığını qeyd edir: vahidlər ölçü deyil, oxunaqlığı və ya dizaynı ölçür. Daha çok kod yazan modellər adətən daha çox tapşırığı həll edir, 26 və ya daha çox modelin olduğu səhifələrdə Spearman korrelyasiyası 0,33-dən 0,60-a qədər. Hər model eyni mini-SWE-agent istifadə edir, lakin agent yenə də neçə kod yazılacağına təsir edir.
Öz benchmark'inizi əlavə etmək
Başqa benchmark-dən kod ölçüsü rəqəmləri olan oxucu nümunə JSON faylını endirə, öz nəticələrini doldura və eyni diaqram və cədvəl əldə etmək üçün onu aça bilər. Fayl brauzerdə qalır.
Mənbələr: parsimony.lasu.dev
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.