Qwen3.8-27B bir və iki RTX 3090-da: +20% decode, +14% soyuq prefill, keşlənmiş sorğularda 3x
Qwen3.8-27B-nin vLLM-də şəxsi benchmark-ı: bir RTX 3090 tensor parallelism rejimində iki karta qarşı. İkinci kart decode-a 15–30%, soyuq prefill-ə orta hesabla 14% əlavə edir; isti sorğulardakı fərqin böyük hissəsi isə prefix cache-ə aiddir.
14 avqustda buraxılmış 27,8 milyard parametrli sıx model Qwen3.8-27B W4A16 kvantlaşdırması ilə tək 24 GB kartda yerləşir. Arsen Apostolov ikinci RTX 3090-ın tensor parallelism altında həqiqətdə nə qazandırdığını ölçüb.
Quraşdırma
Hər iki server vLLM üzərində işləyir, prefix caching açıqdır, eyni imicdən və eyni Qwen3.8-27B-W4A16-AutoRound-fast çəkiləri ilə. Tək kart 22,6 GB VRAM və 131.072 token kontekst saxlayır; cüt çəkiləri kart başına 21,7 GB-a bölüb konteksti 262.144 tokenə çatdırır. Maşında üç RTX 3090, iki Xeon E5-2660 v4, 60 GB RAM və Ubuntu 26.04 var.
Ölçmə 150 sətirlik skriptdir: dörd ölçüdə real söhbət tamamlama sorğuları (600-dən 9.300 tokenə), hər biri üç dəfə və medianla, max_tokens=256 və temperature=0. Hər soyuq sorğu unikal ilk sətir daşıyır, beləliklə heç bir prefiks uyğun gəlmir.
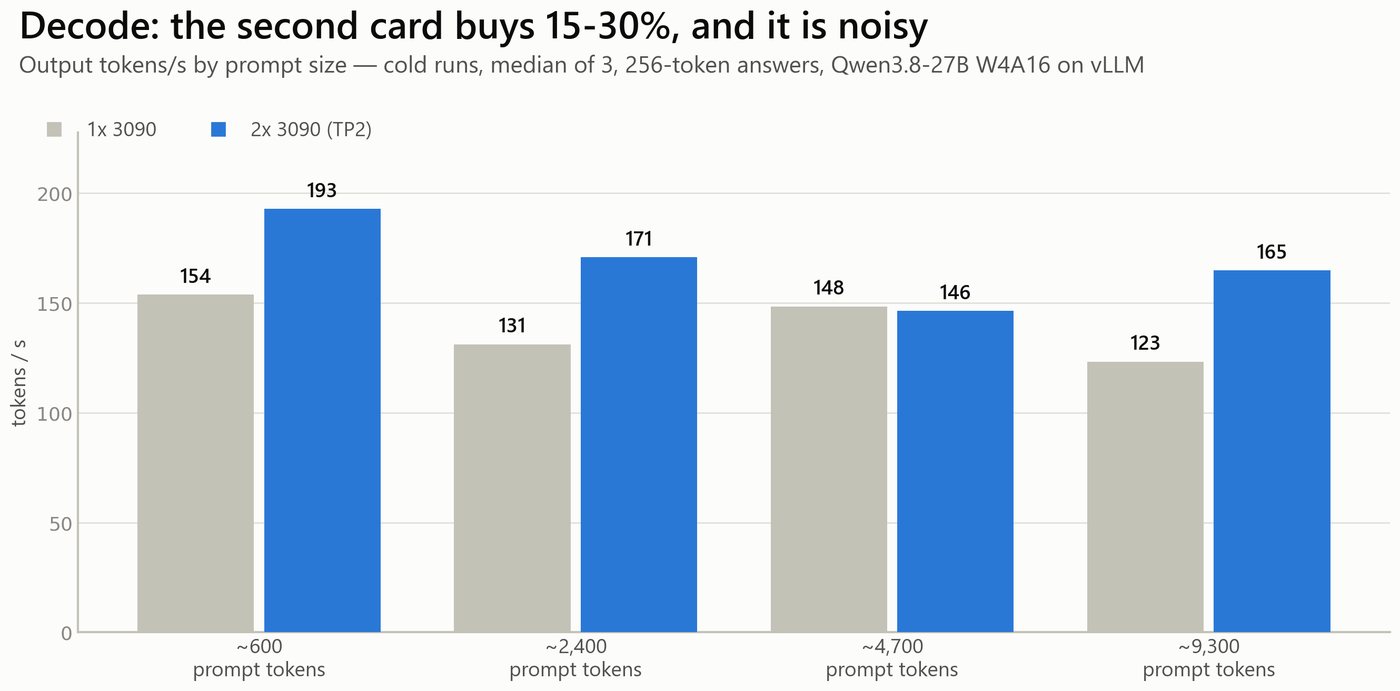
Decode: ikinci kartdan 15–30%
Tək kart bütün pillələrdə saniyədə 123–154 token saxlayır, cüt 146–193. Qazanc bu işə salmada orta hesabla +22%, bir saat əvvəlki işə salmada +13% oldu; çünki tək axınlı decode bir saat aralığında təxminən 10% dəyişir. Müəllif nəticəni qəsdən yuvarlaqlaşdırmır: 15–30% deyin və aşağı həddə hazır olun.
Prefill: soyuq kartların, isti keşin işidir
Soyuq prefill hesablamadan asılıdır: tək kart saniyədə 1.100–1.220 token emal edir, cüt 1.230–1.360. Prompt 600-dən 9.300 tokenə qalxdıqca ilk tokenə qədər vaxt tək kartda 0,53 saniyədən 8,5-ə, iki kartda 0,50-dən 6,9-a qalxır — 600 tokendə 6%, 9.300-də 23%, orta hesabla 14%.
İsti sorğular başqa mənzərə çəkir: təkrarlanan prompt cütdə 0,5–0,75 saniyəyə qayıdır, tək kartda 0,5–1,7 saniyəyə; bu 2–3 qat fərq avadanlığa deyil, prefix cache-ə aiddir. İpucu arifmetikadadır: 0,56 saniyədə emal olunan 8.600 token saniyədə 15.000 token deməkdir — iki 3090-ın 27B modeldə verdiyinin on qatı.
Nə qədər başa gəlir
Hər iki konteyner xidmət verərkən maşın rozetkadan 620 Vt çəkir. Saniyədə 150 token sürətində bir milyon token təxminən 6.667 saniyə, yəni 1,15 kVt/saat alır — Bolqarıstanın iki tarifli qaydasında gündüz 0,34 BGN, gecə 0,21 BGN, təxminən 0,20 və ya 0,12 dollar. DeepInfra Qwen3.8-27B üçün milyon çıxış tokeninə 3,00 dollar göstərir.
Apostolov bunun API-ni pis seçim etdiyini iddia etmir: qiymətə data mərkəzinin enerjisi, soyutması və boş gücü daxildir. Daha dar fikir budur: artıq işləyən avadanlıqda verilən hər token demək olar ki, təmiz marjıdır. Müəllif testin sərhədini də qeyd edir — tək sorğulu ölçmə, continuous batching sınanmayıb.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.