NVIDIA və IIT Madras 2,8 trilyon tokenlu Indic ön təlim korpusu buraxdı
NVIDIA, IIT Madras və AI4Bharat Nemotron-pretraining-Indic-v1 təqdim edir: 22 hind dilində təxminən 2,8 trilyon token ibarətli korpusu və onun yaradılmasında istifadə edilən açıq, GPU sürətləndirməli məlumat emalı pipeline.
Korpus 22 hind dili üçün
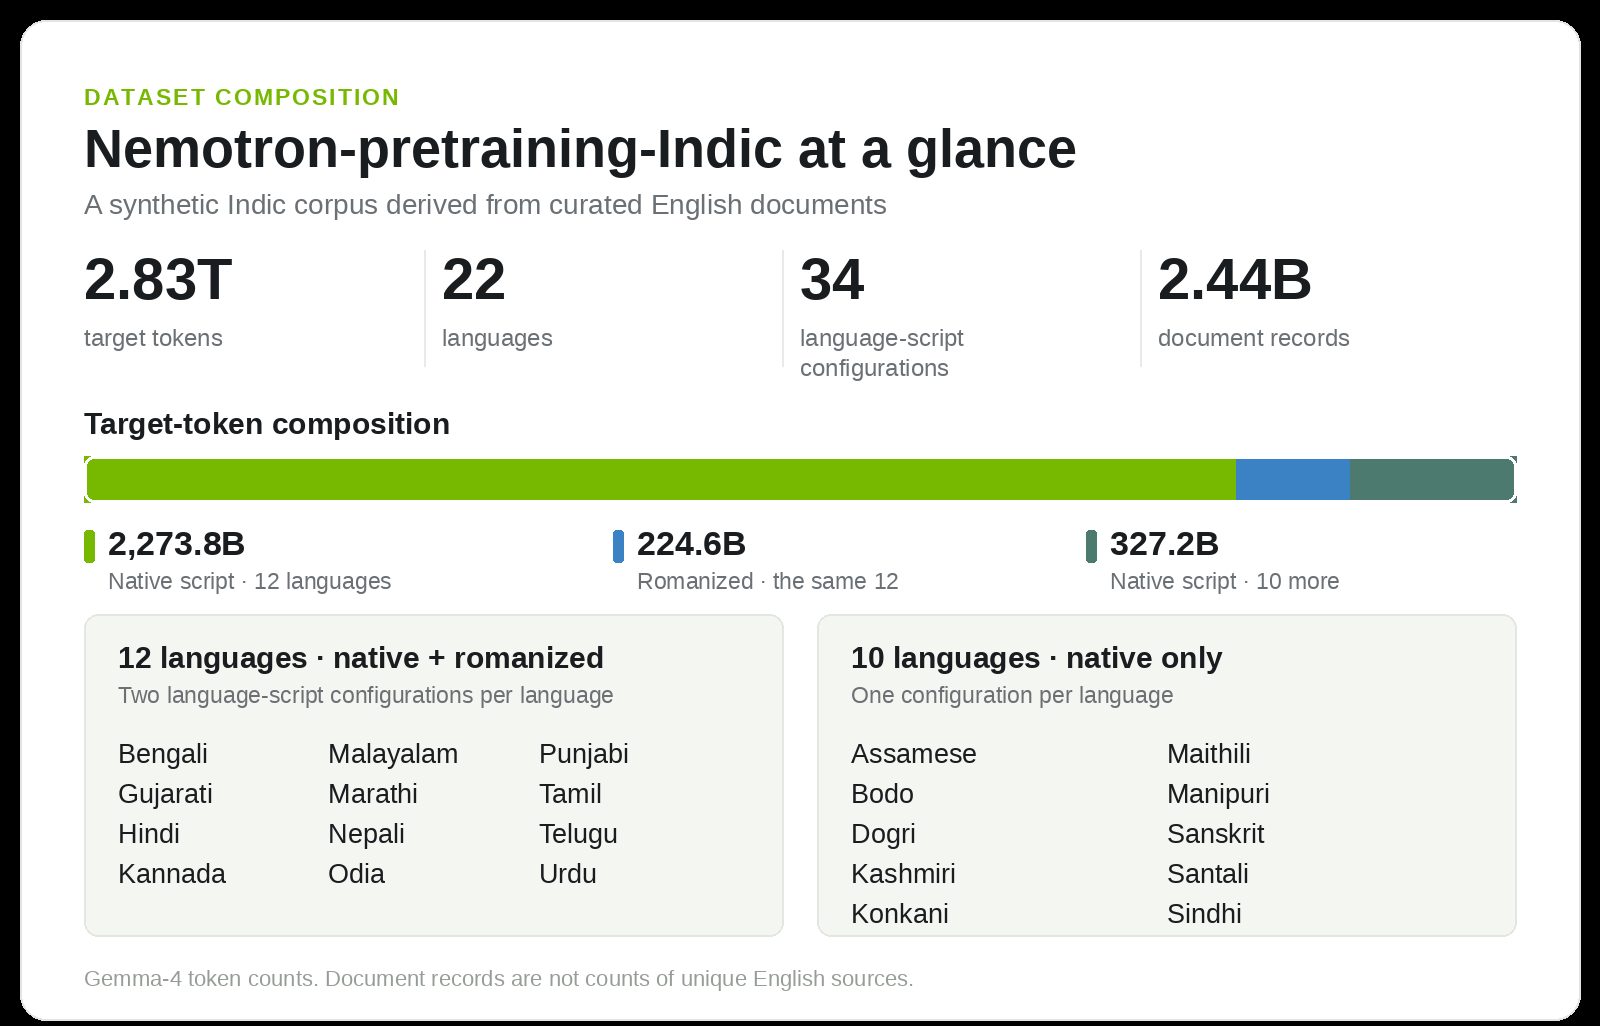
NVIDIA IIT Madras və onun AI4Bharat laboratoriyası ilə birlikdə Nemotron-pretraining-Indic-v1 təqdim etdi. Bu, Hindistan Konstitusiyasında siyahıya alınan 22 dilə təxminən 2,8 trilyon token də əhatə edən ön təlim korpusudur. Buraxılış həm də onun yaradılmasında istifadə edilən açıq, GPU ilə sürətlənən məlumat yaradma hatını əhatə edir; bu hat tərcümə, keyfiyyət qiymətləndirmə və düzəltmə aşamasını özündə birləşdirir.
Korpus ana yazılarda 2 601,0 milyard token və 224,6 milyard romanlaşdırılmış token ehtiva edir; hesablama Gemma-4 tokenizer ilə aparılıb. 34 yazı-konfiqurasiya daxildir: bütün 22 dil üçün ana yazı məlumatları və onlardan on ikisi üçün romanlaşdırılmış mətn. Hər qeyd kuratorlu mənbə sənədi ilə bağlıdır və hər nəticə daxiletmə ilə müqayisə edilir ki, sintetik mətn real mələtanı əsaslınsın.
İngilis mənbələrindən hind təlim məlumatlarına
Hat 15 Nemotron-CC-v2 alt-qrupunun sənədlərindən başlayır; bunlar veb mətn, sual-cavab, riyaziyyat, kod və digər ixtisaslaşmış məzmunu ehtiva edir. NVIDIA-nın açıq kodlu NeMo Data Designer çərçivəsi tərcümə, keyfiyyət yoxlamaları və məqsədyönümlü düzəltmələr aparır, eyni zamanda mənbə identifikatorlarını saxlayır ki, nəticələr orijinal sənədlərə qədər izlənilsin.
On iki dil üçün sənədlər tamamilə Gemma-4-31B-it istifadə edilərək tərcümə olunur; bu model bütün sənədləri müqayisə etdikdən sonra seçilib. Multidimensional Quality Metrics modelinə əsaslanan rubrik mənanı, düzgünlüyü, terminologiyayı, stili və formatı əhatə edir və yalnız 100-dən minimum 75 bal toplayan nəticələr qalır. Aşağı ballı nəticələr əks əlaqə vasitəsilə düzəldilir və yenidən qiymətləndirilir; bu proses 438,4 milyard token geri qaytarır. Alınan ana yazı tərcümələri həmçinin romanlaşdırılmış hissə üçün latın yazısına çevrilir.
Qalan on dil ayrıca iş prosesindən istifadə edir; bu proses Indic Translate-ə əsaslanır və Bodhan AI-nın sənəd səviyyəli tərcümə modelindən istifadə edir. Daha uzun Santali sənədləri üçün önümü gələn pəncərələr tərcümə olunur və yenidən qurulur; Manipuri üçün mətn bengal yazısında tərcümə olunur, sonra Meitei Mayek-ə çevrilir.
Nemotron modellərinə təsir
Nemotron 3.5 Super VL-ın uzun müddətli ön təlimi korpusunun on iki alt-qrupundan və natural hind mətnlərindən əldə edilmiş 10 milyard hind token əlavə etdi. Bütün beş hind bilik və məntiq benchmark-ində xallar artıb və 4,98-dən 9,82 faiz nöqtəyə qədər artım göstərib. Buraxılan model həmçinin altı hind tapşırığı benchmark-indən beşində Nemotron 3 Super-dən yüksək bal toplayır və IndiVibe-in bütün ölçüsündə üstünlük edir, lakin IFEval 1.5-də təlimat icrası 2,04 nöqtə azalıb.
Komanda bu korpusu gələcək Nemotron modellərində istifadə etməyi planlaşdırır və onu yerli bilik və mədəni kontekst üçün natural hind mətləri ilə qarışdırmağı təklif edir.
Mənbələr: Hugging Face Blog
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.