Tokenizer vergisi: qeyri-ingilis dilli AI istifadəçiləri niyə daha çox token ödəyir
Süni İntellekt Tədqiqatlarında Dil Bərabərliyi Koalisiyasının araşdırmasına görə AI modelləri bəzi dillərdə daha çox token tələb edə bilər; bu isə qeyri-ingilis dilli istifadəçilər üçün xərc, gecikmə və kontekst limitlərini artırır.
Süni İntellekt Tədqiqatlarında Dil Bərabərliyi Koalisiyasının araşdırmasına görə, AI modelləri bəzi dillərdə digərlərinə nisbətən daha çox token tələb edə bilər; bu, tədqiqatçıların gizli tokenizer vergisi adlandırdığı effekti yaradır. Bu effekt daha az danışılan dillərdən istifadə edən insanlar üçün AI-ni daha bahalı edə bilər, xüsusilə həmin dillərin onlayn mövcudluğu daha kiçikdirsə. Tokenlər AI modellərinin emal etdiyi mətn və ya verilən vahidləridir.
Token sayının dilə görə dəyişməsi
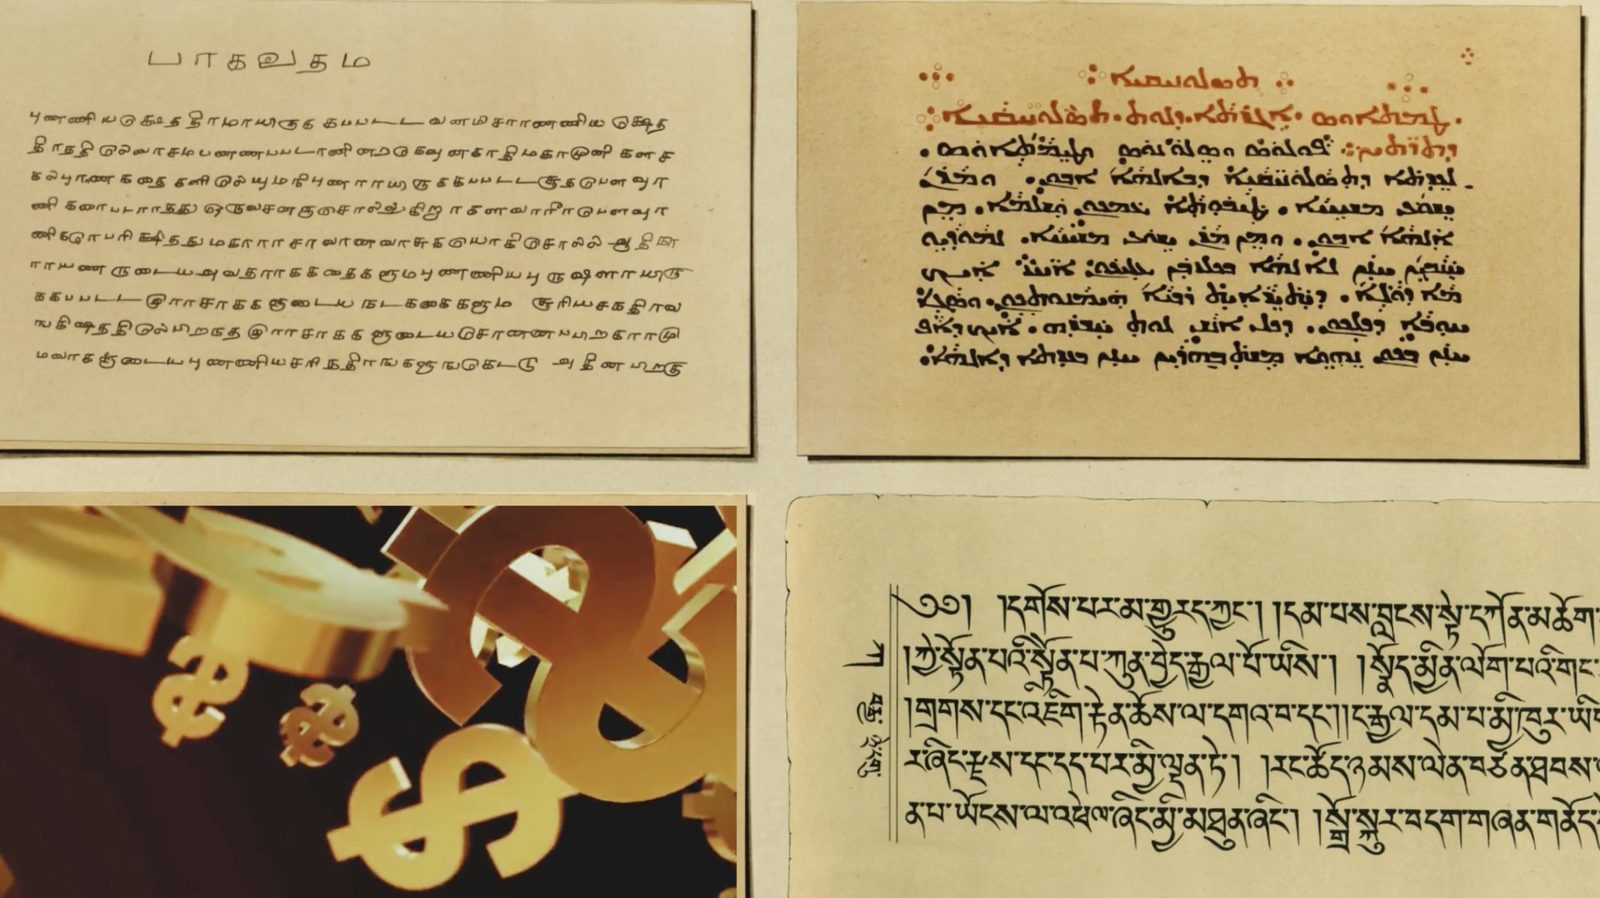
Tokenizerlər xam mətni, şəkli və ya səsi tokenlərə bölür. Bir nümunədə ingilis dilli cümlə tanınan sözlərə bölünmüşdü, eyni cümlənin Malayalam dilində variantı isə hər sözə görə bir neçə parçaya, çoxbaytlı simvollar nəzərə alınmadan bölünmüşdü. İnternetin ən çox istifadə olunan 20 dilində belə token istifadəsində fərq aşkar edildi: həmin dillər içində ən bahalısı ən ucuzundan 1.5 ilə 5 dəfə daha çox token istifadə edirdi. Dillər 200-ə çatanda bir AI modelində token xərci fərqi 17 dəfə artdı. Araşdırma bildirir ki, Bengalurudakı bir startup hər sorğu və cavab üçün əlavə ödəniş verə bilər, Austin-dəki rəqibi isə vermir.
Xərc tək cəza deyil
Daha yüksək token sayı həm də gecikməni artırır və effektiv kontekst tutumunu azaldır, araşdırma bildirir. Pratyush Choudhury, Activate AI-nin həmtəsisçisi, deyir ki, qeyri-ingilis dilləri sənədlər və ya söhbət tarixçəsi üçün daha az yer buraxır və cavab yaratmaq üçün daha çox iş tələb edir. O, problemi bir müəllimin şagirdin əvvəlki səhvlərini və izahlarını yadda saxlamasına bənzədib: əgər bu tarixçə bir dildə kontekst pəncərəsini daha sürətlə doldurursa, çatışmazlıq xidmət keyfiyyətinə də təsir edir. Araşdırma deyir ki, bu cərimələr hesablama gücü və bağlantının artıq məhdud olduğu yerlərdə daha ağır olur və tokenizer bərabərsizliyi AI iqtisadiyyatında kimin iştirak edə biləcəyinə məhdudiyyətdir.
Yazı sistemi, verilənlər və dizayn hamısı əhəmiyyətlidir
Dilin nadir olması token istifadəsində yeganə amil deyil; yazı sistemi böyük rol oynayır. Asturiya dili, danışanlarının nisbətən az olması və Common Crawl verilənlərinin olmamasına baxmayaraq, Latin əlifbasının üstünlüyündən və İtalyan dili kimi qohum Roma dillərinin təmsilindən faydalanır. Tokenizerlərin nadir gördüyü yazı sistemlərində yazılmış dillər, o cümlədən Birma, Tibet, Tifinaq, Xmer, Lao və Ol Çiki, analizdə demək olar ki, bütün modellərdə ən böyük çatışmazlıqla üzləşirdi. Maya Research-in CEO-su Dheemanth Reddy deyir ki, bir çox tokenizer hələ də ingilis və digər yüksək resurslu dillər üçün qeyri-mütənasib şəkildə optimallaşdırılıb və əsas problem yüksək keyfiyyətli rəqəmsal verilənlərin çatışmamasıdır. Dil emalını yaxşılaşdırmaq yollarından biri əsas verilənləri yaxşılaşdırmaqdır. Navana.ai-nin həmtəsisçisi və CEO-su Raoul Nanavati RESPIN-ə işarə etdi; bu, Gates Fondu tərəfindən maliyyələşdirilən və Hindistan Elm İnstitutu ilə birgə həyata keçirilən əməkdaşlıq təşəbbüsüdür və 38 dialektin ana dilli danışanlarından mətn, eləcə də oxunmuş nitq toplamışdır.
Fərqi aradan qaldırmaq
Reddy xəbərdarlıq edir ki, daha yaxşı təlim verilənləri təkbaşına tokenizeri düzəltmir. Token qiymətləri sürətlə düşür, ona görə birbaşa xərc təsiri zamanla daha az ağır olmalıdır və daha yaxşı çoxdilli və sintetik verilənlər model keyfiyyətini yaxşılaşdırmalıdır. Lakin tokenləşdirmə fərqini həqiqətən aradan qaldırmaq üçün laboratoriyalar gələcək tokenizerləri bu dilləri və yazı sistemlərini daha yaxşı emal etmək üçün qəsdən layihələndirməlidirlər. Choudhury deyir ki, dil effektivliyi dəqiqlik, sürət və etibarlılıqla yanaşı məhsul tələbi olmalıdır. O deyir ki, mükəmməl bərabərlik realist olmaya bilər, lakin böyük və davamlı fərqlər izah və yaxşılaşdırma planı tələb etməlidir, və o, hər böyük laboratoriyadan oxşar tapşırıqları uğurla yerinə yetirməyin nəyə başa gəldiyini hər dil üzrə göstərən cədvəl dərc etməyi və ən pis xidmət olunan dilləri üçün ölçülə bilən yaxşılaşmalar öhdəliyi götürməyi xahiş edir.
Mənbələr: Rest Of World · Techmeme
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.