Meta boş qalan ehtiyat GPU-lardan və yoxlama nöqtələrindən Prometheus-da AI təlimini davam etdirmək üçün istifadə edir
Meta, Prometheus süperklasterindəki GPU-ların 11 faizdən çoxunun qeyri-işlək və ya ehtiyat olduğunu bildirib. Şirkət yoxlama nöqtələrini, NVLink işlərini və bir milyon sürətləndiriciyə yaxınlaşarkən daha az dayanışı qeyd edib.
Ehtiyatlar nasazlıqları udurur
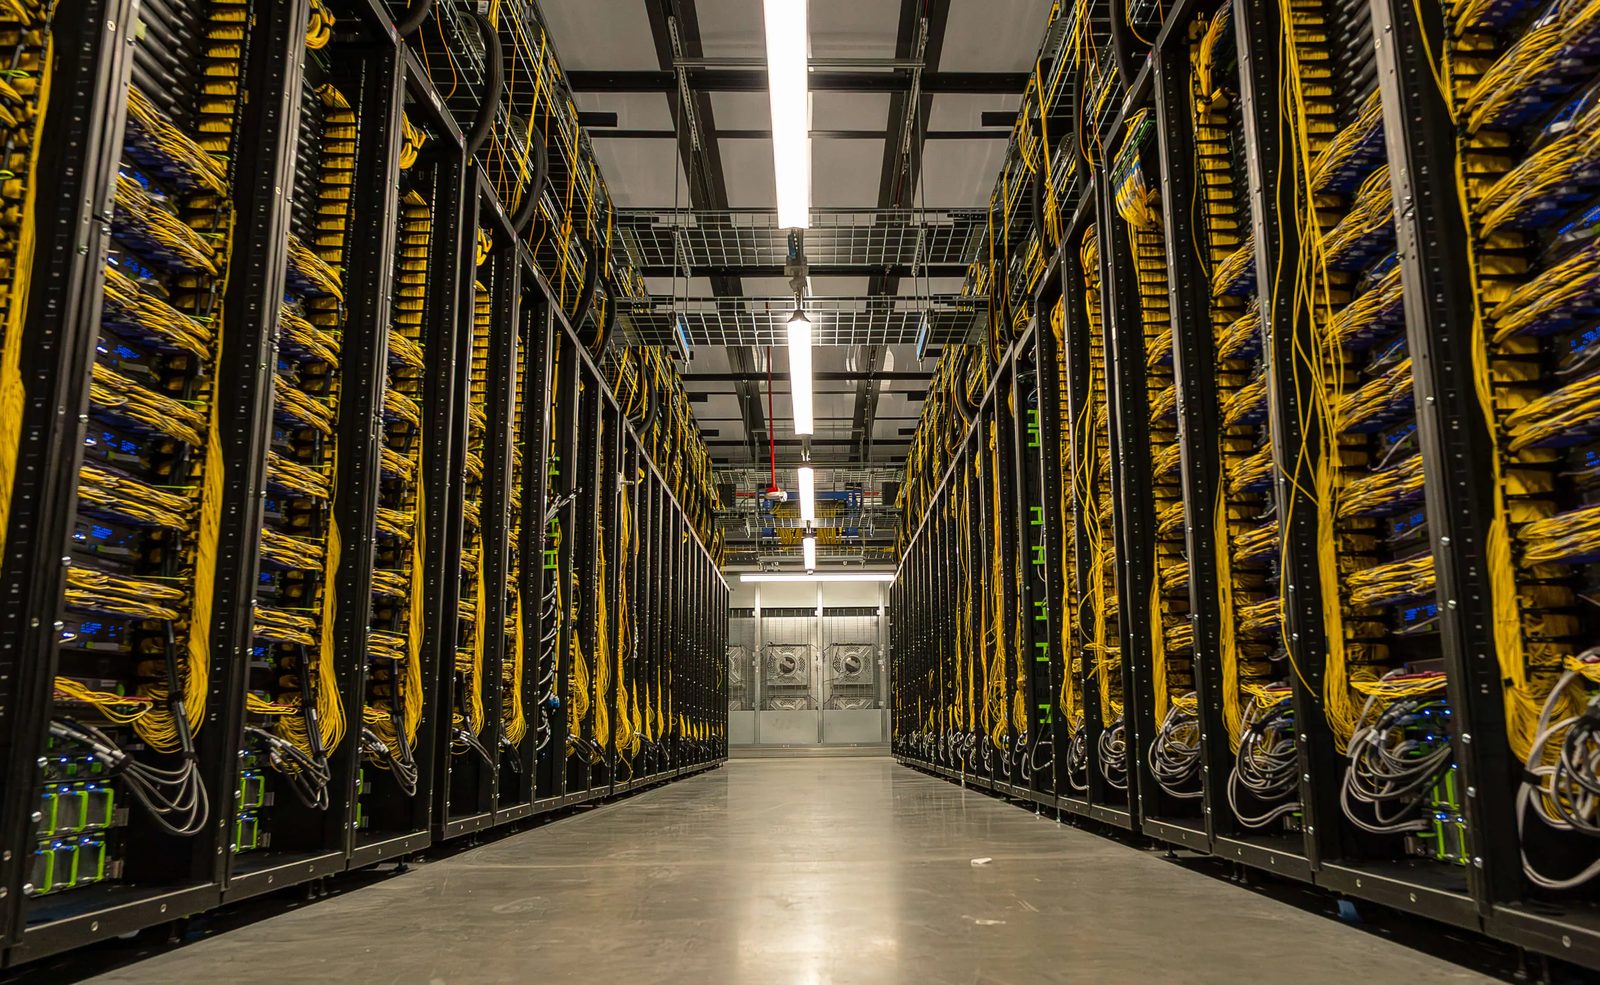
Meta, Ohio ştatının New Albany şəhərindəki Prometheus süperklasterindəki GPU-ların 11 faizdən çoxunun nasaz bir vahidi əvəz etmək üçün ölü və ya boş gözlədiyini bildirib. Ehtiyat hovuzu Meta-nın söylədiyi kimi sistemin bir hissəsidir; bu sistem Nvidia Grace Blackwell rəf sistemlərindən, sonradan isə Vera Rubin sistemlərindən istifadə edərək təxminən bir qiqavat tutuma və bir milyona yaxın sürətləndiriciyə çatacaq.
Hazırkı klaster hər NVLink sahəsində 72 GPU ilə GB200 və GB300 sistemlərindən istifadə edir, lakin hər anda yalnız 64 GPU işlədilir. Digər səkkiz GPU hazır ehtiyat kimi gözləyir. Meta, nasaz bir GPU-nun əks halda bütün rəfi söndürə və təlimin aparılmasını kəsə biləcəyi üçün bunun vacib olduğunu bildirib. Ehtiyat GPU ilə əvəzləmə mümkün olur, lakin nasazlıq yenə daha qısa bir dayanma səbəb olur.
Prometheus ilk mərhələsini başladanda Meta hər 8.000 GPU üçün gündəlik təxminən 1.000 dayanış gördüyünü bildirib. Dayanış o deməkdir ki, bir şey qırıldı, nasaz oldu və ya vaxtı keçdi və təlim son bilinən yaxşı yoxlama nöqtəsinə qaytarıldı. Meta bundan sonra təxminən bir il ərzində dayanışları 99 faiz azaldaraq hər 8.000 GPU üçün gündəlik təxminən 11 dayanışa endirdiyini söyləyib.
Yoxlama nöqtələri geri qaytarmayı məhdudlaşdırır
Meta həmçinin məlumat paralelliyindən istifadə edən böyük təlim tapşırıqlarında nasazlıqları necə əhatə etdiyini təsvir edib; bu yanaşmada modelin bir neçə nüsxəsi klasterda yerləşir. Əgər nasazlıq yalnız bir məlumat paralel model nüsxəsinə məhdudlaşdırıla bilsə, bu nüsxə xətdən çıxır, klasterin qalanı addımı təkrar edir və təlim davam edir. Zədələnmiş hissə sonra ehtiyat hostlarda yenidən işə salınır və sinxronlaşdırılır, bu da tam dayanmanı müvəqqəti ümumi məhsuldarlıq azalmasına çevirir.
Əgər nasazlıq məlumat paralelliyi sahəsindən kənara çıxırsa, Meta yoxlama nöqtələrinə arxalanır. Şirkət dağıtılmış yoxlama nöqtələri arxitekturasının model vəziyyətini, o cümlədən qradient və optimizator məlumatlarını bir neçə saxlama səviyyəsinə asinxron şəkildə saxladığını bildirib. Bu imkan verir ki, təlim yenidən başlamazdan saxlanmış vəziyyətdən davam etsin. Meta bu işi Muse Spark və daha yeni Muse Wonder kimi modelləri yolda saxlamaq üçün lazımlı hesab edib.
Bağlantılar və enerji miqyası təyin edir
Bir çətinlik NVLink şəbəkələrinin bir böyük sürətləndirici kimi işləməsini təmin etmək oldu. Meta, əvvəlki H100 və H200 sistemlərində hər NVLink sahəsində 8 GPU var idi, Nvidia Blackwell isə bunu doqquz dəfə artırdı. 600.000-dən çox NVLink bağlantısı olan şəbəkədə minimal signal zəifləməsi tez-tez bərpa dövrlərini işə salırdı. Meta sistemlər istehsala çıxmadan əvvəl zəif bağlantıları ayırmaq üçün davamlı telemetriya və L11 diaqnostik yoxlamalarından istifadə etdi.
Enerji də başqa bir məsələ idi. Meta, təlim üçün on minlərlə GPU-nun yüksəldilməsi və alçaldılmasının böyük enerji keçidləri yarada biləcəyini və bu keçidlərin güc təchizatı avadanlıqlarını həddindən artıq yükləmə riski yaradacağını bildirib. Şirkət klaster sabitliyini və etibarlılığı üstün tutaraq Muse Wonder üzərində öncədən təlim üçün 85 faizdən çox goodput və gücləndirməli öyrənmə üçün 90 faizdən çox goodput əldə etdiyini bildirib. İrəli baxanda Meta, dayanış sayını hər 8.000 GPU üçün gündəlik ikiyə endirmək istəyir, bu da dayanışlar arası ortalama zamanın təxminən 100.000 GPU saatı deməkdir.
Mənbələr: The Register
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.