NVIDIA ו-IIT Madras שוחררו אוסף אימונים מוקדמים של Indic בנפח 2.8 טריליון טוקנים
NVIDIA, IIT Madras ו-AI4Bharat משחררים את Nemotron-pretraining-Indic-v1, אוסף של כ-2.8 טריליון טוקנים ב-22 שפות הודיות, יחד עם צינור הפתיחה הפתוח והמואץ ב-GPU ששימש ליצירתו.
האוסף ל-22 שפות הודיות
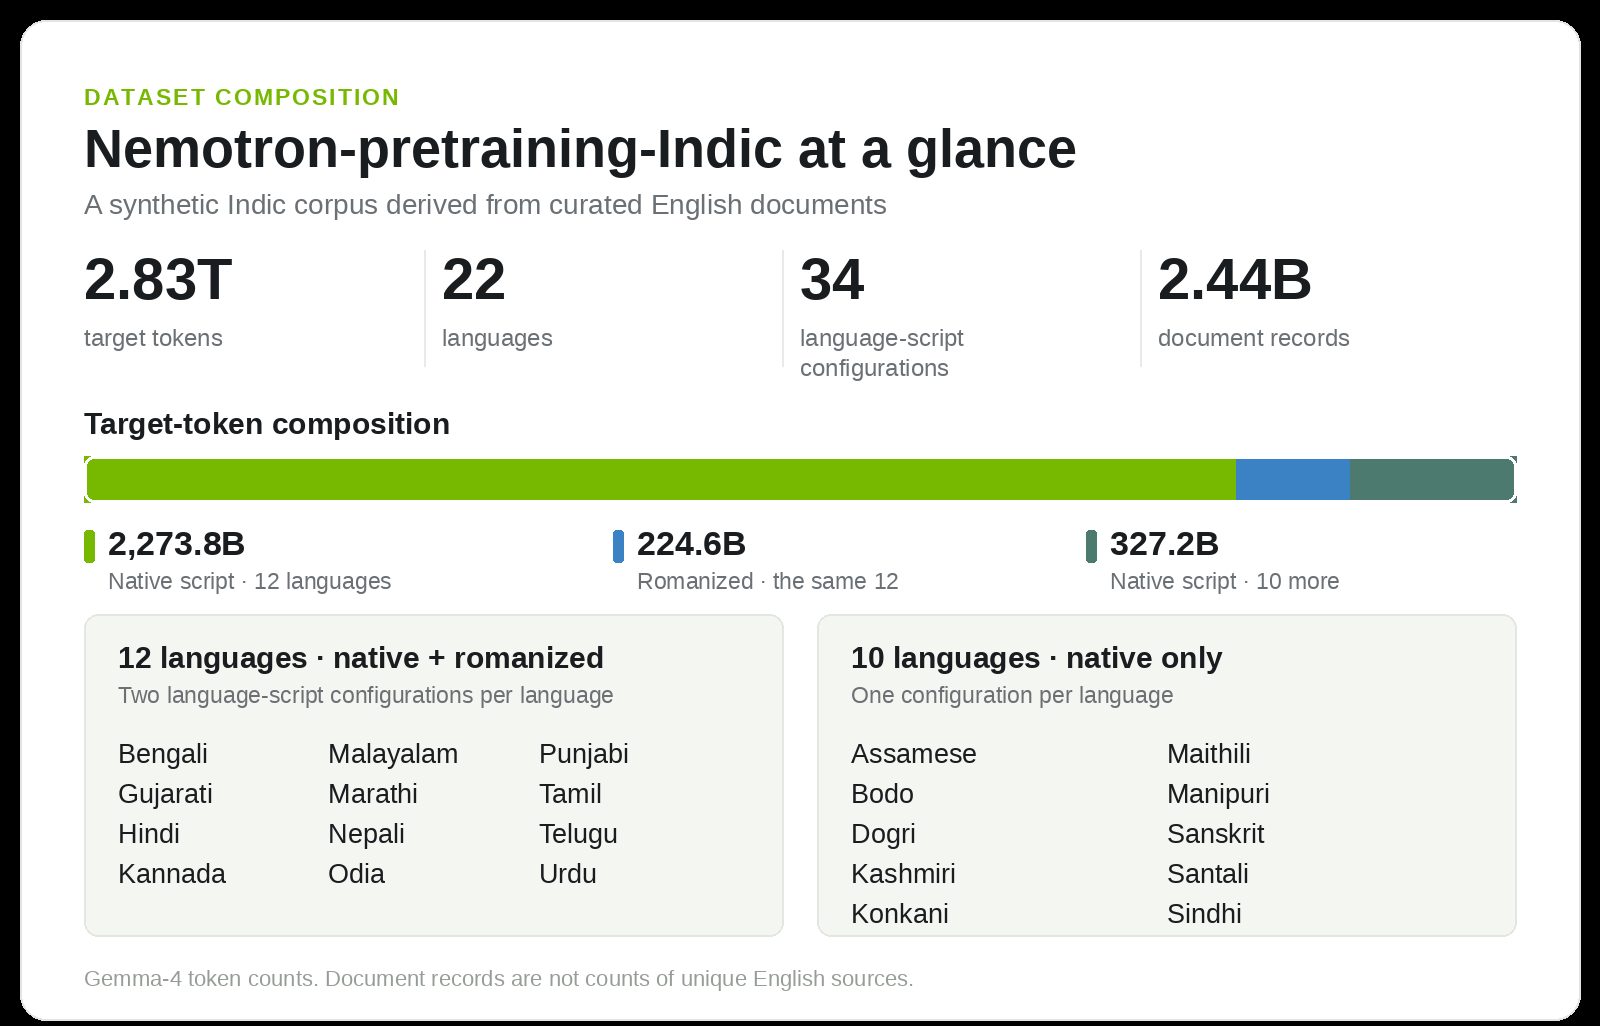
NVIDIA, בשיתוף IIT Madras והמעבדה שלהם AI4Bharat, הציגה את Nemotron-pretraining-Indic-v1, אוסף לאימונים מוקדמים שכולל כ-2.8 טריליון טוקנים ב-22 השפות המפורטות בחוקת הודו. השחרור כולל גם צינור ייצור נתונים פתוח ומואץ ב-GPU ששימש ליצירתו וכולל תרגום, הערכת איכות ותיקון.
האוסף כולל 2,601.0 מיליארד טוקנים בכתב המקום ו-224.6 מיליארד טוקנים מלטיניים, שנספרו באמצעות הטוקנייזר Gemma-4. הוא כולל 34 תצורות שפה-כתב: נתוני כתב מקום לכל 22 השפות וטקסט מלטיני ל-12 מהן. כל רשומה מקושרת למסמך מקור אצור וכל פלט נבדק מול הקלט שלו, כדי שהטקסט הסינתטי יתבסס על מידע אמיתי.
ממקורות אנגליים לנתוני תרגול הודיים
הצינור מתחיל מ-15 תת-קבוצות מסמכים של Nemotron-CC-v2, הכוללות טקסטי אינטרנט, חומר שאלות-תשובות, מתמטיקה, קוד ותוכן מקצועי נוסף. מסגרת הקוד הפתוח של NVIDIA, NeMo Data Designer, מבצעת תרגום, בדיקות איכות ותיקון מכוון, ומשמרת מזהי מקור כדי שהפלטים יהיו ניתנים למעקב חזרה למסמכים המקוריים.
עבור שתיים-עשרה שפות, המסמכים מתורגמים במלואם באמצעות Gemma-4-31B-it, שנבחר לאחר השוואה על מסמכים מלאים של מודלים. רובריקה בהשראת Multidimensional Quality Metrics כוללת משמעות, תקינות, טרמינולוגיה, סגנון ועיצוב, ורק פלטים שצורפים 75 נקודות לפחות מתוך 100 נשמרים. פלטים בעלי ציון נמוך מתוקנים באמצעות פידבק הערכה ונשלחים להערכה מחדש, תהליך שהחזיר 438.4 מיליארד טוקנים. התרגומים בכתב המקום שהתקבלו מומרים גם לכתב לטיני עבור החלק המלטיני.
שלוש השפות הנותרות משתמשות בתהליך עבודה נפרד המבוסס על Indic Translate, מודל תרגום של מסמכים ברמת דונית של Bodhan AI. עבור מסמכי Santali ארוכים יותר, חלונות חופפים מתורגמים ומשוקמים; עבור Manipuri, הטקסט מתורגם לכתב בנגלי ולאחר מכן מומר ל-Meitei Mayek.
השפעה על מודלי Nemotron
האימון המוקדם המומשך של Nemotron 3.5 Super VL הוסיף 10 מיליארד טוקנים הודיים, שנלקחו מתת-הקבוצה המונה שנים-עשר של האוסף ומטקסטים הודיים טבעיים. הציונים עלו בכל חמשת בחני הידע וההיגיון ההודיים המצוינים, עלייה של עד 9.82 נקודות אחוז בממוצע. המודל ששוחרר מצטיין גם יותר ב-Nemotron 3 Super בחמישה מתוך שישה בחני משימות הודיים ומשתפר בכל ארבעת הממדים של IndiVibe, אם כי שמירת הוראות ב-IFEval 1.5 ירדה ב-2.04 נקודות.
הצוות מתכנן להבסיס מודלי Nemotron עתידיים על אוסף זה וממליץ לשלב טקסטים הודיים שנכתבו באופן טבעי עבור ידע מקומי והקשר תרבותי.
מקורות: Hugging Face Blog
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.