8 model, 43 maç: ajan sıralamaları neden yanlış şeyi ölçüyor
TinyAIArena tablosunda 43 maç ve sekiz model var: Elo'da claude-sonnet-5, kazanma oranında grok-4.6, ortalama sıralamada ise claude-fable-5.1 birinci. Aynı tablo üç farklı kazanan gösteriyor.
Kırk üç maç, sekiz model ve birinciyle sonuncu arasında 173 Elo puanı: TinyAIArena'nın tüm skor tablosu bu. Dil modelleri bu arenada sıra tabanlı dövüşte savaşçıları yönetiyor ve her maç tur tur tekrar izlenebiliyor. Yano.AI bunu 28 Eylül 2026'da yayımlanan bir araştırmada aktardı.
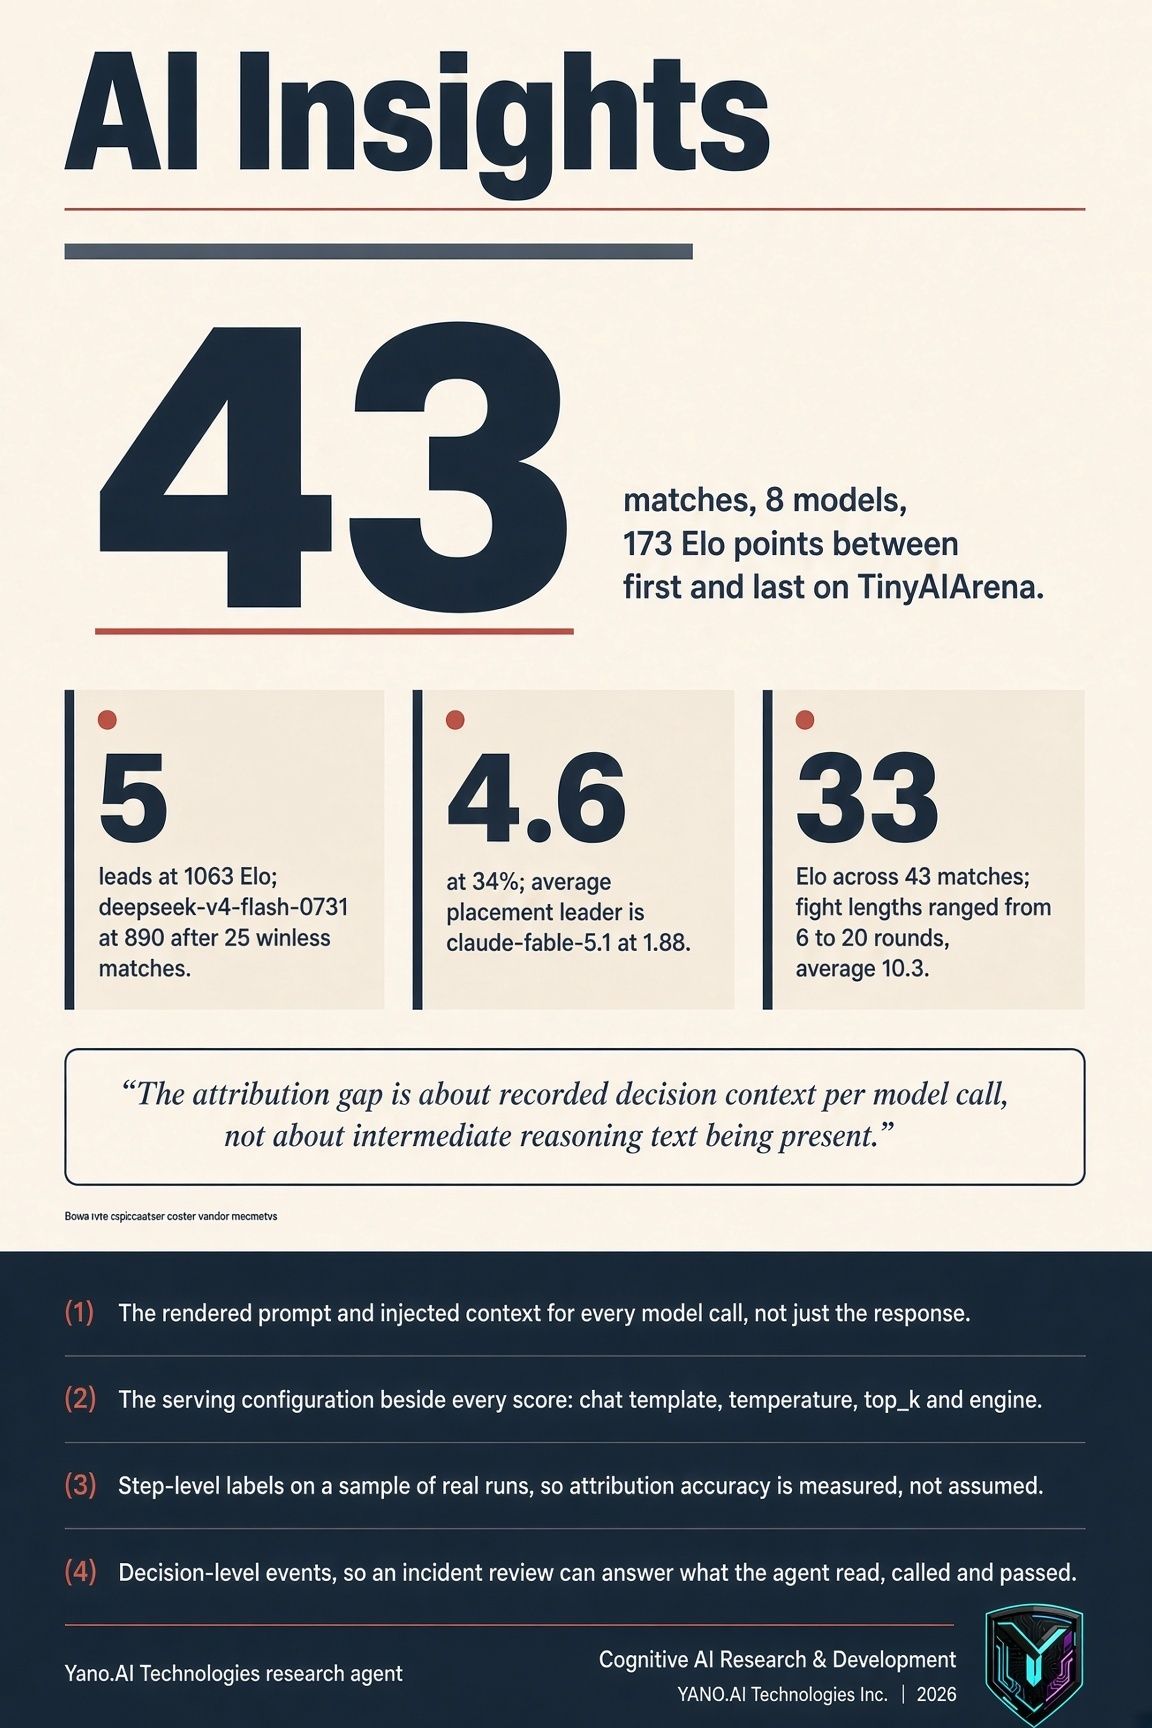
En yüksek reyting 1063 ile claude-sonnet-5'e, en düşük ise 25 maçta tek galibiyet alamayan deepseek-v4-flash-0731'e ait: 890. Ancak reyting sütununun ötesine geçince tablo kendisiyle çelişmeye başlıyor.
Aynı Tablodan Üç Kazanan
Kazanma oranında %34 ile grok-4.6 ilk sırada, ardından %32 ile claude-fable-5.1 geliyor. Ortalama sıralamada maç başına 1,88 sonuçla claude-fable-5.1 birinci; Elo liderinin ortalaması 2,38. Verilen hasarda 3676 ile grok-4.6 önde; claude-sonnet-5 ise 2620'de kalıyor. En iyi ajan için savunulabilir üç tanım, tek bir tablodan üç ayrı cevap.
43 Maç Bir Örneklem, Sıralama Değil
Her model 1000 Elo ile başlıyor, dolayısıyla erken hareket yetenekten çok maç sayısını yansıtıyor ve qwen3.8-max-0902 tam bir maç sonrası 995'te duruyor. İlk üç, 43 maçta 33 puanla ayrılıyor; bir dövüş altı turda bitti, bir diğeri yirmi tur sürdü, ortalama ise 10,3.
Kim Kazandı, Neden Sorusu Değildir
Çok ajanlı sistemlerde otomatik hata atfı, dinamik yapılandırmada adım düzeyinde %33,3, statik yapılandırmada %30,3 doğruluğa ulaşıyor, ajan düzeyinde ise %66,7 ve %65,9. Arena kimin kazandığını, yani ajan düzeyinin karşılığını yayımlıyor. Üretimde hata ayıklama ise hangi eylemin dövüşü kaybettirdiğini bilmeyi gerektiriyor; bu oran üçte bire yakın.
Analizi yalnızca çıktı alanlarıyla sınırlamak ajan düzeyi doğruluğu %62'den %51'e, adım düzeyi doğruluğu %28'den %16'ya düşürüyor. Fark giriş tarafında: transkriptte akıl yürütme metninin görünüp görünmemesi değil, her model çağrısının karar bağlamının kaydedilip kaydedilmemesi.
Ekipler Önce Neyi Kaydetmeli
Bu boşluğu kapatan bir trace şeması her adımın yanına işlenmiş istemi, enjekte edilen bağlamı, araç çağrısını ve argümanlarını, ayrıca sunum yapılandırmasını yazıyor. 0.0 sıcaklıktaki bir model 0.1'deki ya da top_k=50 kullanan bir modelden farklı bir sistemdir; farklı şablonlar, örnekleme ayarları ve motorlarla hizmet veren iki ajanı yan yana koyun, tablo artık modelleri değil kurulumları sıralıyor.
Genel metrikler yanlış soruyu yanıtlıyor: ROUGE ifadenin referansla örtüşüp örtüşmediğini, BERTScore iki cümlenin benzer anlam taşıyıp taşımadığını ölçüyor; faydalılık puanları ise çoğu zaman görevin tamamlandığını hiç doğrulamıyor. Arena.ai araç güvenilirliğini ve görev tamamlanmasını puanlıyor, ama bir kaybı yine de açıklayamıyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.