AI ajanları düzenlenebilir 3D sahneler oluşturur, ancak doğruluğu değerlendirmekte zorlanıyorlar
LEGO-Anything fotoğrafları düzenlenebilir Blender koduna dönüştürür; kıyaslaması, kodlama ajanlarının kullanılabilir sahneler oluşturabildiğini ancak geometriyi yanlış değerlendirdiğini gösteriyor.
Fotoğraftan düzenlenebilir Blender koduna
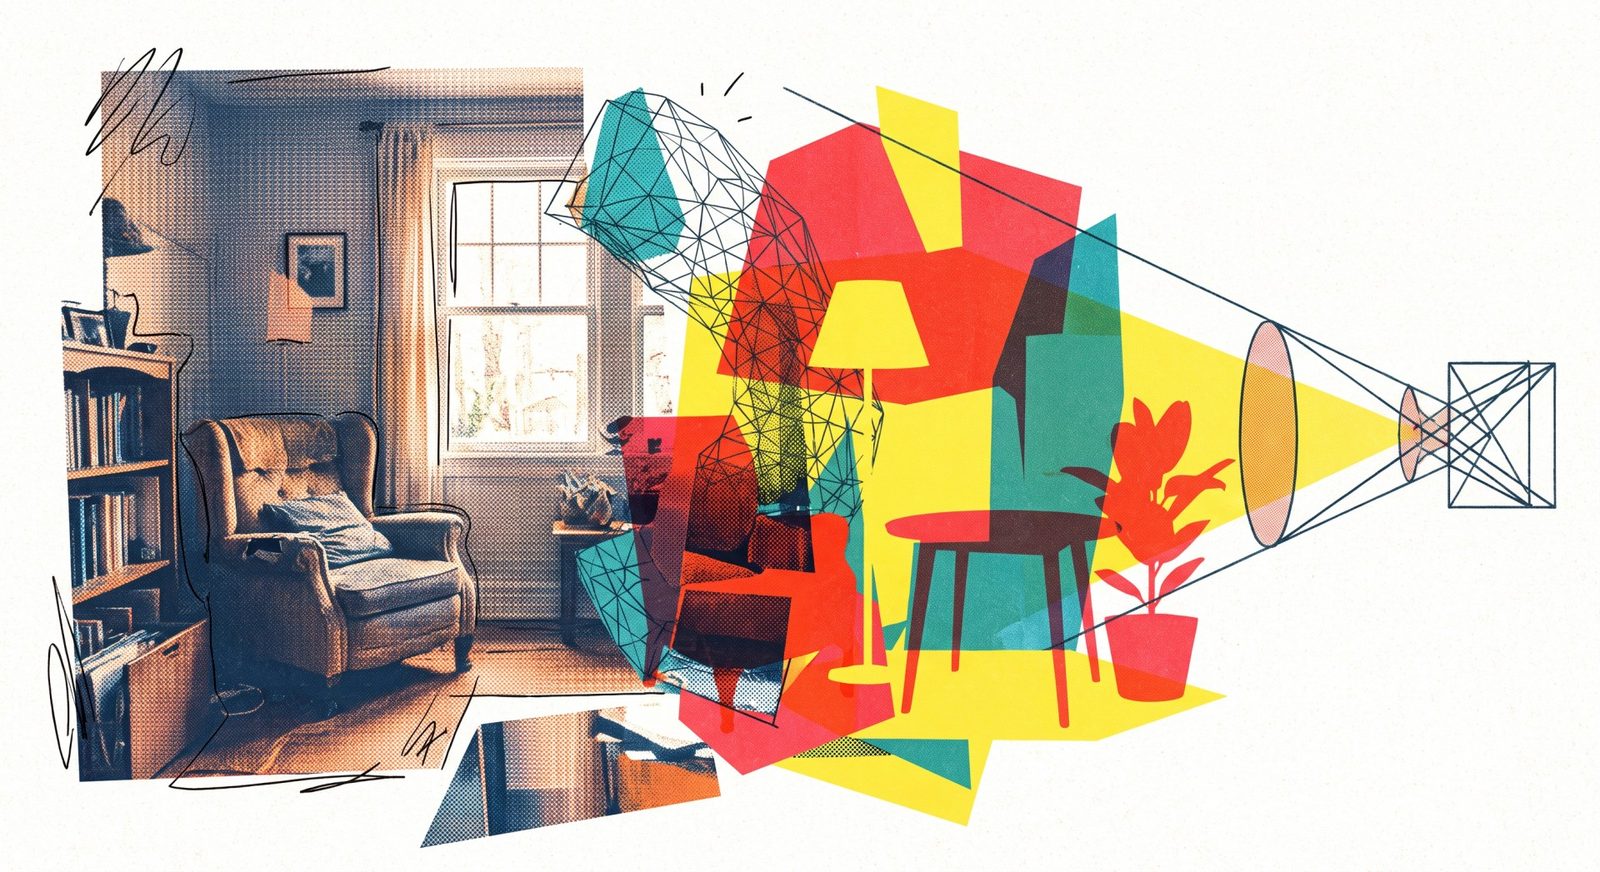
LEGO-Anything, Maryland Üniversitesi ve AWS araştırmacılarının bir projesi, tek bir fotoğrafı çalışılabilir Blender programına dönüştürmek için bir kodlama ajanı kullanır. Ajan kodu yazar, çalıştırır, sonucu kontrol eder ve sahneyi başlangıç görseline benzer olana kadar değiştirir.
Image-to-Code adlı yaklaşım yalnızca render edilmiş bir görüntüden daha fazlasını oluşturur. Nesneler, geometri, düzen ve kamera konumu programda açıkça temsil edilir; program çalıştırılabilir, görüntülenebilir, düzenlenebilir ve çıktı analiz edilebilir.
Simülatör referans verileriyle kıyaslama
Ekip, sonuçta elde edilen sahneleri değerlendirmek için LEGO-Bench'i sundu. 104 iç ve dış sahneden 208 görüntü içerir ve 443 kayıtlı eylem kullanır. Görseller profesyonelce kurulmuş simülatör sahnelerinden render edilir; bu, girdi verilerine doğal bir hiyerarşi kazandırır ve aynı zamanda referans gerçekliği olarak kesin geometriyi, derinliği ve nesne atamalarını korur.
Sahne zorluğu ışıklandırma veya kamera parametrelerini değiştirmeden artırılabilir. Kıyaslama geçerliliği, geometrik doğruluğu ve başlangıçla görsel benzerliği değerlendirir. Görünürlük, sunulan sahnenin yeniden render edilmesiyle ve referans görüntüyle piksel piksel karşılaştırılmasıyla ölçülür.
Kullanılabilir sahneler, zayıf geometrik değerlendirme
Test edilen altı GPT yapılandırmasının tamamı neredeyse her zaman çalışan bir sahne üretebildi, ancak doğrulukları geniş ölçüde değişiyordu. En iyi test edilen model olan GPT-6 Astra, iç sahnelerde %53,4 ve dış sahnelerde %39,6 oranında başarılı oldu. Bazı zayıf yapılandırmalar yaklaşık %15'e ulaştı. Doğruluk sahnenin karmaşıklığıyla birlikte düştü; dış sahneler iç mekânlardan daha zorlu çıktı.
Düşünce bütçesinin artırılması GPT-6 varyantlarını iyileştirdi. Ofis test alt grubunda Astra'nın puanı %32,3'ten %61,8'e yükseldi. Ajanların çalışmasının analizi kötü başlangıç denemelerini, revizyonlar sırasında erken ilerlemeyi silmeyi ve güvenilir olmayan öz değerlendirmeyi yaygın sorunlar olarak ortaya çıkardı. Araştırmacılar ayrıca Astra'nın geç revizyonun ardından %33,9'dan %4,4'e düştüğünü tespit etti.
Modellerden iki sürümden hangisinin başlangıça daha yakın olduğunu sorduklarında, geometrik değerlendirmeleri şans seviyesinin yakınına veya altına düştü. Araştırmacılar, iyileştirmenin ajanın kendi çıktısını değerlendirmesine değil, somut ölçümlere dayanması gerektiği sonucuna vardı.
Eklenti ve görüş sonrası testler
Elde edilen LEGO-Plugin ek eğitim gerektirmez. Başlangıç sahnesini referans görüntüye hizalar, öz değerlendirmeyi somut ölçümlerle değiştirir ve doğru ilerlemeyi regresif düzenlemelere karşı korur. Eklenti test edilen altı modelin tamamını iyileştirdi; zayıf ajanlar %62,7'ye kadar artış elde etti. En güçlü model yaklaşık iki puan kazandı.
Ekip ayrıca nesne tanıma, segmentasyon ve derinlik tahmini için girdi verileri olarak yeniden yapılandırılmış sahneleri test etti. Ek eğitim olmadan kullanılabilir ancak olağanüstü olmayan sonuçlar aldılar. Nesne tanıma en iyi performansı gösterdi ve uzmanlaşmış DINO modelinin sonucunun yaklaşık yarısına ulaştı. Uzmanlaşmış modellerle, SAM 3 ve Depth Anything 3 ile, segmentasyon ve derinlik tahmininde fark daha büyüktü. Araştırmacılar, mevcut kodlama ajanlarının perspektifli olduğunu, ancak henüz sadakatli yeniden yapılandırma için yeterince doğru sahne programları oluşturmadıklarını söyledi.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.