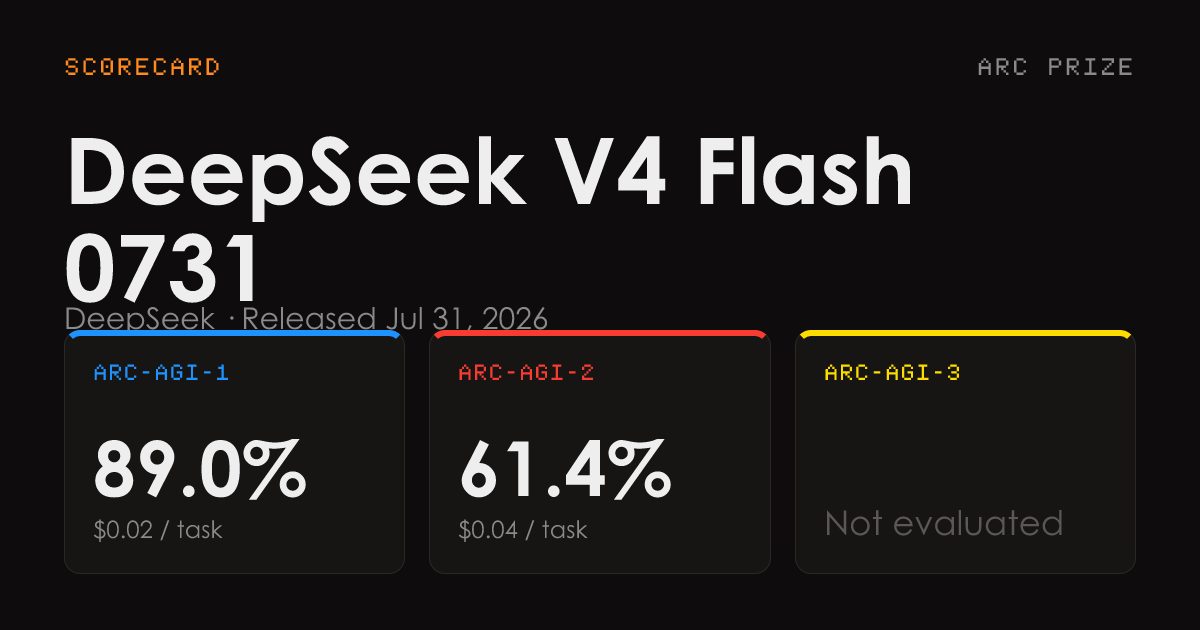
DeepSeek V4 Flash 0731, ARC-AGI-1'de %89 ve ARC-AGI-2'de %61,4 skor aldı
ARC Prize, DeepSeek V4 Flash 0731 için doğrulanmış sonuçları yayımladı: model, en yüksek akıl yürütme seviyesinde ARC-AGI-1 Semi-Private setinde %89,0, daha zorlu ARC-AGI-2'de %61,4 skor alıyor; görev başına maliyet 0,02–0,04 dolar.
Dört akıl yürütme seviyesi için doğrulanmış sonuçlar
ARC Prize, DeepSeek'in 31 Temmuz 2026'da yayımladığı model olan DeepSeek V4 Flash 0731 için doğrulanmış sonuçları açıkladı. Model, en yüksek akıl yürütme seviyesinde ARC-AGI-1 Semi-Private setinde %89,0, ARC-AGI-2 Semi-Private setinde ise %61,4 skor elde ediyor; görev başına maliyet sırasıyla 0,02 ve 0,04 dolar.
Skorlar, modele ayrılan akıl yürütme bütçesine göre değişiyor. "High" ayarında model ARC-AGI-1'de %87,0, ARC-AGI-2'de %56,0; "Low" ayarında ise %84,0 ve %46,0 seviyesine ulaşıyor. Akıl yürütme tamamen kapatıldığında performans %11,8 ve %2,1'e geriliyor.
Görev bazında döküm
Sonuç sayfası, ARC-AGI-2 kamu değerlendirmesini (Public Eval) tek tek bulmacalara kadar indiriyor: 120 görevin her biri için dört varyantta geçti/kaldı işaretleri gösteriliyor. Tablo düzensiz bir görünüm sergiliyor; bazı görevler yalnızca en yüksek çabayla çözülürken bazıları hiçbir ayarda çözülemiyor. Model için ARC-AGI-3 skoru listelenmiyor.
Fark neden önemli
ARC-AGI, eğitim verisini hatırlamayı değil yeni bulmacalar üzerinde soyut akıl yürütmeyi ölçmek için tasarlandı ve kıyaslamanın ikinci sürümü bilinçli olarak ilkinden daha zor. "None" ile "Max" satırları arasındaki fark — ARC-AGI-2'de %2,1'e karşılık %61,4 — sonucun ne kadarının çıkarım sırasındaki akıl yürütmeden, ne kadarının modelin temel yeteneğinden geldiğini doğrudan gösteriyor. Maliyet de hikâyenin parçası: ARC-AGI-2 görevi başına 0,04 dolar, güçlü bir skoru sıradan deney bütçelerinin erişiminde tutuyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.