NVIDIA Gizli Hesaplama, Blackwell'de AI çıkarım hızının %96'sını koruyor
NVIDIA'nın teknik bloguna göre TensorRT LLM, gizli hesaplama açıkken sekiz Blackwell B200 GPU üzerinde çıktı token üretkenliğinin %96,1-98,2'sini korudu ve şirket hangi çalışma zamanı varsayımlarının değiştiğini açıklıyor.
NVIDIA, gizli hesaplamanın (confidential computing) büyük dil modeli çıkarımını nasıl etkilediğini ve TensorRT LLM'in Blackwell GPU'larda şifreli çalışırken hızın büyük bölümünü nasıl koruduğunu anlatan teknik bir inceleme yayımladı.
Şifreli bellek çalışma zamanı varsayımlarını değiştiriyor
Gizli hesaplama, iş yüklerini belleği şifrelenmiş sanal makinelerde, gizli GPU'larda ve şifreli NVLink üzerinde çalıştırıyor. Ancak güvenli yürütme, çıkarım çalışma zamanının bellek hareketi, zamanlama, planlama ve çoklu GPU iletişimi konusundaki varsayımlarını değiştiriyor; çerçeve uyum sağlamazsa bu performansa mal oluyor.
Ek yükü görünür kılmak için ekip uzun giriş bağlamı, uzun üretim ve düşük eşzamanlılık seçti: TensorRT LLM'in PyTorch backend'inde DeepSeek-R1-0528-NVFP4, 32K giriş ve 1K çıkış tokenı, 1 ile 16 arası eşzamanlı istek, TP=8 ve FP8 KV önbelleği.
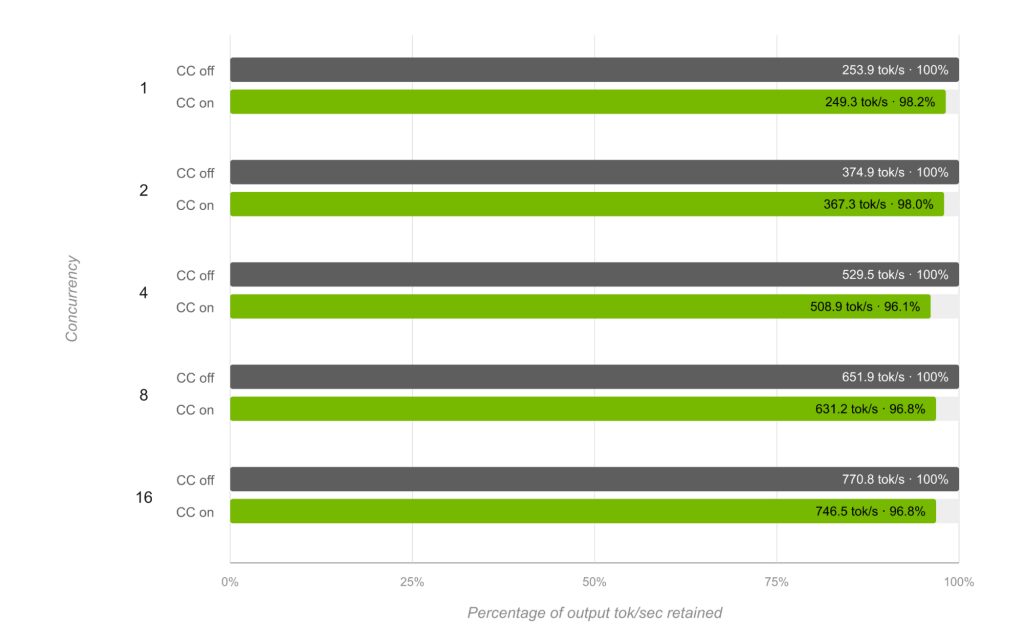
Üretkenliğin %96'sı korundu
Yalnızca gizli hesaplama durumu değişti; model, donanım, yazılım sürümleri, dizi uzunlukları ve eşzamanlılık sabit tutuldu. Test düzeneği: sekiz B200 GPU'lu bir NVIDIA DGX B200 sistemi, Intel TDX, CUDA 13.2, NCCL 2.30 ve TensorRT LLM 1.3.0rc22.
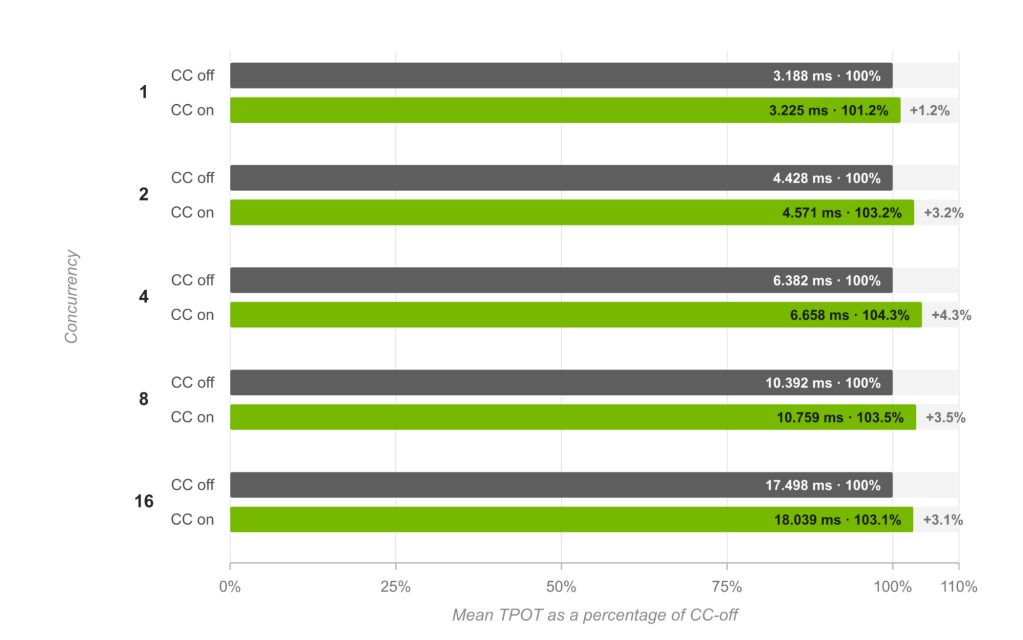
1 ile 16 arasındaki eşzamanlılık düzeylerinde gizli hesaplama açıkken çıktı token üretkenliğinin %96,1-98,2'si korundu; çıktı tokenı başına ortalama süre referansın %1,2-4,3 aralığında kaldı.
Çerçevenin uyarlanması gereken üç nokta
Host-device aktarımları yazılımsal şifreli bir bounce buffer üzerinden geçiyor, çünkü GPU korumalı CVM belleğine doğrudan erişemiyor. Bu yüzden pinned memory asenkron avantajını yitiriyor ve bazı kopyalamalar thread'i bloke edebiliyor; TensorRT LLM bellek türünü gizli hesaplamayı gözeterek seçiyor ve token okumalarını asenkron bir worker'a taşıyor (PR #11573).
Kernel otomatik ayarlayıcısı taktikleri CUDA events ile karşılaştırıyor, ancak gizli hesaplama altında zamanlama sinyali kararsız çıktı; artık GPU'nun %globaltimer'ını kullanıyor (PR #11657). NVLink SHARP multicast B200 gizli yapılandırmalarında bulunmuyor; çerçeveler NVLS kullanılabilirliğini saptayıp mesaj boyutuna uygun algoritmalar seçmeli.
Kendi iş yükünüzü ölçün
NVIDIA'nın önerisi, güvenlik yapılandırması ile çıkarım optimizasyonunu tek bir dağıtım sorunu olarak ele almak: gizli hesaplamayı açın, ortamı attest edin ve hizmet vereceğiniz iş yüküyle açık ve kapalı ölçümleri karşılaştırın.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.