Homelab Meraklısı İki RTX 3090 ve Optane ile 2,8T Kimi Modelini 3,11 t/s Hızında Çalıştırdı
İkinci nesil Optane yapısına iki RTX 3090 ekleyen homelab meraklısı, 2,8 trilyon parametreli Moonshot Kimi K3 modelini saniyede 3,11 token hızında çalıştırdı; modelin neredeyse yarısını RAM sürücüsüne taşımak üretimi yaklaşık %41 artırdı.
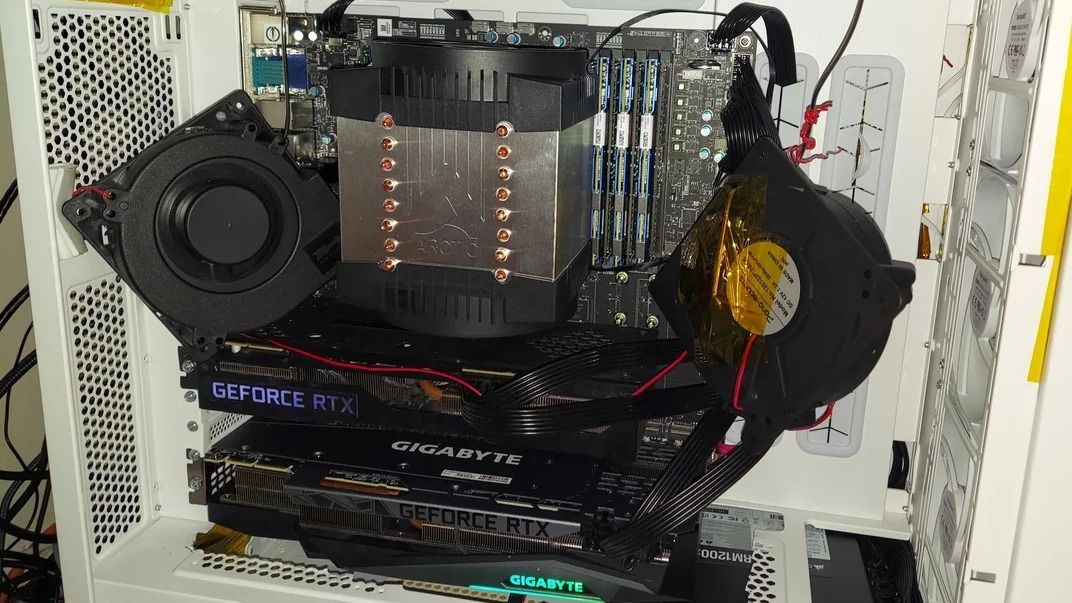
Bir homelab meraklısı, ikinci nesil bir Optane yapay zekâ yapısındaki iyileştirmeleri takip Reddit gönderisinde ayrıntılı biçimde anlattı ve iki RTX 3090 ekleyerek 2,8 trilyon parametreli Moonshot Kimi K3 modelini saniyede 3,11 token hızında çalıştırdı. Modelin neredeyse yarısını bir RAM sürücüsüne taşımak üretimi yaklaşık %41 ve istem değerlendirmesini yaklaşık %26 artırdı. Optane bellek çok ısındığı için yapının hâlâ ek fanlara ihtiyacı var.
RAM sürücüsüyle ve sürücüsüz performans
Her iki GPU ile, ancak RAM sürücüsü olmadan yapı, üretimi saniyede 2,20 token ve istem değerlendirmesini saniyede 13,3 token hızında çalıştırdı. 94 shardın 45'i veya 865 GB modelin 414 GB'si tmpfs RAM sürücüsünde, geri kalanı Optane'de iken üretim saniyede 3,11 tokena ve istem değerlendirmesi saniyede 16,8 tokena ulaştı. Yapı sahibinin ölçümleri Optane kısmı için DAX açık olacak şekilde llama.cpp kullandı.
Sistem belleğini disk gibi görünen sözde kalıcı olmayan bir şekilde ekstra hızlı performans için ayıran meraklılar için böyle bir düzen yeni değil, ancak günümüzde herkesin bu kadar boş RAM'i yok.
GPU'lar ve bellek nasıl kullanılıyor
İki RTX 3090'un her birinde 24 GB VRAM var, toplam 48 GB; bu 865 GB model dosyasının yaklaşık %5,5'i, dolayısıyla modeli tutmuyorlar. Model, 896 uzmandan oluşan bir mixture-of-experts türüdür; token başına 16 uzman seçiliyor, ayrıca iki paylaşılan uzman var ve 2,8 trilyon arasından 104 milyar aktif parametre var. Yönlendirilmiş uzman tensörleri CPU tarafında, Optane ve RAM sürücüsünde kalıyor; RTX 3090'lar ise dikkat mekanizmasını, yoğun ileri besleme ağ katmanını, paylaşılan uzmanları, diğer aktif-yoğun bileşenleri, KV önbelleğini, saklanan konuşma bağlamını ve GPU hesaplama tamponlarını işliyor.
DRAM, VRAM'dan daha yavaştır, ancak yine de makul bir hız artışı sağlayabilir ve GPU'larla hız, orijinal yapım konusunda saniyede 2 ile 4 token arasında tahmin yapan yapı sahibinin beklediği aralıktaydı.
Model boyutu ve kuantizasyon
2,8 trilyon parametrenin tamamı 16 bit hassasiyette yaklaşık 5,6 TB yer kaplardı. Moonshot'un kendi sürümü 4 bit MXFP4 formatı kullanıyor ve yaklaşık 1,56 TB'a geliyor; burada kullanılan Q2_K dosyası ise modeli parametre başına ortalama 3 bitin altında olacak şekilde 865 GB'ye küçültüyor. Rapor, 865 GB değerinin muhtemelen gibibayt cinsinden olduğunu, ancak homelab meraklısının yazdığı GB değerlerini kullandığını belirtiyor.
Soğutma ve gelecek planlar
GPU kurulumu kısmen kasa değişikliklerini bekledi; bu değişiklikler metal kesmeyi ve GPU'lar ile soğutmalarına yer açmak için güç kaynağını yeniden konumlandırmayı gerektirdi. Soğutma hâlâ önemli bir sorun ve Optane DIMM'ler için iki 12W üfleyici fan, çift 350W sınıfı GPU ile birlikte bile yerinde tutuluyor. Yapı sahibi “özelleştirilmiş kuantizasyon” dahil daha fazla iyileştirme görüyor; bu yöntem, avukat Nick Mermiges'in kullandığı tekniklere benzer olabilir. Yapı sahibi ayrıca hızın tek başına yeterli olmadığını, çıktı kalitesinin de dikkate alınması gerektiğini belirtiyor.
Kaynaklar: Tom's Hardware
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.