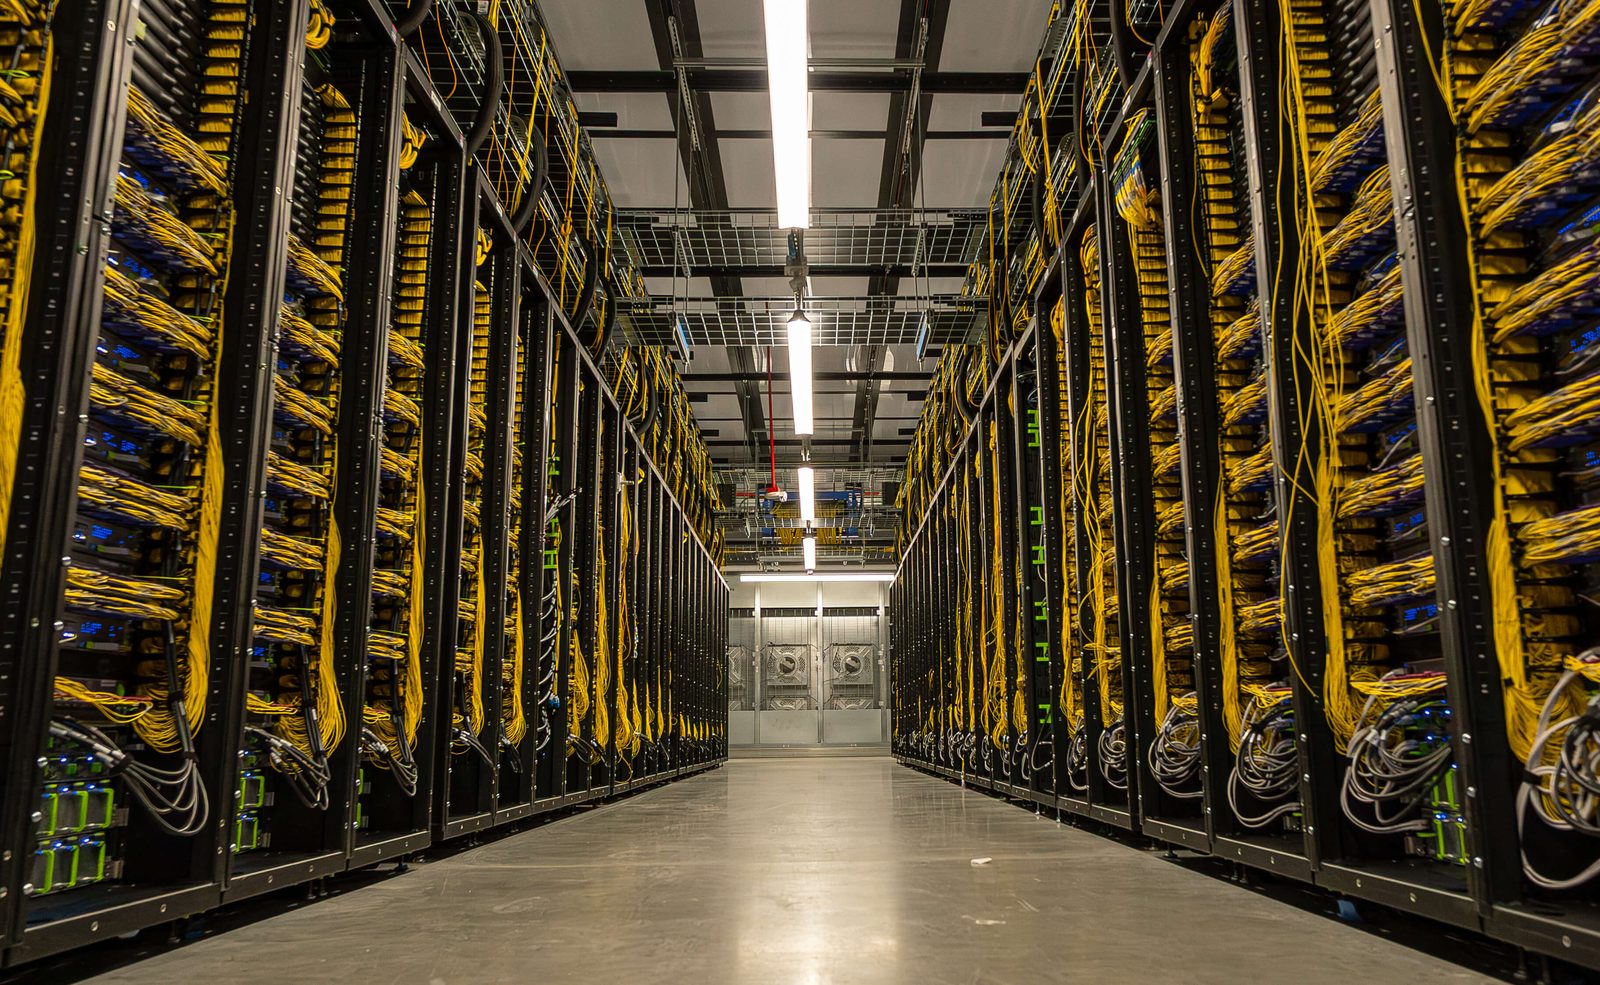
Prometheus'un İçinde: New Albany'deki Meta'nın Gigawatt Ölçekli Yapay Zekâ Süperkümesi
Meta'nın New Albany, Ohio'daki Prometheus süperkümesi ilk aşamasını tamamladı; yüz binlerce GPU üzerinde Muse ailesinin temel modellerini eğitiyor ve yaklaşık bir milyon GPU'ya ölçeklenmesi planlanıyor.
Meta, New Albany, Ohio'daki veri merkezi tesisinde gigawatt ölçekli yapay zekâ süperkümesi olan Prometheus'un ilk aşamasını tamamladı. Tesis, iki yıl önce geleneksel bir web trafiği veri merkeziydi ve şimdi Muse ailesi de dahil öncü temel modellerin eğitimine ev sahipliği yapıyor.
Bir Milyon GPU Ölçeği
Prometheus, birçok birbirine bağlı bina genelinde yüz binlerce GPU'dan oluşur ve millerce fiber optik ile bağlanarak tek bir makine gibi çalışır. Tam ölçekte yaklaşık bir milyon dağıtık GPU'dan oluşacaktır. Sistem şu anda iki NVIDIA platformunu çalıştırıyor; Vera Rubin NVL72 tabanlı üçüncü bir platform yakında eklenecek. GB200 NVL72 tabanlı Catalina, 72 GPU, 13.4 TB HBM3e ve 720 tepe PFLOPS FP8 hesaplama kapasitesi sunar; GB300 tabanlı Clemente ise GPU başına belleği 288 GB'ye çıkarır ve tepe FP4 hesaplama kapasitesini bir exaFLOP'u aşar.
Ağ ve Güvenilirlik
Standart veri merkezi ağının ötesinde, özel bir Ethernet Back-End ağı binalar içinde ve binalar arasında doğrudan GPU'dan GPU'ya iletişimi sağlar. Bina düzeyi ağ dokuları 20,736 GPU'ya kadar birbirine bağlar; Backend Aggregation ağı ise birden fazla Pbps bölgesel bant genişliğiyle 2 km'den 100 km'yi aşan bir alana yayılıyor. Meta, ön eğitim çalıştırmalarında %85'in üzerinde, pekiştirmeli öğrenme çalıştırmalarında ise %90'ın üzerinde goodput bildiriyor; firmware düzeltmeleri kesintiler arası ortalama süreyi yaklaşık 47,000 GPU saatten 54,000 GPU saatin üzerine çıkarıyor.
Kararlılık Mühendisliği
Kesintiler 2025 ortasında günde 8K GPU başına yaklaşık 1,000 olayla zirve yaptı; bir yıllık işlevler arası çalışma bu oranı %99 azalttı. Hedeflenmiş düzeltmeler, 600,000'den fazla bağlantıda NVLink sinyal bütünlüğünü, HBM ve LPDDR bellek arızalarını, anahtar sağlığını ve backend ağ olaylarını ele aldı. Her 72 GPU'lık NVL72 etki alanı, sekiz raf içi yedek ile 64 GPU'lık bir dilimi çalıştırır; arıza kurtarma ise paralellik duyarlı arıza toleransını eşzamansız dağıtılmış kontrol noktalarıyla birleştirir. 30-40% aralığındaki güç geçici dalgalanmaları, raflardaki piller ve tesis enerji depolaması destekli Dynamo Dimmer sınırlandırma çerçevesi tarafından yönetilir; hava destekli ve tesis sıvı soğutmanın bir karışımı heterojen filoyu destekler.
Kaynaklar: Engineering at Meta
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.