Ai2, trilyon parametreye kadar ölçeklenebilir MoE modelleri için Olmo-core 3'ü yayınladı
Ai2, MoE modellerinin eğitimini trilyon parametreye kadar ölçeklendiren açık kaynaklı Olmo-core 3'ü yayınladı. Bir kıyaslamada uzman havuzu 8'den 128'e çıkarıldı, eğitim verimliliği ise %5'in altında kaldı.
Ai2 (Allen Institute for AI), 1 Ekim'de Olmo-core 3'ü yayınladı. Bu, yeniden tasarlanmış MoE (uzman karışımı) eğitim sistemine sahip açık çerçevesinin güncellemesidir. Enstitünün açıklamasına göre, trilyon parametreye kadar ölçeklendirilmesi planlanmış ve bir sonraki nesil Olmo'nun temel sistemlerinden biri olacak.
MoE modeli her veri için yalnızca bir kısmını kullanır, ancak tüm modelin saklanması ve verilerin doğru uzmanlara yönlendirilmesi boyutla birlikte büyüyen maliyetler yaratır.
Olmo-core 3 ne değiştiriyor
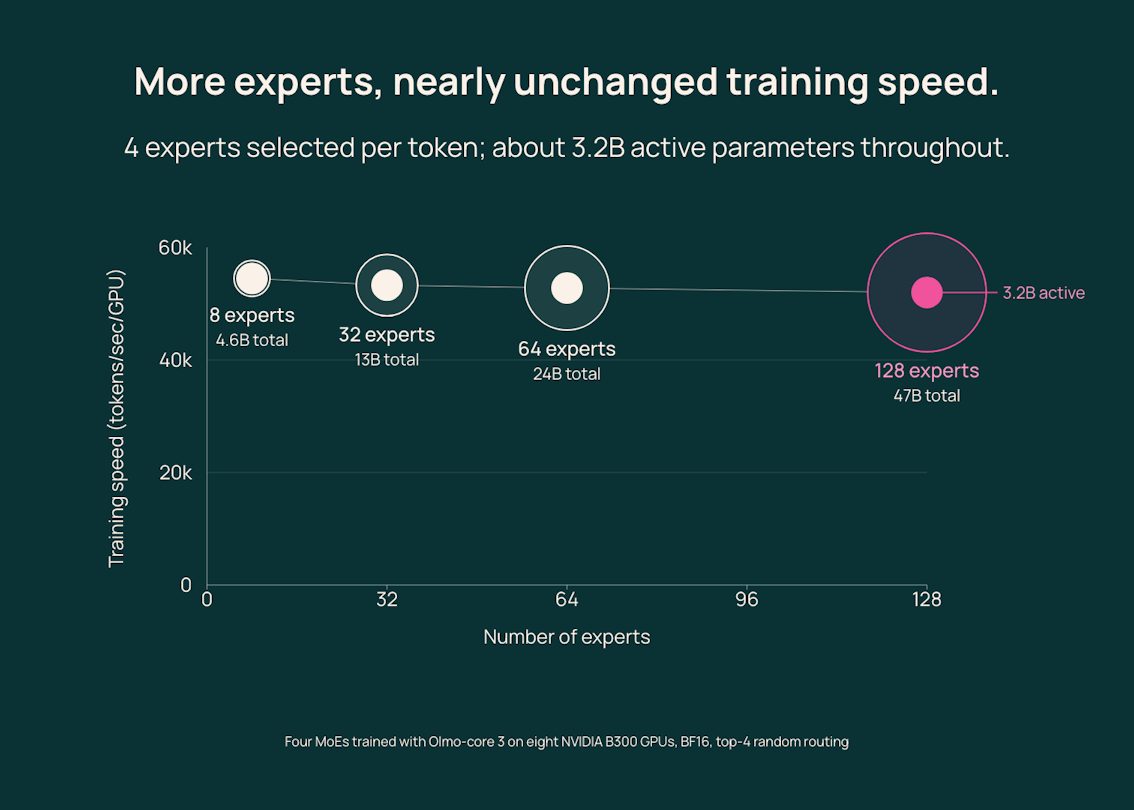
Bir kıyaslamada uzman havuzu 8'den 128'e çıkarıldı, her token için yine dört uzman seçildi, aktif parametre sayısı token başına yaklaşık 3,2 milyar seviyesinde kaldı. Toplam parametre kapasitesi 4,6 milyardan 47 milyara yükseldi, verimlilik ise %5'in altında kaldı.
Eski sürüm tamamen shard'lanmış veri paralelliğini (FSDP) kullanıyordu, Olmo-core 3 ise dağıtılmış veri paralelliği (DDP) şemasına geçti: uzmanlar GPU'larda kalır, veriler onlara yönlendirilir.
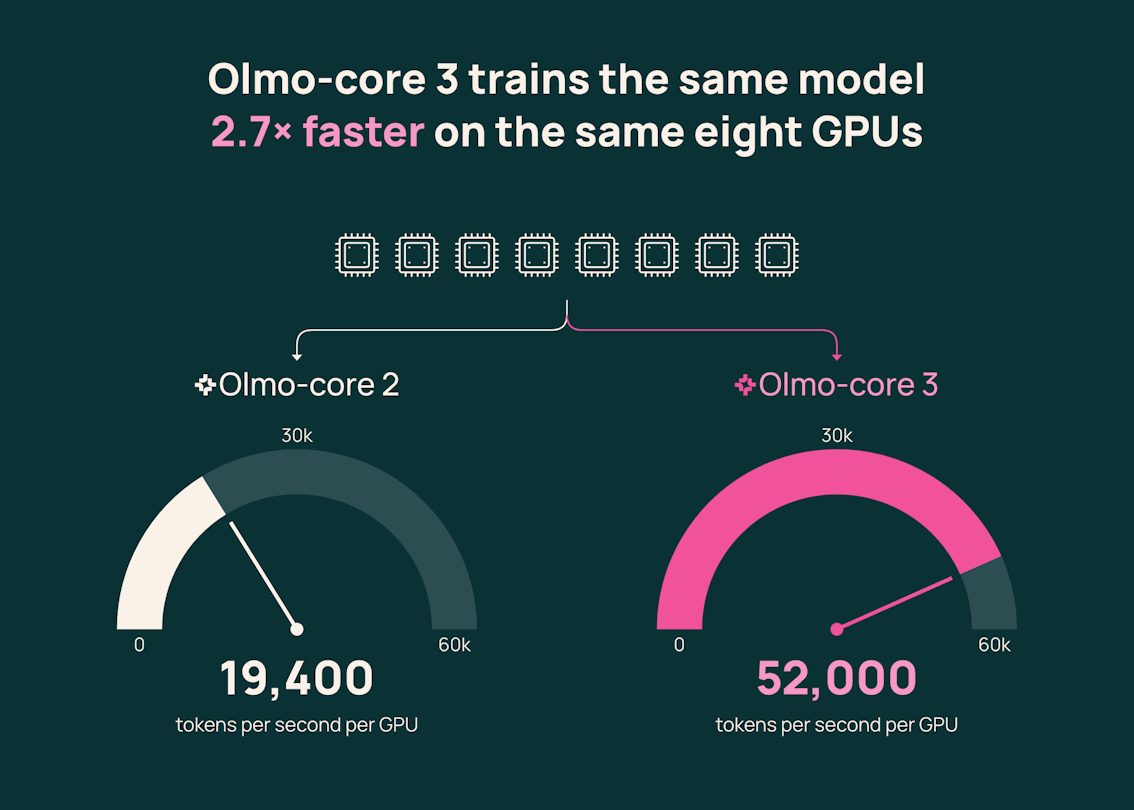
NVIDIA'nın sekiz B300 GPU'sunda 47 milyar parametreli MoE modeli yeni sistemle GPU başına saniyede 52 000 token işledi, eski sürümle 19 400, yani yaklaşık 2,7 kat daha fazla.
Trilyon parametreye kadar ölçeklendirme
Olmo-core 3, modelleri donanım üzerinde uzman ve pipeline paralelliği ile dağıtılmış optimize ediciye göre böler. Meta veriler GPU'larda kalır, yönlendirilmiş veriler doğrudan uzmanın tamponuna girer, gruplandırılmış GEMM ise küçük hesaplamaları birleştirir.
Sistem ayrıca düşük hassasiyetli format olan MXFP8'i destekliyor: dört B300 GPU'da BF16 ile karşılaştırıldığında yaklaşık %21 daha fazla verimlilik gösterdi, zirve aktif bellek ise 103 GiB'den 95 GiB'ye düştü.
Ai2 ayrıca 512 GPU'da 1,2 trilyon parametreli modeli test etti, burada token başına 58,36 milyar parametre aktifti; maksimum verimlilik GPU başına 858 TFLOP/s idi. Testler rastgele yönlendirme ile sistemin performansını ölçtü, modelin kalitesini değil; DeepEP v2 deneyi kısa bir testte 2,38 trilyon parametreye ulaştı.
Açık altyapı
Bir sonraki nesil Olmo, MoE mimarisini kullanacak ve en güçlü Olmo olacak, en büyük veri kümesiyle eğitilecek ve en uzun bağlama sahip olacak. Sistem tamamen açıktır: araştırmacılar kendi MoE modellerini bununla eğitebilir ve başka donanımlara adapte edebilir; teknik rapor, kod ve interaktif demo zaten erişilebilir durumda.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.