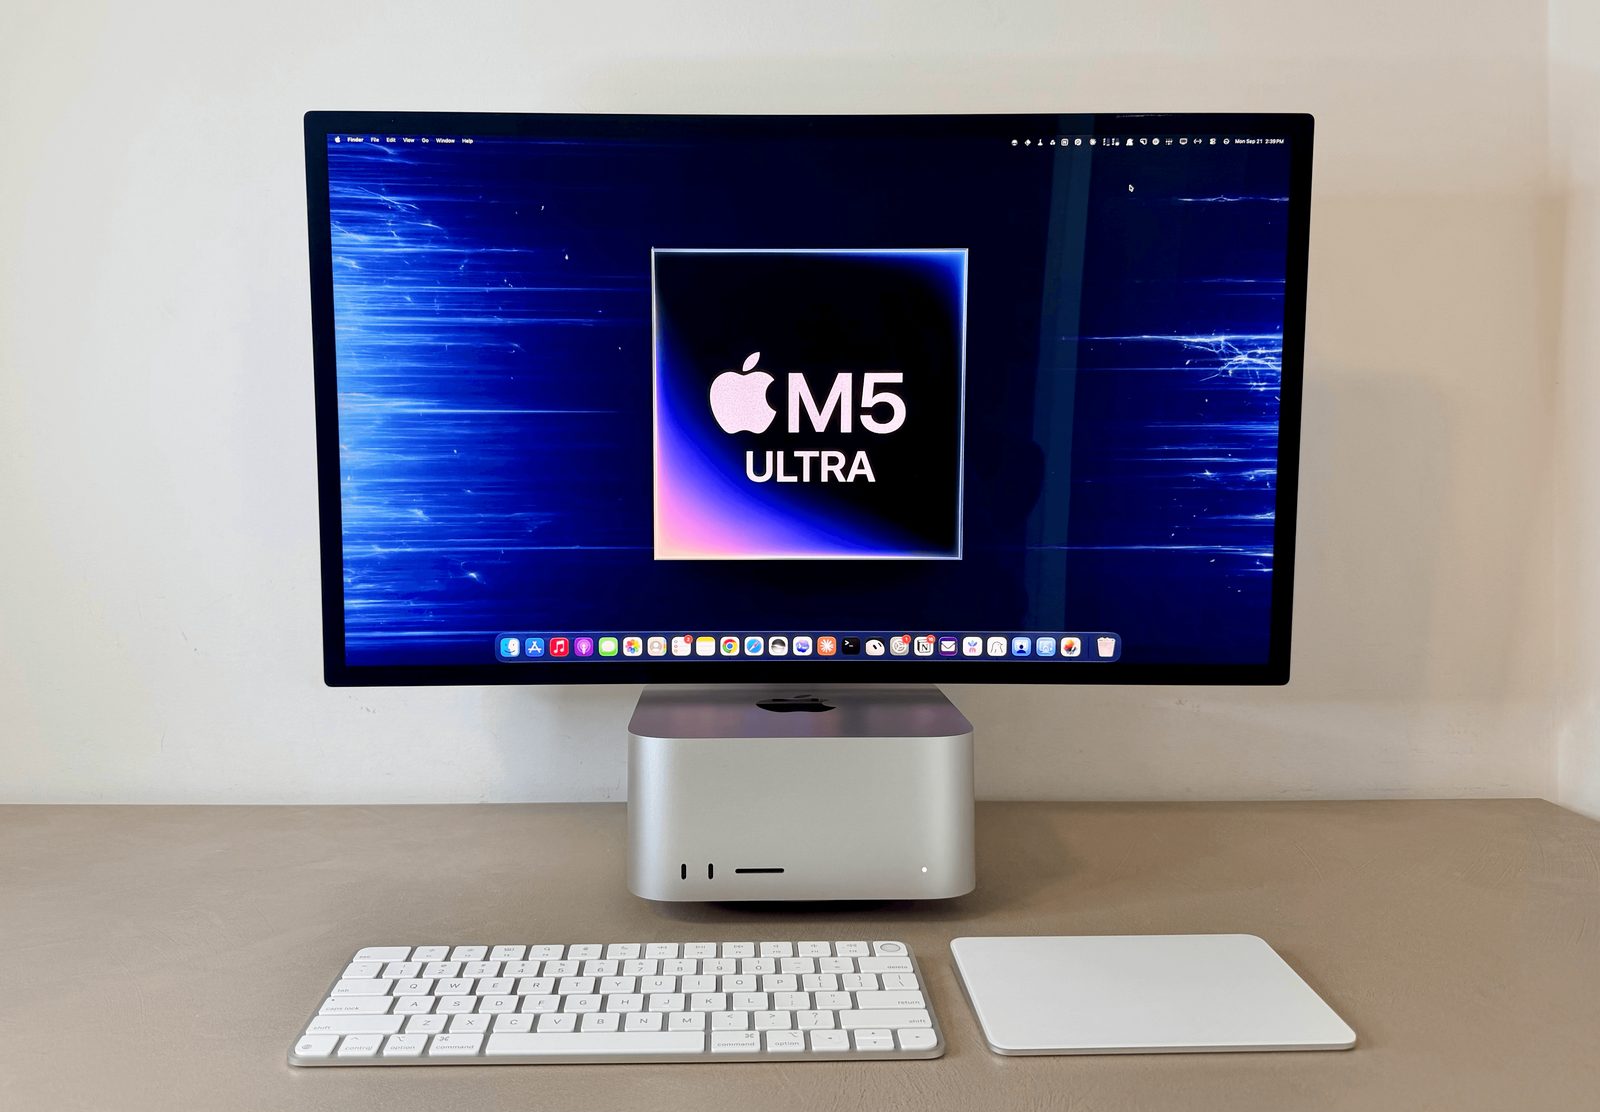
M5 Ultra Mac Studio incelemesi: yerel yapay zeka ajanları için sıçrama
MacStories, 256 GB'lık M5 Ultra Mac Studio'yu dört gün boyunca M3 Ultra ve RTX 5090'lı bir PC ile karşılaştırdı. İncelemeye göre istem işleme ortalama %150 arttı ve bu, yerel ajanları pratik hale getiriyor.
MacStories, Apple'ın masaüstü Mac serisinin bugünkü en üst modeli olan M5 Ultra Mac Studio'nun incelemesini yayımladı. Yazar Federico Viticci, 256 GB bellekli sürümü dört gün boyunca bir önceki M3 Ultra (512 GB) ve içinde RTX 5090 bulunan oyun bilgisayarıyla karşılaştırdı. Vardığı sonuç: bu, yerel yapay zeka asistanlarını deneysel olmaktan çıkarıp pratik hale getiren ilk Mac.
Değişmeyen kasada yeni mimari
M5 Ultra dışarıdan yerini aldığı M3 Ultra'ya tıpatıp benziyor, ancak silikonu yeni: Apple, UltraFusion ile çift kalıplı iki M5 Max yongasını dört kalıplı bir yapıda birleştiriyor; bu şirket için bir ilk. GPU'da, her biri bir Neural Accelerator ile eşleştirilmiş 80 çekirdek var ve bu, AI için en yüksek hesaplama gücünü M3 Ultra'nın 4,5 katına kadar çıkarıyor. MLX tabanlı yerel modellerin dayandığı birleşik bellek yine 256 ve 512 GB olarak sunuluyor; bant genişliği ise 819 GB/s'den 1,2 TB/s'ye, yani %50 artışla yükseldi. 512 GB'lık modelin ekim sonunda çıkması bekleniyor.
Ölçülen kazanımlar
macOS 27 üzerinde oMLX 0.7.0.dev2 ve Qwen3.8-Flash-Next ile yapılan dört günlük testlerde istem işleme ortalama %150 arttı; bu, yazarın önceki kurulumuna kıyasla yaklaşık 2,5 kat demek. 16 bin tokenlık bir istem saniyede 2.887 token hızıyla okundu; M3 Ultra'da bu sayı 1.143'tü. Aynı karşılaştırmada üretim hızı yaklaşık %70 yüksekti ve grafikler, bağlam 4K'dan 256K'ya büyürken hızın saniyede 91 tokendan 75'e düştüğünü gösteriyor. Soğuk önbellekle 256K'lık bir istemde M3 Ultra ilk görünür token için yaklaşık 245 saniye beklerken M5 Ultra 102 saniyede yanıt verdi. Aynı anda üç istekte (her biri ~6,5 bin token) yeni makine toplamda saniyede 81,5 token üretti; bu, tek isteğe göre %23 fazla. M3 Ultra ise yalnızca %4 kazandı.
RTX 5090 hâlâ önde, ama sınırlarıyla
NVIDIA'nın kartı, model belleğine sığdığı sürece daha hızlı: 6.000 tokenlık istemde saniyede yaklaşık 3.000 token okudu, M5 Ultra ise yaklaşık 1.700'de kaldı; 1,79 TB/s ile 1,2 TB/s arasındaki fark üretimde %25'lik bir üstünlük sağlıyor. Kartın tavanı 32 GB VRAM: 8 bitlik dikkat önbelleğiyle uzun bağlamları 64K, 128K ve 256K'da saniyede 49,6, 40,4 ve 30 tokenla tamamladı; ancak PCIe üzerinden sistem belleğini ödünç alması gerektiğinde bu hızlar 4,6, 2,9 ve 1,5'e düştü. Yazar ayrıca PC'nin çok daha büyük, gürültülü ve sıcak olduğunu, Mac Studio'nun fanının ise normal yerel model kullanımında duyulmadığını belirtiyor.
Yerel ajanlar yazar için neden önemli
Viticci'nin ilgisi pratik. Yaz aylarındaki iOS ve iPadOS 27 incelemesinin araştırma altyapısı, 310 belgeden oluşan bir projede 99 gün boyunca kesintisiz çalışan ajanlara dayanıyordu ve toplam maliyeti 0 dolardı; ona göre bu iş yükü bulut API'leriyle sürdürülemezdi. Yerel modeli iOS'taki Open Minis uygulamasında varsayılanı yaptı. 256 GB'lık sürümde 5 bitlik nicelemeyi en iyi denge olarak görüyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.