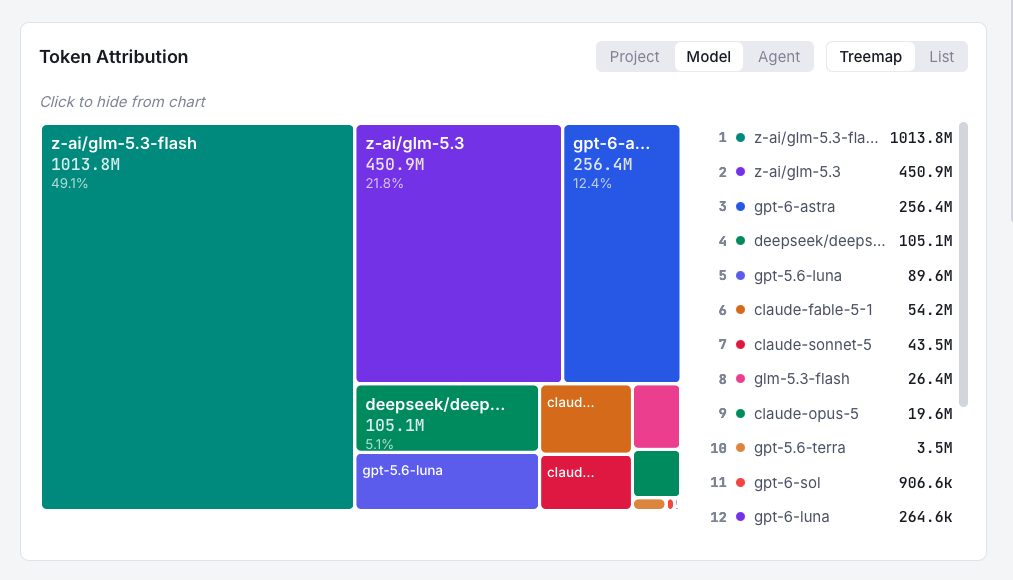
Bir aylık GLM 5,3 Flash denemesi %50 kullanımla tamamlandı
Bir aylık deneme, tüm AI işleri için GLM 5,3 Flash kullanımını hedefledi; hedef model yalnızca 2B tokenin yarısını işledi. Testler ayrıca prototip maliyetlerini, sağlayıcı sınırlarını ve verimliliğin ölçülmesinin önemini ortaya koydu.
Kullanım dağılımı ve prototip maliyetleri
Eylül ayında tek etkili açık modelle yürütülmeyi planlayan deney, %50 sonuçla tamamlandı. 2B tokenin yalnızca 1B'si GLM 5,3 Flash ile işlendi; model ayın ilk yarısında tüm işleri tamamlamasına rağmen rapor edilen kullanımı $68 bütçede kaldı, yaklaşık 4kWh enerji ve 365 gram karbon emisyonuyla. İkinci yarıda diğer modellere 1B token harcandı.
Şaşırtıcı bir durum, deneysel Wagtail MCP sunucusuyla ilgiliydi; bunu vibe-coded prototipi olarak tanımlıyorlar. Model seçimi, tek gecede yaklaşık 450M token, $150 ve 5kWh enerji harcamasına yol açtı. Sunucu iyi çalıştı ve yeteneklerini gösterdi, ancak ekip benzer sonuçların beşte birinden daha az ekstra çabayla elde edilebileceğini değerlendirdi. Bu olay, deneyler için bütçe ayırmanın ve modellerin dikkatli seçiminin gerekliliğini bir kez daha doğruladı.
Altyapı erişilebilirliği
Sağlayıcıların erişilebilirliği de bir sorundu. Ekibin kullandığı çıkarım sağlayıcıları sık çalışıyordu, ancak popüler seçenekler büyük laboratuvarların gücüne sahip değildi. GLM 5,3 Flash, muhtemelen ekibin işinin Pareto ön cephesinde yüksek olduğu için düşük performans gösterdi. Uygun seçenekler ayrıca Avrupa veri merkezlerinde barındırılan açık modellerle sınırlıydı. Bu durum, DeepSeek V4,1 Flash ve Qwen 3,8 Flash gibi benzer modellere geçişe neden oldu; bu basit bir değişiklikti ve önceden beklenmiyordu.
Rutin geliştirme için değer
Tek modelin rutin mühendisliğe sokulması, çok yönlü tekliflerin test edilmesini ortadan kaldırmadı. Ekip, Wagtail görevlerinde model kıyaslamalarına başlıyor ve ajan yetenekleri için daha hafif seçenekleri ve ajanlarla iyi çalışan yeni bir CLI prototipini önerebilecek karşılaştırılabilir verilere ihtiyaç duyuyor.
GLM 5,3 Flash, 1M token bağlam penceresi, görsel destek ve birden fazla sağlayıcıda erişilebilirlik nedeniyle yine de üretim işleri için iyi değerlendirildi. Wagtail ve bunun üzerine kurulu sitelerde, UI görevlerinde, AI araştırması ve geliştirmede, dokümanda ve değerlendirmelerde kullanıldı.
Sonraki test için dersler
Ekim ayında deneme yalnızca rutin üretim işlerinde devam edecek, araştırma ve geliştirmede değil. Planlı değişiklikler; token kullanımı, enerji tüketimi, maliyetler ve belirli sonuçlar için sürekli yerel raporlamayı içeriyor. Ekip ayrıca deneyler için ayrı bütçeler belirlemeyi, prompt seçimini iyileştirmeyi, rol tabanlı çok ajanlı iş akışlarını kullanmayı ve etkili modellerin testlerini sürdürmeyi planlıyor.
Daha geniş hedef, AI çıkarım işinin büyük bölümünün bir veya iki ucuz flash düzeyi modelden geçmesi; ilerlemenin ise yalnızca token sayısıyla değil, maliyet veya enerji tüketimiyle de değerlendirilmesi. Ekip ayrıca Jev tarzında karar modellerinin difüzyon modellerine, daha yeni flagman modellerinin doğru bir yön adımı görünüp görünmediğine bağlı olarak bakacak.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.