Ai2, açık ağırlıklı AstaBrief 8B modelini yayınladı: Bilimsel raporları 3,5 kat daha hızlı hazırlıyor
Ai2 (Allen Institute for AI), açık ağırlıklı AstaBrief 8B modelini yayınladı: Araştırma sorusundan ve taranan literatürden alıntılı rapor hazırlıyor ve Fast mode'da ortalama 51,1 saniyede çalışıyor, Thinking mode'dan 3,5 kat daha hızlı.
Allen Institute for AI (Ai2), 2 Ekim'de açık ağırlıklı AstaBrief 8B modelini yayınladı. Model, araştırma sorusu ve taranan literatür bölümlerinden alıntılı rapor hazırlıyor ve Asta'da şu anda Fast mode olarak, Thinking mode ile birlikte çalışıyor.
Tam boru hattında Fast mode bir raporu ortalama 51,1 saniyede hazırlıyor, Thinking mode'un 178,5 saniyesine karşılık, yani yaklaşık 3,5 kat daha hızlı. Model raporu tek geçişte yazıyor ve özetleme ve kümeleme aşamalarını atlıyor; Ai2'ye göre kalite düşmedi.
Bilimsel raporlar için açık model
AstaBrief 8B, Qwen3-8B temelli sekiz milyar parametreli bir modeldir. Ai2 araştırmacıları temel olarak post-training verileri ve değerlendirme üzerinde çalıştı. Açık ağırlıklar, enstitülere modeli kendi altyapılarında, güvenlik duvarının arkasında çalıştırma imkanı veriyor, bu da hassas araştırmalar için önemlidir.
Model nasıl eğitildi
AstaBrief iki aşamada eğitildi: supervised fine-tuning (SFT) ve direct preference optimization (DPO). Ai2, pahalı ve kararsız RL yaklaşımı yerine daha basit bir yol seçti. Antrenman soruları gerçek kullanıcı kayıtlarından alındı: filtreleme sonrası 90 bin araştırma sorusu kaldı.
SFT için hedef raporları ScholarQA boru hattı oluşturdu (Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, GPT-4.1); filtreleme sonrası 47 bin örnek kaldı. DPO için çiftleri iki hakem modeli karşılaştırdı (GPT-4.1 ve DeepSeek-R1), nihai sette ise 6 bine kadar örnek var. Dört istatistiksel filtreden en fazla kazanç düşük alıntı yoğunluğuna sahip örneklerin elenmesini sağlayan filtreyle elde edildi.
Sonuçlar ve kullanım
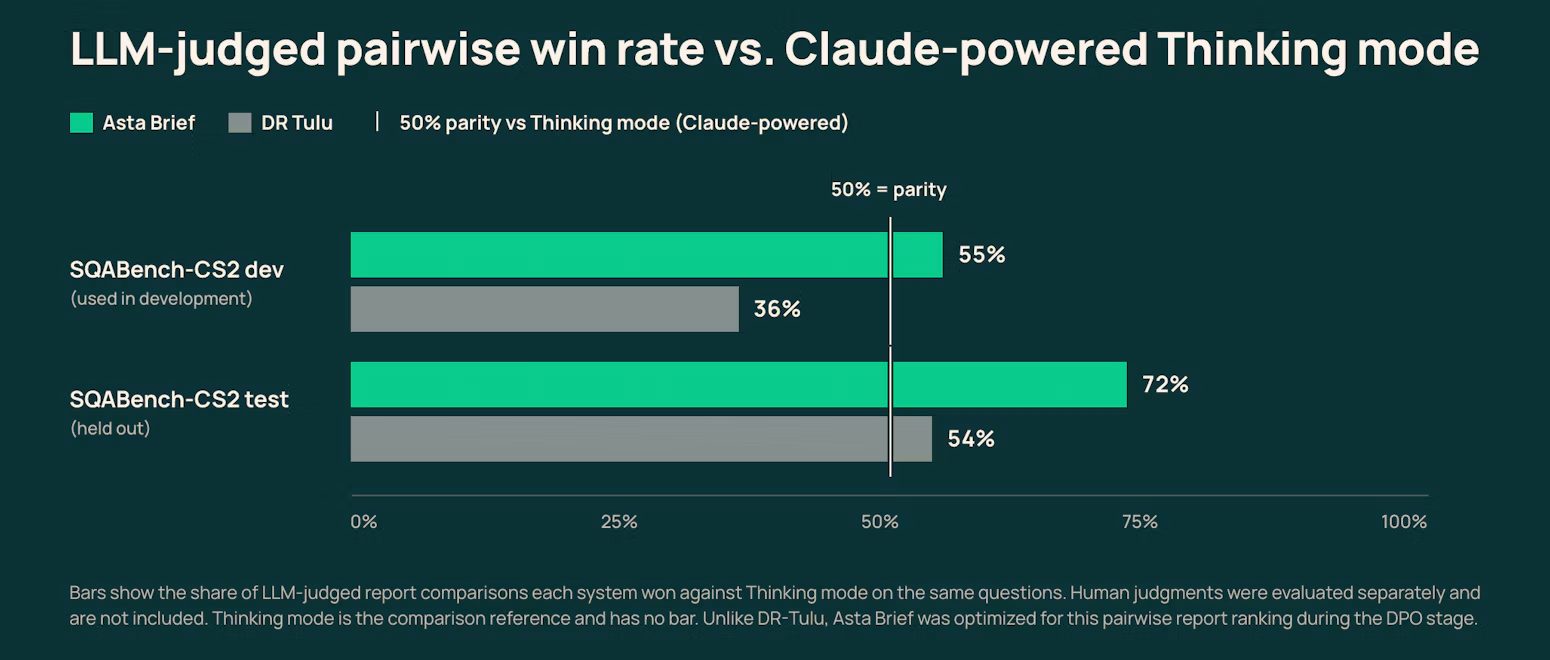
Değerlendirmenin ana hedefi SQABench-CS2'ydi: bilgisayar biliminden 200 soru. Rubrik puanı, yanıt doğruluğu, alıntı doğruluğu ve hata oranı ölçüldü; ayrıca DeepScholarBench'de (63 soru) test edildi ve 14 soruluk insan değerlendirmesi yapıldı.
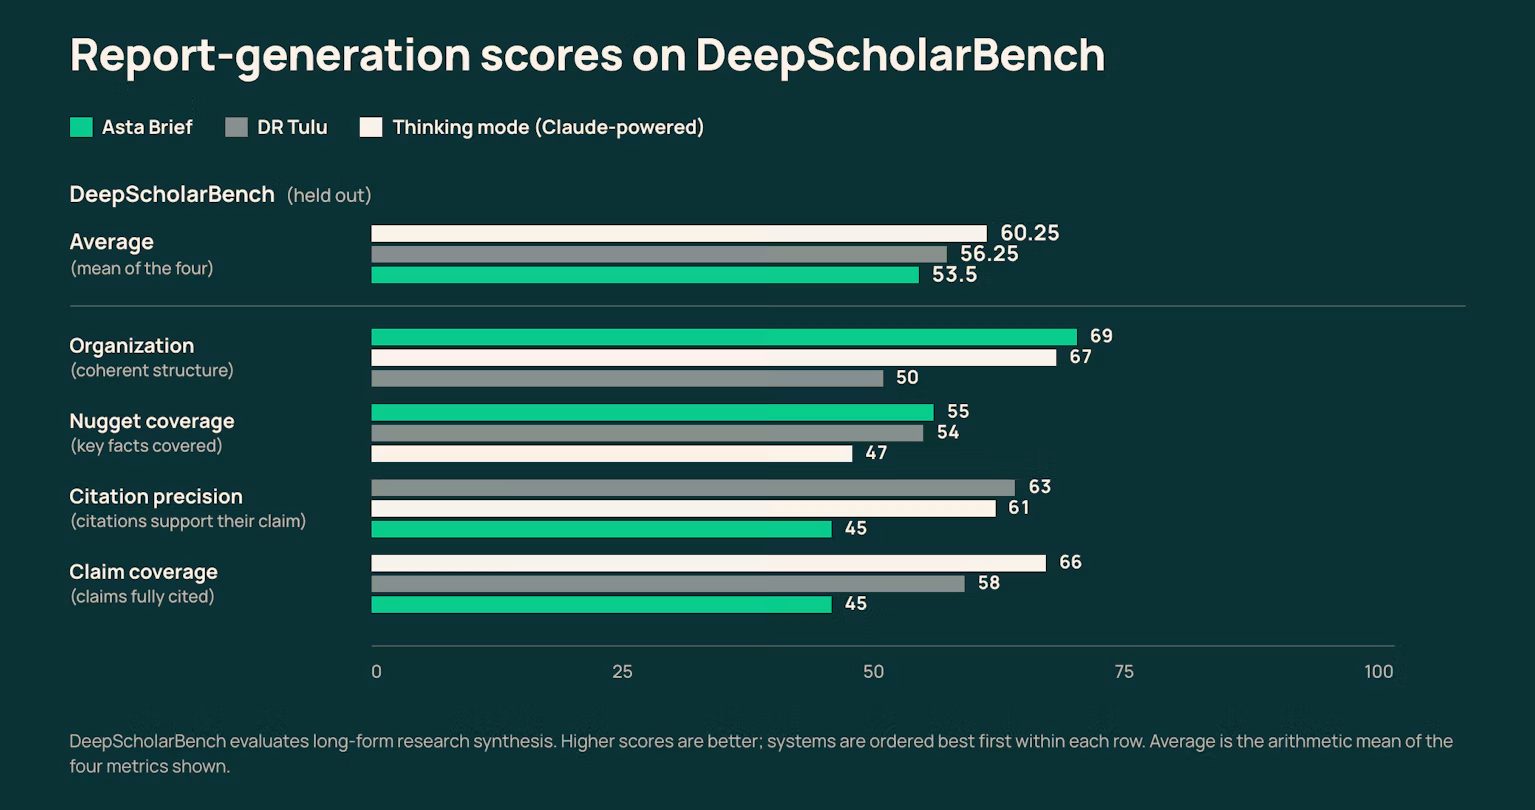
AstaBrief, Claude tabanlı boru hattına ve DR Tulu'ya karşı rekabetçidir. İnsan değerlendirmesinde genel olarak DR Tulu kazanıyor, ancak üç araştırmacıdan ikisi alıntı doğruluğunda AstaBrief'a avantaj verdi. Ai2, değerlendirmenin büyük ölçüde 2025'te yapıldığını ve güncel modellerle tekrarlanmadığını belirtiyor.
Erken kullanım olumlu: Fast mode'u 374 kullanıcı denedi, %29,1'i iki veya daha fazla gün kullanıyor, ortalama 3,67 raporluk konuşma oluşturuyor. %23'ü Fast mode'da kalmayı tercih etti, %18'i modlar arasında geçiş yapıyor ve konuşmaların %40'ı Fast mode'da tamamlandı. Her iki modda da olumlu geri bildirim benzer: Fast mode için %84,2 ve Thinking mode için %85,2.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.