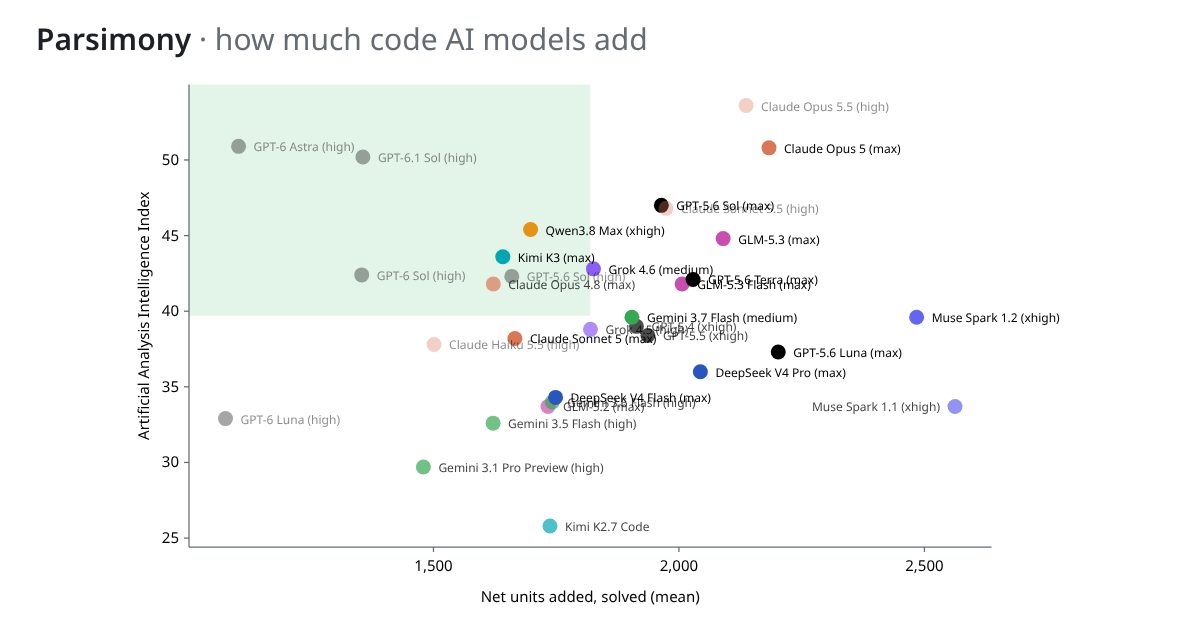
Yeni Parsimony benchmark'i AI kodlama ajanlarını eklenen koda göre değerlendiriyor
Parsimony benchmark'i, AI kodlama ajanlarının görevi çözerken ne kadar kod eklediğini ölçer. Sözdizimi birimlerini, satırları değil hesaplar, silinen kodu düşer ve modelleri SWE-bench Verified üzerinde eklenen ortalama net birimlere göre sıralar.
Mevcut AI kodlama benchmark'leri çözme yüzdesini ve maliyeti ölçer, ancak aşırı kodu cezalandırmaz; bu durum zaman içinde kod tabanıyla çalışmayı zorlaştırabilir. Parsimony adlı yeni benchmark farklı bir yaklaşım benimser: AI modellerinin görevi çözerken ne kadar kod eklediğini ölçer.
Parsimony nasıl çalışır
Parsimony, benchmark'lerin yayınladığı yamaları alır ve kod birimlerini, yani talimatlar, çağrılar, karşılaştırmalar, isimler ve literaller gibi sözdizimi öğelerini hesaplar. Satırlar sayılmaz, bu yüzden daha az satıra sığdırılmış kod ödüllendirilmez. Silinen kod düşülür, bu da basit bir formül sağlar: net birimler, eklenen eksilen silinen koduna eşittir. Her yama görevin koduna uygulanır ve değiştirilen her dosyanın her iki sürümü ayrı ayrı ayrıştırılır; hiçbir şey atlanmaz. Testler, dokümantasyon ve üretilmiş dosyalar hariç tutulur ve yalnızca Python ölçülür. Başarılı ve başarızsız sonuçlar SWE-bench'in yayınlanan sonuçlarından alınır ve testler yeniden çalıştırılmaz.
Lider tablosu nasıl okunur
Modeller, çözdükleri görevlere eklenen ortalama net birimlere göre, en düşükten başlayarak sıralanır. „Net units added (mean)" tablosu ayrıca başarızsız denemeleri de içerir. „Solved" sütunu SWE-bench Verified'dan gelirken, „Measured" sütunu kaç çözülmüş denemenin ölçülebildiğini gösterir. Artificial Analysis Intelligence Index, modelin ve muhakeme gücüne göre karşılaştırılan harici puan olarak görünür ancak sıralamaya etki etmez. Yayınlanan kayıtlar, yazarın ilk 3'ten 10'a kadar DeepSWE Python görevinde, OpenAI modelleri için pi ve Anthropic modelleri için Claude Code kullanarak yayınlanan kodu çalıştırmasıyla oluşturulmuştur ve her görev kendi testleriyle değerlendirilmiştir; bunlar doğrulanmamış veya sıralanmamıştır. GPT-5.6 Sol her iki yoldan da çalıştı ve yazarın çalıştırması, yayınlanan çalıştırma kodunu 0,88 oranında artırdı.
Sınırlamalar ve uyarılar
Proje, daha küçükünün her zaman daha iyi olmadığını belirtir: birimler boyutu ölçer, okunabilirliği veya tasarımı değil. Daha fazla kod yazan modellergenellikle daha fazla görevi de çözer; 26 veya daha fazla modelin olduğu tablolarda Spearman korelasyonları 0,33 ile 0,60 arasındadır. Her model aynı aracıyı, mini-SWE-agent'ı kullanır, ancak aracı yine de ne kadar kod yazıldığını etkiler.
Kendi benchmark'inizi ekleme
Başka bir benchmark'ten kod boyutu sayılarına sahip okuyucu, örnek bir JSON dosyasını indirebilir, kendi sonuçlarını doldurabilir ve aynı diagram ile tabloyu elde etmek için onu açabilir. Dosya tarayıcıda kalır.
Kaynaklar: parsimony.lasu.dev
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.