Qwen3.8-27B tek RTX 3090 ve iki kartta: %20 daha fazla decode, %14 daha hızlı soğuk prefill
Qwen3.8-27B'nin vLLM üzerindeki kişisel kıyaslaması: tek RTX 3090, tensor parallelism ile iki karta karşı. İkinci kart decode hızına %15–30, soğuk prefill'e ortalama %14 ekliyor; sıcak promptlardaki farkın büyük kısmı ise prefix cache'e ait.
14 Ağustos'ta yayımlanan 27,8 milyar parametreli yoğun model Qwen3.8-27B, W4A16 kuantizasyonuyla tek bir 24 GB karta sığıyor. Arsen Apostolov ikinci bir RTX 3090'ın tensor parallelism altında gerçekte ne kazandırdığını ölçtü.
Kurulum
İki sunucu da vLLM üzerinde, prefix caching açık, aynı imajdan ve aynı Qwen3.8-27B-W4A16-AutoRound-fast ağırlıklarıyla çalışıyor. Tek kart 22,6 GB VRAM ve 131.072 token bağlam tutuyor; ikili kurulum ağırlıkları kart başına 21,7 GB'a bölüp bağlamı 262.144 token'a çıkarıyor. Makinede üç RTX 3090, iki Xeon E5-2660 v4, 60 GB RAM ve Ubuntu 26.04 var.
Ölçüm 150 satırlık bir betik: dört boyutta gerçek sohbet tamamlama istekleri (600'den 9.300 token'a), her biri üç kez ve medyanla, max_tokens=256 ve temperature=0. Her soğuk istek benzersiz bir ilk satır taşıyor, böylece hiçbir ön ek eşleşmiyor.
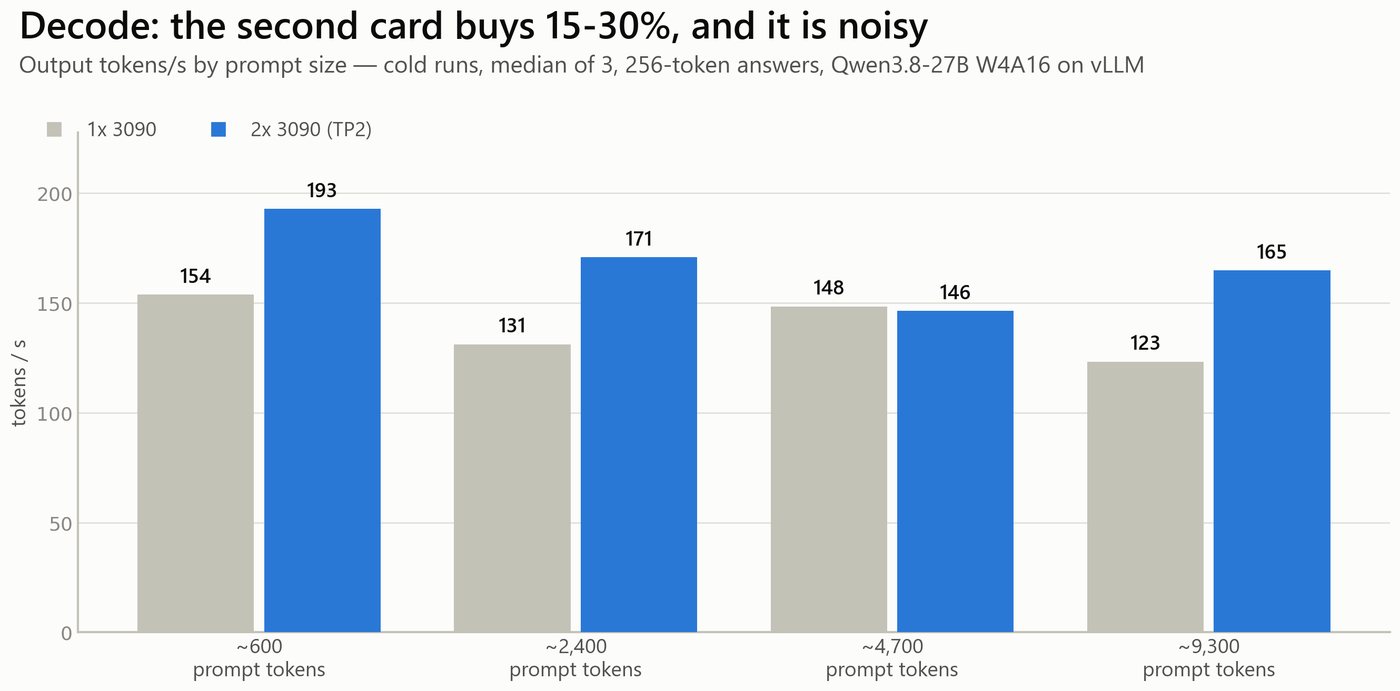
Decode: ikinci karttan %15–30
Tek kart tüm basamaklarda saniyede 123–154 token tutuyor, ikili 146–193. Kazanç bu çalıştırmada ortalama %22, bir saat önceki çalıştırmada %13 oldu; çünkü tek akışlı decode bir saat arayla yapılan çalıştırmalar arasında yaklaşık %10 oynuyor. Yazar sonucu bilinçli olarak yuvarlamıyor: %15–30 deyin ve alt sınıra hazır olun.
Prefill: soğuk olan kartlar, sıcak olan önbellek
Soğuk prefill hesaplamaya bağlı: tek kart saniyede 1.100–1.220 token işliyor, ikili 1.230–1.360. Prompt 600'den 9.300 token'a çıkarken ilk token süresi tek kartta 0,53 saniyeden 8,5 saniyeye, iki kartta 0,50'den 6,9 saniyeye tırmanıyor — 600 token'da %6, 9.300'de %23, ortalama %14.
Sıcak istekler başka bir tablo çiziyor: tekrarlanan prompt ikilide 0,5–0,75 saniyede dönüyor, tek kartta 0,5–1,7 saniyede; bu 2–3 katlık fark donanıma değil prefix cache'e ait. İpucu aritmetikte: 0,56 saniyede işlenen 8.600 token saniyede 15.000 token demek — iki 3090'ın 27B modelde gerçekte verdiğinin on katı.
Maliyeti ne
İki konteyner de hizmet verirken makine prizden 620 W çekiyor. Saniyede 150 token hızında bir milyon token yaklaşık 6.667 saniye, yani 1,15 kWh tutuyor — Bulgaristan'ın çift tarifeli sisteminde gündüz 0,34 BGN ya da gece 0,21 BGN, kabaca 0,20 veya 0,12 dolar. DeepInfra, Qwen3.8-27B için milyon çıktı token'ı başına 3,00 dolar listeliyor.
Apostolov bunun API'yi kötü bir tercih yaptığını savunmuyor: fiyata veri merkezinin enerjisi, soğutması ve boş kapasitesi dahil. Daha dar nokta şu: zaten çalışan donanımda sunulan her token neredeyse saf marj. Yazar testin sınırını da belirtiyor — tek istekli ölçüm, continuous batching denenmedi.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.