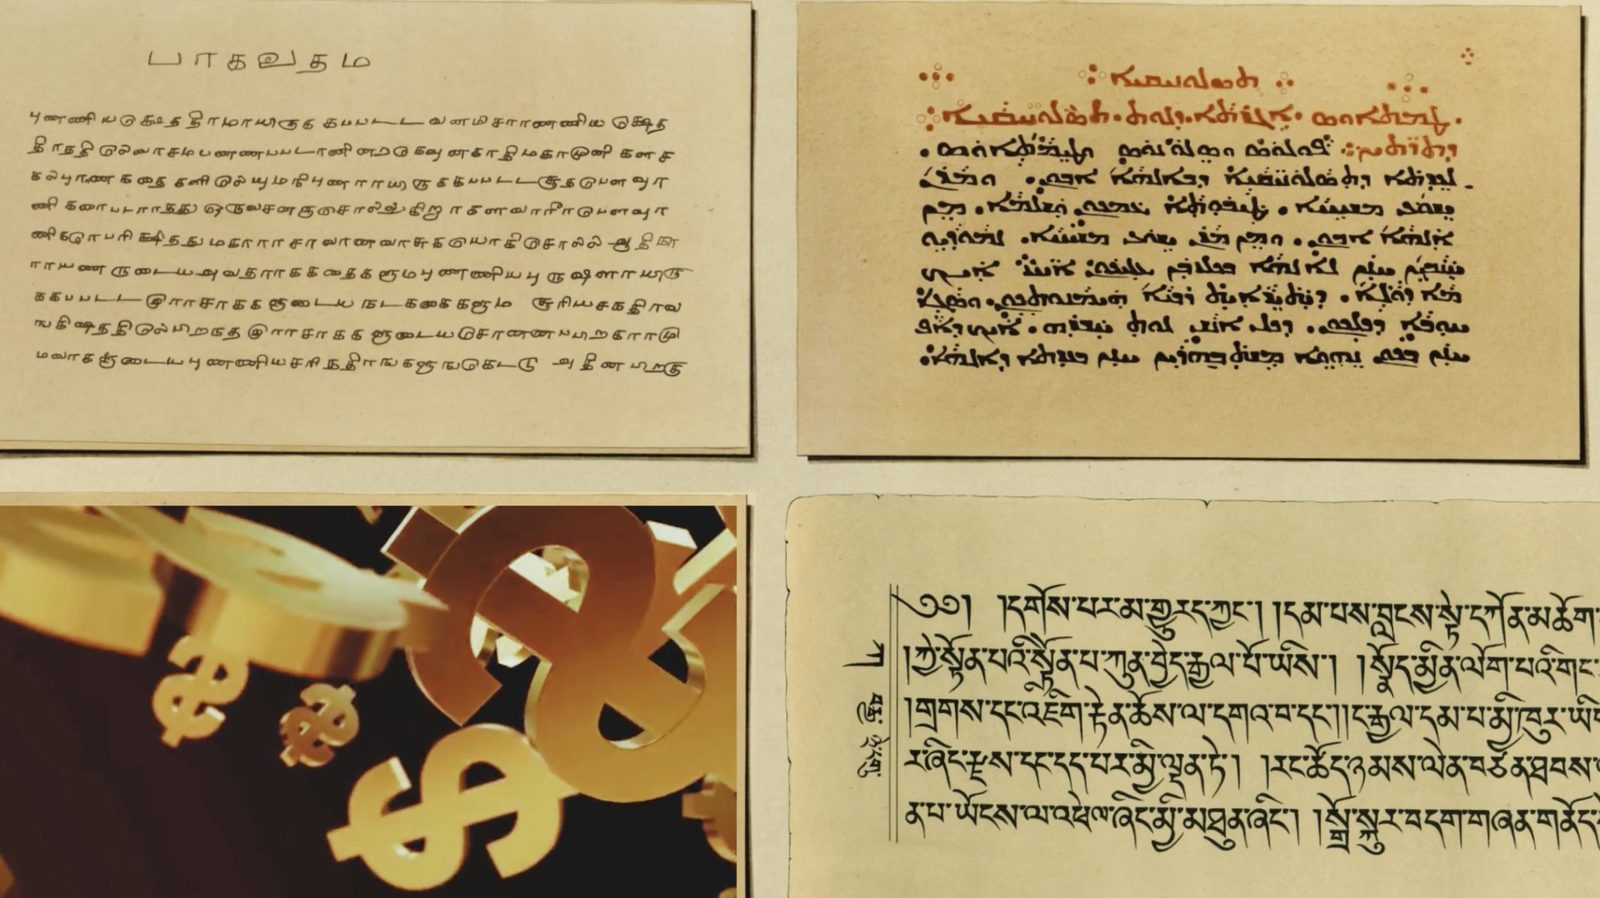
Tokenizer Vergisi: İngilizce olmayan yapay zeka kullanıcıları neden daha fazla token öder?
Coalition for Language Equity in AI Research çalışmasına göre yapay zeka modelleri bazı dillerde çok daha fazla token kullanabiliyor; bu da İngilizce dışındaki kullanıcılar için maliyeti, gecikmeyi ve bağlam sınırlarını artırıyor.
Coalition for Language Equity in AI Research tarafından yapılan bir çalışma, yapay zeka modellerinin bazı diller için diğerlerinden çok daha fazla token gerektirebileceğini ve bunun araştırmacıların gizli bir tokenizer vergisi olarak adlandırdığı durumu oluşturduğunu buldu. Bu etki, özellikle çevrim içi varlığı daha küçük olan dilleri kullanan insanlar için yapay zekayı daha pahalı hale getirebilir. Tokenler, yapay zeka modellerinin işlediği metin veya veri birimleridir.
Token sayıları dile göre nasıl değişir
Tokenleştiriciler ham metni, görüntüleri veya sesi tokenlere böler. Bir örnekte İngilizce bir cümle tanınabilir kelimelere ayrılırken, Malayalam dilindeki aynı cümle çok baytlı karakterlere saygı göstermeden kelime başına birden fazla parçaya bölündü. İnternetin en popüler 20 dilinde bile araştırmada token kullanımında bir fark bulundu: bu dillerin en pahalısı en ucuzundan 1,5 ila 5 kat daha fazla token kullandı. Küme 200 dile genişletildiğinde, bir yapay zeka modelinde token maliyet farkı 17 kat büyüdü. Çalışmaya göre Bengaluru'daki bir girişim her istem ve tamamlama için ek ücret ödeyebilirken, Austin'deki rakibi ödemeyebilir.
Maliyet tek dezavantaj değil
Daha yüksek token sayıları ayrıca daha yüksek gecikmeye ve azalmış etkili bağlam kapasitesine dönüştü, çalışmaya göre. İngilizce olmayan diller belgeler veya konuşma geçmişi için daha az yer bırakıyor ve bir yanıt üretmek için daha fazla iş gerektiriyor, Activate AI kurucu ortağı Pratyush Choudhury'ye göre. Sorunu bir öğretmenin öğrencinin önceki hatalarını ve açıklamalarını aklında tutmasına benzetti: bu geçmiş bir dilde bağlam penceresini çok daha hızlı tüketirse, dezavantaj hizmet kalitesine de uzanır. Çalışmaya göre bu cezalar hesaplama ve bağlantı olanaklarının zaten sınırlı olduğu yerlerde en ağır hissediliyor ve tokenizer eşitsizliği yapay zeka ekonomisine kimlerin katılabileceğine bir kısıt oluşturuyor.
Yazı sistemi, veri ve tasarımın hepsi önemlidir
Bir dilin nadir olması token kullanımındaki tek etken değildir; yazı sistemi büyük rol oynar. Görece az konuşuru olan ve Common Crawl verisi bulunmayan Asturian, Latin alfabesi avantajından ve İtalyanca gibi akraba Roman dillerinden gelen temsilden yararlanır. Tokenleştiricilerin nadiren gördüğü alfabelerle yazılan diller, yani Birmanca, Tibetçe, Tifinagh, Khmer, Lao ve Ol Chiki, analizdeki neredeyse tüm modellerde tutarlı olarak en büyük dezavantajı yaşadı. Maya Research CEO'su Dheemanth Reddy, birçok tokenleştiricinin İngilizce ve diğer yüksek kaynaklı diller için orantısız biçimde optimize edilmiş olmaya devam ettiğini ve temel sorunun yüksek kaliteli dijital veri eksikliği olduğunu söyledi. Dil işlemeyi iyileştirmenin bir yolu temel veriyi iyileştirmektir. Navana.ai kurucu ortağı ve CEO'su Raoul Nanavati, Hindistan Bilim Enstitüsü ile ortak bir girişim olan ve Gates Vakfı tarafından finanse edilen RESPIN'i işaret etti; bu girişim 38 lehçenin anadili konuşucularından metin ve okunmuş konuşma topladı.
Açığı kapatmak
Reddy, daha iyi eğitim verisinin tek başına tokenleştiriciyi düzeltmediğini uyardı. Token fiyatları hızla düşüyor, bu yüzden doğrudan maliyet etkisi zamanla daha az ağır hale gelmeli ve daha iyi çok dilli ve sentetik veri model kalitesini artırmalı. Ancak tokenleştirme farkını gerçekten kapatmak, laboratuvarların bu dilleri ve alfabeleri daha iyi işleyecek gelecek tokenleştiricileri bilinçli olarak tasarlamasını gerektirecek. Choudhury, dil verimliliğinin doğruluk, hız ve güvenilirliğin yanında bir ürün gereksinimi olması gerektiğini söyledi. Mükemmel eşitliğin gerçekçi olmayabileceğini, ancak büyük ve kalıcı farkların bir açıklama ve bir iyileştirme planı gerektirmesi gerektiğini söyledi ve her büyük laboratuvarın karşılaştırılabilir görevleri başarıyla tamamlamanın maliyetini gösteren dilden dile bir skor kartı yayımlamasını ve en kötü hizmet alan dilleri için ölçülebilir iyileştirmelere söz vermesini istedi.
Kaynaklar: Rest Of World · Techmeme
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.