Meta, Prometheus'taki yapay zeka eğitimini sürdürmek için boşta kalan yedek GPU'ları ve kontrol noktalarını kullanıyor
Meta, Prometheus süper kümesindeki GPU'ların yüzde 11'inden fazlasının ölü ya da yedek olarak boşta beklediğini söylüyor. Kontrol noktası kaydetme, NVLink çalışmaları ve daha az kesintiyle bir milyon hızlandırıcıya ölçekleniyor.
Yedekler arızaları karşılıyor
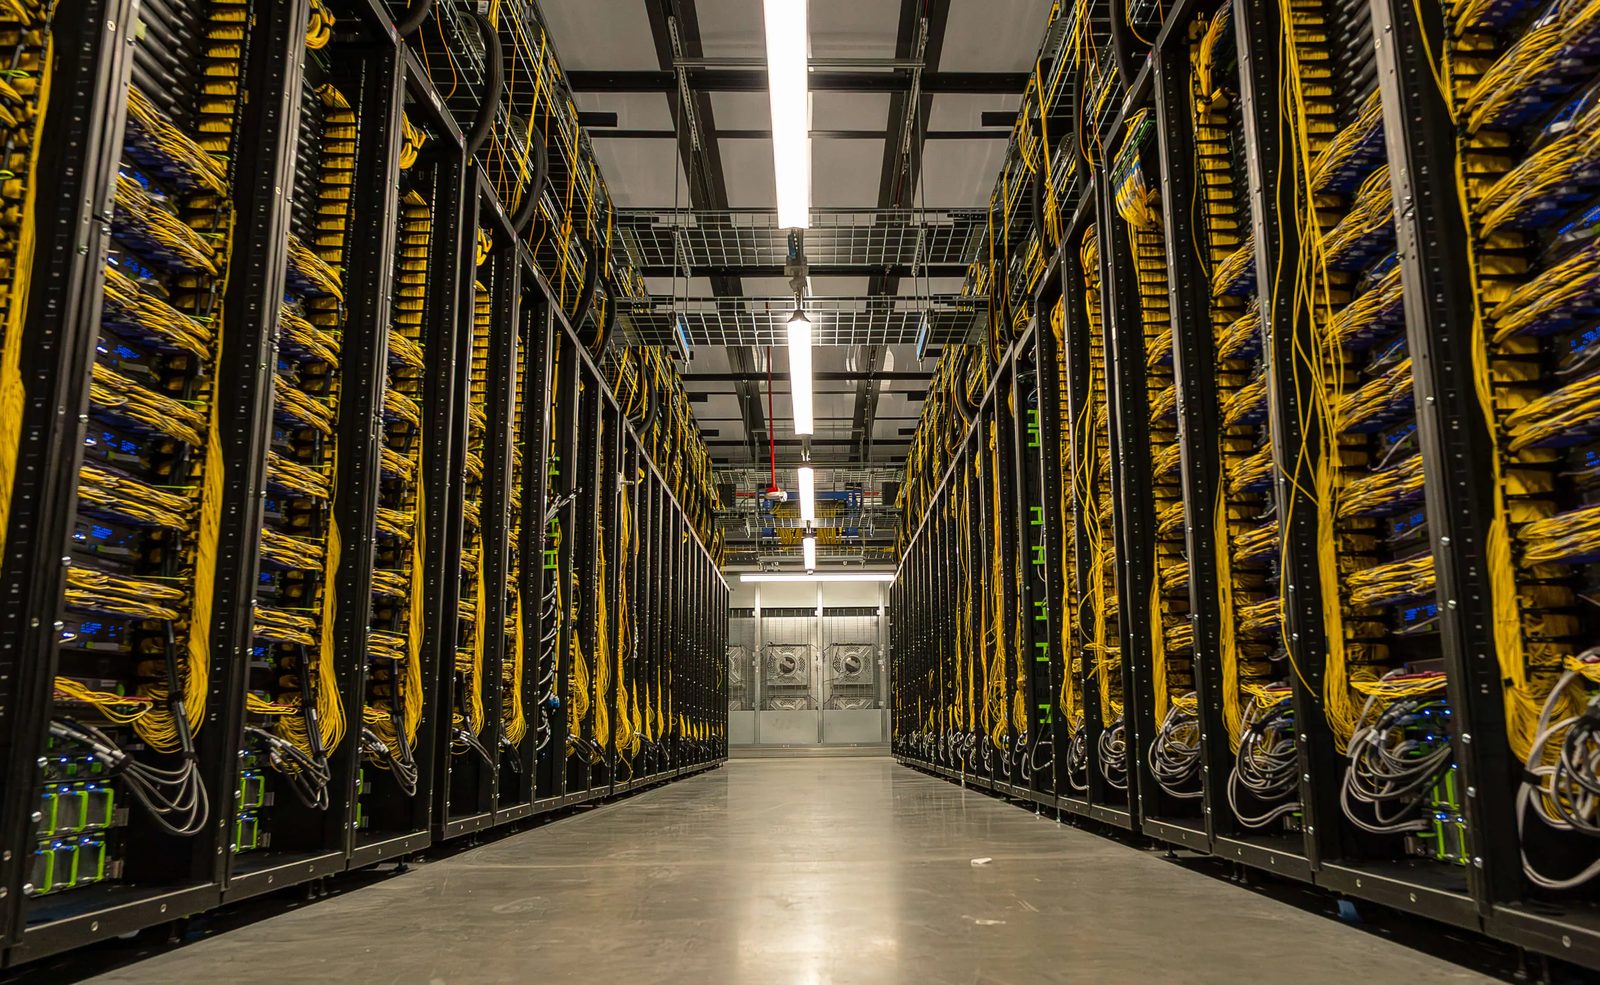
Meta, Ohio eyaletindeki New Albany'de bulunan Prometheus süper kümesindeki GPU'ların yüzde 11'inden fazlasının ölü olduğunu ya da arızalanan bir birimi değiştirmek için boşta beklediğini söyledi. Yedek havuz, Meta'ya göre nihayetinde yaklaşık bir gigawatt kapasiteye ve Nvidia Grace Blackwell rack sistemleri ile daha sonra Vera Rubin sistemleri kullanılarak yaklaşık bir milyon hızlandırıcıya ulaşacak bir sistemin tasarımının parçasıdır.
Güncel küme, her NVLink etki alanında 72 GPU bulunan GB200 ve GB300 sistemlerini kullanıyor, ancak her an yalnızca 64 GPU kullanılıyor. Diğer sekizi sıcak yedek olarak çalışıyor. Meta, bunun önemli olduğunu söyledi, çünkü arızalanan tek bir GPU aksi hâlde tüm bir rack'i çökertebilir ve bir eğitim çalışmasını kesintiye uğratabilirdi. Yedek sayesinde değiştirilen birim yerine takılabilir, ancak arıza yine daha kısa bir kesintiye neden olur.
Prometheus ilk aşamasına başladığında Meta, her 8.000 GPU başına günde yaklaşık 1.000 kesinti görüldüğünü söyledi. Kesinti, bir şeyin çöktüğü, arızalandığı veya zaman aşımına uğradığı ve eğitim çalışmasının son bilinen iyi kontrol noktasına geri alındığı anlamına gelir. Meta, yaklaşık bir yıl sonra kesintileri yüzde 99 azaltarak her 8.000 GPU başına günde yaklaşık 11'e düşürdüğünü söyledi.
Kontrol noktası kaydetme geri almayı sınırlıyor
Meta ayrıca, bir modelin birden fazla kopyasının kümede bulunduğu ve veri paralelliği kullanan büyük eğitim işleri içindeki arızaları nasıl sınırladığını anlattı. Bir arıza yalnızca bir veri paralel model kopyasına izole edilebiliyorsa, o kopya çevrimdışı olur ve kümenin geri kalanı adımı tekrarlar ve eğitim sürer. Bozulan dilim daha sonra yedek sunucularda yeniden başlar ve yeniden eşzamanlanır; bu, tam bir duraklama olabilecek durumu toplam verimdeki geçici bir düşüşe dönüştürür.
Bir arıza veri paralel etki alanının ötesine taşarsa Meta, kontrol noktası kaydetmeye güvenir. Şirket, dağıtık kontrol noktası mimarisinin model durumunu, gradyanlar ve optimize edici verileri de içerecek şekilde, birden fazla depolama katmanına zaman uyumsuz olarak kaydettiğini söyledi. Bu, bir çalışmanın baştan başlamak yerine kaydedilmiş bir durumdan devam etmesini sağlar. Meta, bu çalışmayı Muse Spark ve daha yeni Muse Wonder gibi modelleri rayında tutmak için gerekli olarak nitelendirdi.
Bağlantılar ve güç, ölçeği belirliyor
Bir zorluk, NVLink dokularının tek büyük bir hızlandırıcı gibi davranmasını sağlamaktı. Meta, önceki H100 ve H200 sistemlerinde her NVLink etki alanı başına sekiz GPU olduğunu, Nvidia Blackwell'in bunu dokuz kat büyüttüğünü söyledi. 600.000'den fazla NVLink bağlantısıyla, en küçük sinyal bozulmaları bile sık kurtarma döngülerini tetikliyordu. Meta, sistemler üretime girmeden önce zayıf bağlantıları izole etmek için sürekli telemetri ve L11 tanısal yük testlerini kullandığını söyledi.
Güç başka bir sorunuydu. Meta, bir eğitim çalışması için on binlerce GPU'nun açılıp kapatılmasının, güç kaynağı ekipmanını aşırı yükleme riski taşıyan büyük geçici güç dalgalanmaları yaratabileceğini söyledi. Şirket, küme kararlılığını ve güvenilirliğini önceliklendirerek Muse Wonder üzerinde ön eğitim için yüzde 85'ten fazla ve pekiştirmeli öğrenme için yüzde 90'dan fazla kullanışlı verime ulaştığını söyledi. Önümüzdeki dönemde Meta, kesinti oranını her 8.000 GPU başına günde ikiye, yani kesintiler arası ortalama süre olarak yaklaşık 100.000 GPU saatine düşürmek istiyor.
Kaynaklar: The Register
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.