Cerebras تشرح كيف تنشر نماذج ذكاء اصطناعي بتريليون معامل على رقائقها واسعة النطاق
توضح Cerebras كيف توزع النماذج الحدودية الكبيرة التي تعمل بتريليون معامل عبر رقائق WSE-3T، مستخدمة Kimi K3 مثالا لشرح الذاكرة على الشريحة وخط الأنابيب ومعالجة الطلبات المتزامنة.
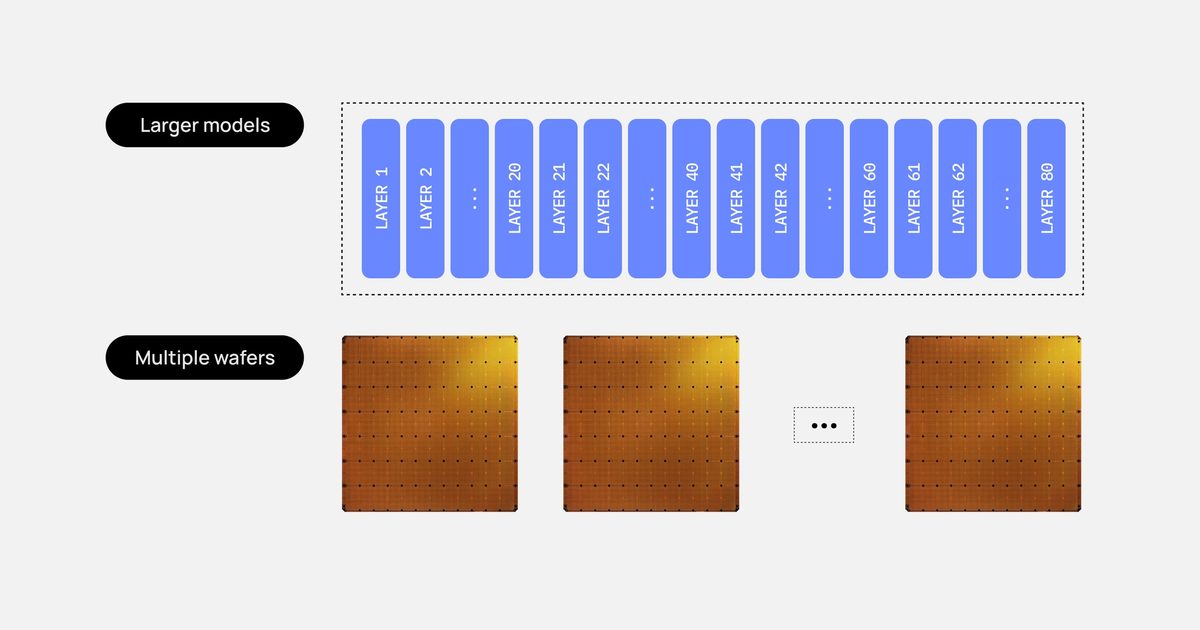
نشرت Cerebras شرحا لكيفية نشرها نماذج حدودية بتريليون معامل على رقائقها واسعة النطاق. تحتوي رقاقة Cerebras WSE-3T الواحدة على 44 GB من الذاكرة على الشريحة، بينما تحتاج النماذج بتريليون معامل إلى تيرابايتات لأوزانها وحدها. وتقول الشركة إنها توزع نموذجا كبيرا عبر عدة رقائق WSE-3T لتشغيل نماذج بعدة تريليونات من المعاملات بسرعة 1000-2000+ رمز في الثانية.
Kimi K3 كمثال
تستخدم Cerebras نموذج Kimi K3 مفتوح المصدر كمثال توضيحي. لدى Kimi K3 نحو 3 تريليونات معامل، مع 69 طبقة انتباه خطي و24 طبقة كثيفة. وتقول Cerebras إن Kimi K3 يسجل 88.3% في Terminal-Bench 2.1 مقابل 88.8% لـ GPT-5.6 Sol، و91.2% في BrowseComp مقابل 90.4% لـ GPT-5.6 Sol. وتقول Cerebras إن هذه النتائج تظهر قدرات برمجة ووكيلية بمستوى النماذج الحدودية، مع تفوق النموذج على نماذج مملوكة رائدة في بعض المعايير.
في المثال، تفترض Cerebras متوسط حجم طلب قدره 256k، وتكميم أوزان بـ 4-bit، وذاكرة KV cache بـ 8-bit. وتحسب حجم كل طبقة في النموذج، ثم تقسم النموذج عبر 93 طبقة. وتكون النتيجة نحو 16 GB لكل طبقة.
توزيع الطبقات على الرقائق
تحدد سعة 44 GB لكل رقاقة WSE-3T عدد الطبقات التي تتسع على الرقاقة، وتعتمد الإجابة على نوع الطبقة. تحتاج الطبقات الكثيفة إلى مساحة إضافية لـ KV cache لأن كل طبقة كثيفة بانتباه كامل تخزن المفاتيح والقيم لكل رمز في كل طلب نشط. لذلك تضع Cerebras طبقة كثيفة واحدة لكل رقاقة وتترك ما تبقى من SRAM لـ KV cache الخاص بها.
لا تحتاج طبقات الانتباه الخطي إلى مساحة إضافية لـ KV cache. فبدلا من تخزين المفاتيح والقيم لكل رمز، تحتفظ طبقة الانتباه الخطي بحالة صغيرة ثابتة الحجم لكل طلب بغض النظر عن طول السياق. وهذا يترك مساحة لطبقتين خطيتين لكل رقاقة، بواقع 2 x 16 GB = 32 GB. مع 69 طبقة خطية و24 طبقة كثيفة، ينتج التوزيع 35 رقاقة للطبقات الخطية زائد 24 رقاقة للطبقات الكثيفة، بإجمالي 59 رقاقة.
تنفيذ خط الأنابيب والتزامن
تنفذ Cerebras النماذج في خط أنابيب. يوزع المترجم طبقات النموذج عبر مناطق من الرقائق، ويرسم وقت التشغيل مسار تدفق الرموز بين الرقائق. لا يلزم تمرير سوى التنشيطات بين الرقائق، ويمكن القيام بذلك عبر RDMA over Ethernet بنحو 2 ميكروثانية لكل قفزة. ولأن كل رقاقة لديها 44 GB من SRAM على الشريحة وكل طبقة نحو 16 GB، يمكن عادة احتواء طبقات كاملة مباشرة على الشريحة. في معظم الحالات، لا تضطر أوزان النموذج إلى الحركة أبدا، ولا تحتاج الطبقات إلى تقسيم عبر الرقائق.
تعمل كل رقاقة كمرحلة واحدة في خط تجميع. على سبيل المثال، تشغل الرقاقة 1 الطبقات 1-2 وترسل التنشيطات إلى الرقاقة 2، التي تشغل الطبقات 3-4 وتمرر النتائج حتى تنتج الرقاقة الأخيرة الرمز التالي. لخدمة طلبات كثيرة، تبقي Cerebras خط الأنابيب ممتلئا بطلبات مختلفة. يمكن لكل مرحلة أن تعمل على طلب مختلف في الوقت نفسه، ويمكن لكل مرحلة معالجة دفعة صغيرة بدلا من طلب واحد. الدفعات الصغيرة تجعل كل طلب أسرع، بينما تزيد الدفعات الأكبر الإنتاجية الإجمالية.
تحدد كمية الذاكرة المخصصة لـ KV cache على الشريحة الحد الأقصى لعدد الطلبات المتزامنة. كل طلب قيد التنفيذ يحتاج إلى KV cache خاص به على كل رقاقة طبقات كثيفة. وتلاحظ Cerebras أن التزامن وحجم الدفعة لا يظهران وحدهما كفاءة الاستدلال؛ والمقياس الأكثر دلالة هو إجمالي إنتاجية الرموز لكل وحدة طاقة، مقاسة عند سرعة توليد المخرجات نفسها.
المصادر: cerebras.ai
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.