فريق بقيادة Google يقدّم وكيل فيديو StreamVibe للمساعدة في الوقت المناسب
قدّم فريق بحث بقيادة Google وكيل فيديو StreamVibe لتحديد متى يتحدث أثناء المهام. أظهرت الاختبارات تحسناً في توقيت الاستجابات وجودتها، لكن أيضاً نقاط ضعف مستمرة في الفيديوهات الطويلة.
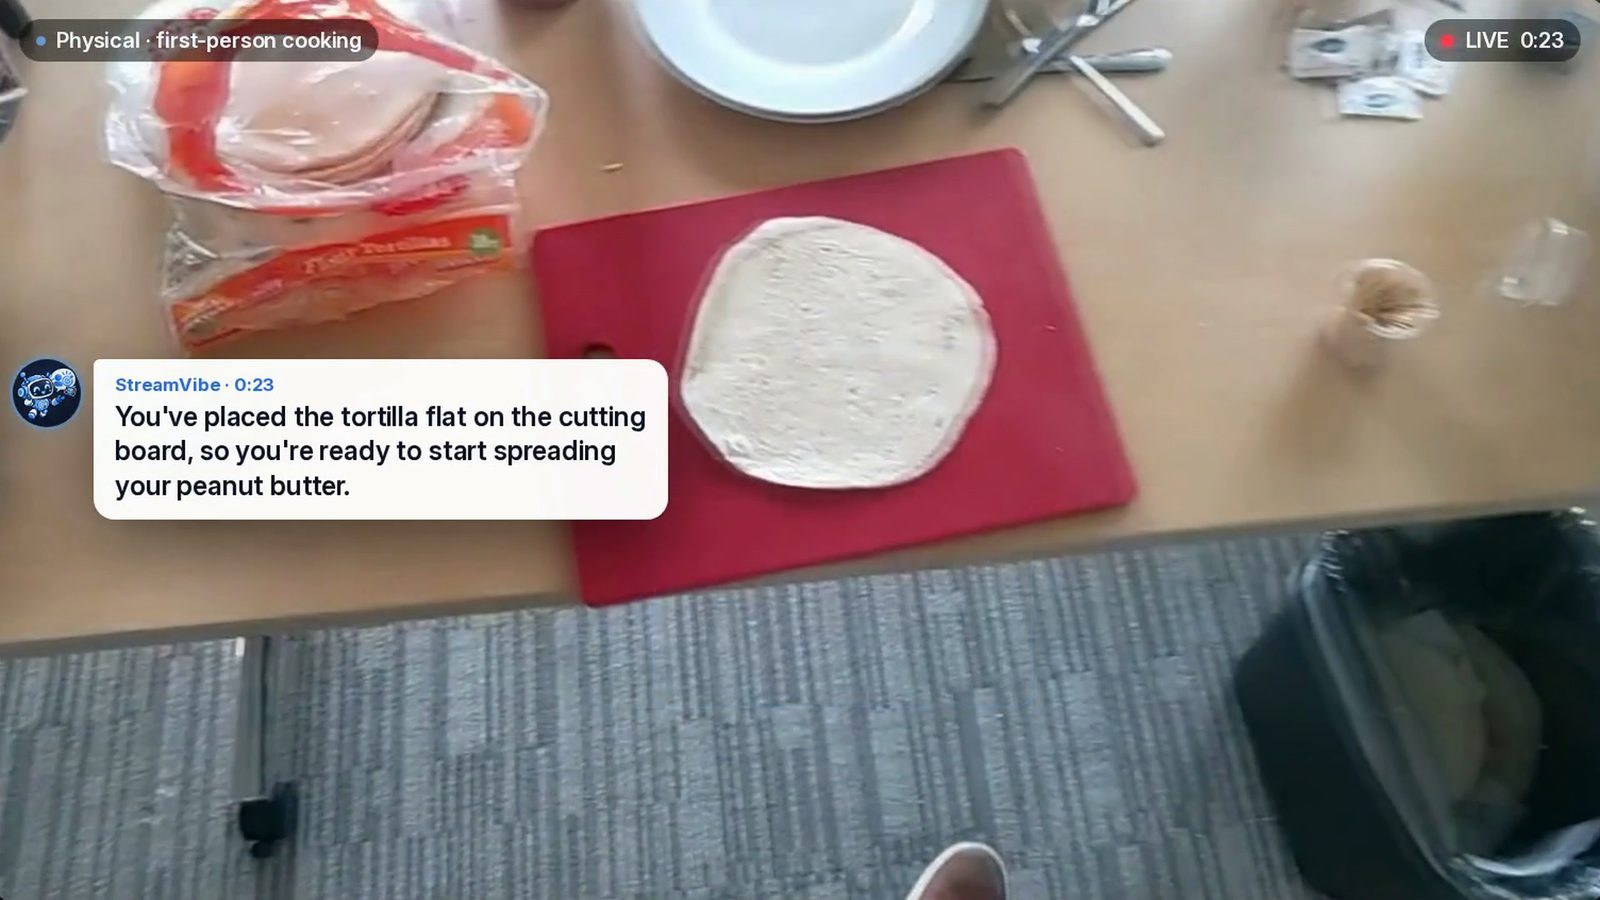
قدّم فريق بحثي بقيادة Google وكيل الفيديو StreamVibe، وهو وكيل مصمم ليقرر بنفسه متى يتحدث أثناء عمل المستخدم. ويجمع المشروع باحثين من Google وStanford وOxford وعدد من الجامعات الأمريكية لبناء مساعد يستطيع مشاهدة أنشطة مثل الطهي أو تركيب الأثاث وتقديم المساعدة عند الحاجة فقط. وتُظهر الاختبارات في الوقت نفسه وعد المساعدة الاستباقية عبر الفيديو والصعوبة التي لا تزال تواجهها النماذج الحالية.
لماذا تقصّر المساعدات الحالية
وفقاً للورقة البحثية، فإن مساعدات الفيديو الحالية مصممة لأوامر واضحة مثل "أخبرني عندما يبدأ الماء بالغليان"، لذا فهي نادراً ما تلتقط النوايا غير المعلنة. كما تجد صعوبة في تتبع ما أُنجز بالفعل، ما قد يؤدي إلى نصائح مكررة أو استجابات متأخرة. وعندما يغيّر المستخدمون طلباتهم في منتصف المهمة، غالباً ما تلتزم المساعدات بالتعليمات الأصلية. وصُمّم StreamVibe للتمييز بين نوايا المستخدم المعلنة وغير المعلنة والمتغيرة أثناء المهمة.
المعيار والتدريب
لقياس المشكلة، جمع الفريق معياراً يضم نحو 4,100 مثال من أكثر من 183 ساعة من تسجيلات الحياة اليومية والبرمجيات. وقد اقترح Gemini 2.5 Flash متى تُقدَّم المساعدة وما يُقال، بينما كان على أربعة مقيّمين بشريين أن يوافقوا بالإجماع على كل مثال. ويغطي الاختبار تعليمات واضحة وأهدافاً غامضة وطلبات تتغير بمرور الوقت. في أحد الأمثلة، يطلب مستخدم يفكك حفارة لعبة تحديثات عن التقدم، ثم ينتقل بعد ثلاث دقائق إلى طلب فحص للجودة.
ودرّب الباحثون StreamVibe-VL، وهو نموذج يبدو أنه مبني على Qwen3.5-9B من Alibaba ويقرر كل ثانية ما إذا كان سيبقى صامتاً أم سيتحدث. وتستخدم مرحلة تدريب ثانية التعلّم بالتعزيز لجعل النموذج أكثر تحفظاً حتى لا يقاطع باستمرار. ويتتبع نظام ذاكرة منفصل الطلبات المعلّقة والخطوات المكتملة، غير أن النموذج وحده يقرر ما إذا كان سيتحدث وماذا يقول.
النتائج والحدود
وفقاً للباحثين، يحسّن StreamVibe-VL توقيت الاستجابات وجودتها بنسبة 10.7 في المئة مقارنة بالنماذج الأخرى، فيما صُمّم نظام الذاكرة لزيادة التفاعل الاستباقي بنسبة 12.3 في المئة إضافية وتقليل المقاطعات غير الضرورية. ويتفوق StreamVibe-VL عموماً على نموذجه الأساسي وعلى النماذج الأخرى مفتوحة المصدر بفارق كبير، وإن كان Gemini 3.8 Flash المملوك لـ Google يحقق نتائج أعلى في عدة اختبارات. وكلما زاد طول الفيديو، انخفض بشكل ملحوظ احتمال أن توقّت النماذج استجاباتها بشكل صحيح.
غالباً ما تتخذ النماذج القرار الصحيح عندما يتعين عليها أن تقرر في لحظات محددة فقط ما إذا كان التنبيه مناسباً. لكن عندما تعالج فيديو كاملاً وتبني على استجاباتها السابقة، ينهار الأداء في جميع الأنظمة المختبرة مع تراكم الأخطاء، وينخفض مقياس محتوى رئيسي بما يصل إلى 61.5 في المئة استناداً إلى تاريخ النظام نفسه. وفي الفيديوهات التي تزيد مدتها على خمس دقائق، نادراً ما تختار النماذج اللحظة الصحيحة، وتجد صعوبة خاصة في تتبع تعليمة تغيّرت على امتداد مقطع طويل.
وفي درس تعليمي على GIMP لتحويل صورة إلى الأبيض والأسود، يقول نموذج المقارنة JoyAI إن الصورة النهائية قد حُفظت بالفعل رغم أن المستخدم لم يفتحها، بينما يقدّم StreamVibe-VL الخطوة التالية مثل "Colors" ثم "Desaturate". ويقرّ الباحثون بأن المواقف في العالم الحقيقي مرجّح أن تكون أكثر تعقيداً من بيئة اختبارهم، وأن العمل المستقبلي سيبحث في كيفية تأثير تفضيلات المستخدم والبيئة أحدهما في الآخر بمرور الوقت.
المصادر: The Decoder
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.