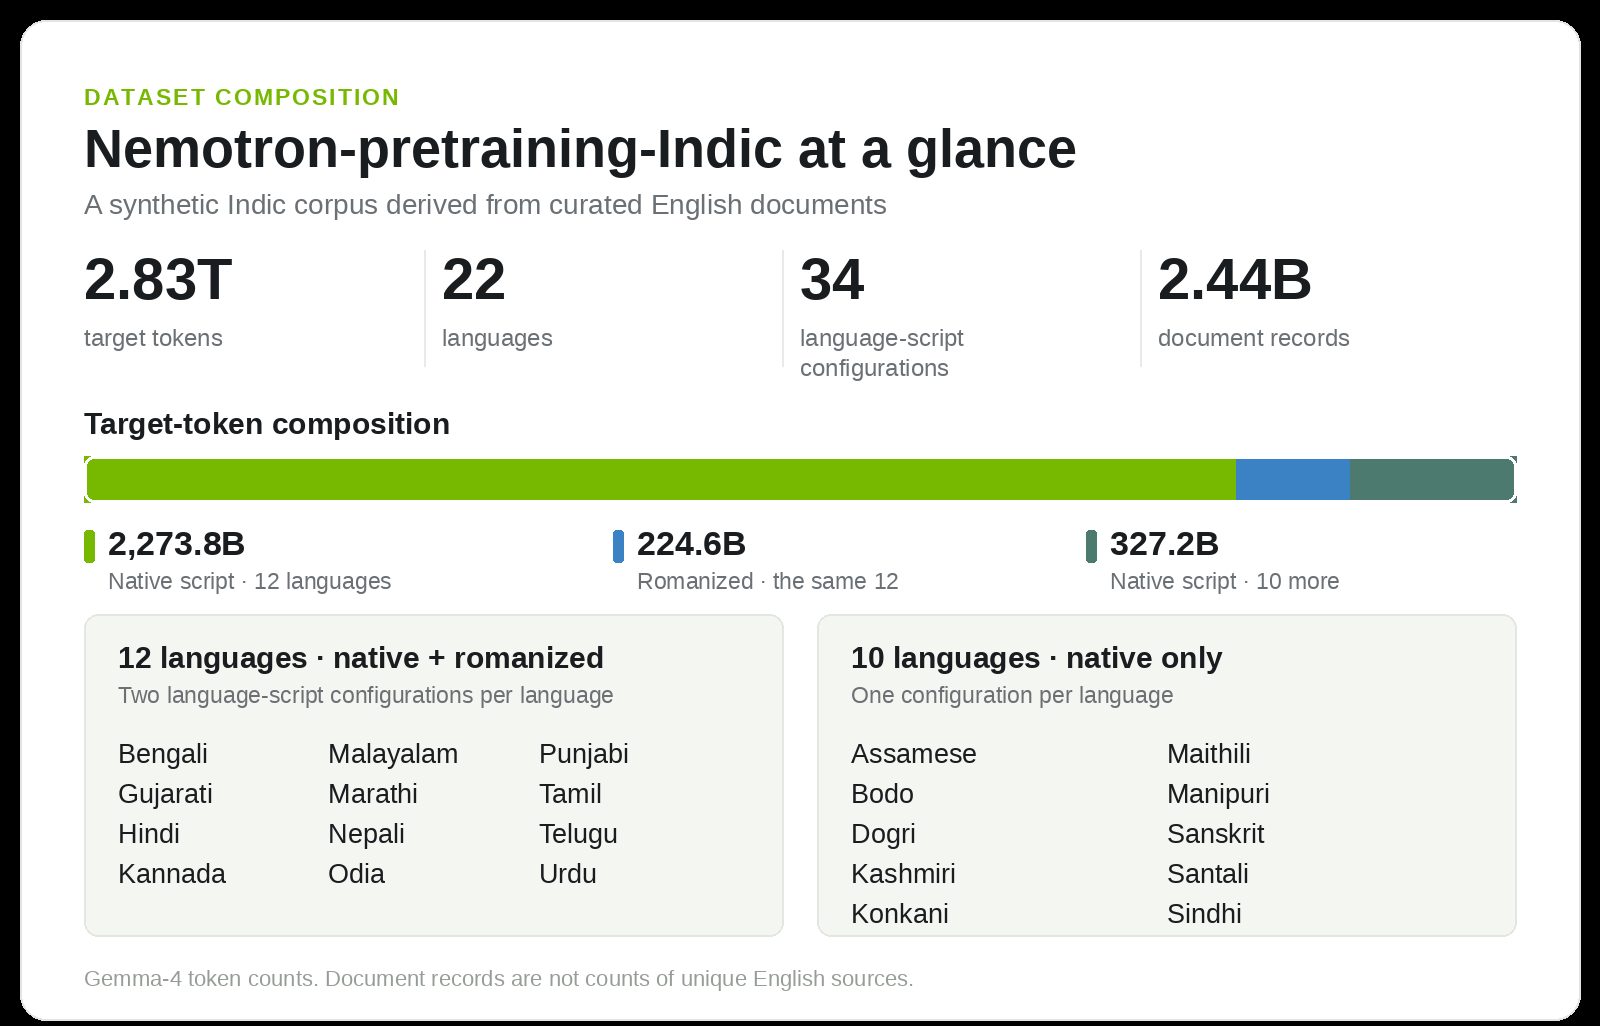
NVIDIA وIIT Madras يطلقان كوربس تدريب مسبق باللغات الهندية بحجم 2,8 تريليون رمز
تطلق NVIDIA وIIT Madras وAI4Bharat Nemotron-pretraining-Indic-v1، وهو كوربس للتدريب المسبق بحجم 2,8 تريليون رموز بـ22 لغة هندية، إضافة إلى خط أنابيب مفتوح ومسرّع بـGPU لإنشائه يشمل الترجمة وتقييم الجودة والتصحيح.
كوربس لـ22 لغة هندية
قدّمت NVIDIA بالشراكة مع IIT Madras ومختبرها AI4Bharat كوربس Nemotron-pretraining-Indic-v1 للتدريب المسبق، الذي يضم نحو 2,8 تريليون رموز باللغات الـ22 المدرجة في دستور الهند. يتضمن الإصدار أيضًا خط أنابيب مفتوح ومسرّع بـGPU لتوليد البيانات، استُخدم في إنشائه ويشمل الترجمة وتقييم الجودة والتصحيح.
يحتوي الكوربس على 2 601,0 مليار رمز بالخطوط الأصلية و224,6 مليار رمز محوَّلًا إلى الأحرف اللاتينية، مُعدًّا بمُجزّئ Gemma-4. ويشمل 34 إعدادًا للغة والخط: بيانات الخطوط الأصلية لجميع اللغات الـ22، ونصوص محوَّلة إلى الأحرف اللاتينية لاثنتي عشرة منها. يرتبط كل سجل بمستند مصدر مُوثَّق، ويتحقق كل مخرَج من مدخلاته، حتى يستند النص الاصطناعي إلى معلومات حقيقية.
من المصادر الإنجليزية إلى بيانات التدريب الهندية
يبدأ خط الأنابيب من 15 مجموعة فرعية من مستندات Nemotron-CC-v2، تشمل نصوص الويب، مواد الأسئلة والأجوبة، الرياضيات، الشيفرة، ومحتوى متخصص آخر. يقوم إطار NeMo Data Designer مفتوح المصدر من NVIDIA بإكمال الترجمة وفحوص الجودة والتصحيح الموجّه، مع الحفاظ على مُعرّفات المصدر لتتبّع المخرجات إلى المستندات الأصلية.
تُترجم المستندات الخاصة باثنتي عشرة لغة بالكامل باستخدام Gemma-4-31B-it، الذي اختير بعد مقارنة نماذج على مستندات كاملة. تشمل بطاقة تقييم مستوحاة من Multidimensional Quality Metrics الأهمية والصحة والمصطلحات والأسلوب والتنسيق، ولا يُحتفظ إلا بالمخرجات التي تجمع 75 نقطة على الأقل من 100. تُصحَّح المخرجات منخفضة الدرجات باستخدام تغذية راجعة للتقييم ثم تُعاد تقييمها، ما أعاد 438,4 مليار رمز. كما تُحوَّل ترجمات الخطوط الأصلية إلى أحرف لاتينية للجزء المُعرَّب.
تستخدم اللغات العشر المتبقية سير عمل منفصلًا مبنيًا على Indic Translate، عبر نموذج ترجمة على مستوى المستند من Bodhan AI. تُترجم النوافذ المتداخلة لمستندات Santali الأطول وتُعاد بناؤها؛ ولـManipuri يُترجم النص إلى الخط البنغالي، ثم يُحوَّل إلى Meitei Mayek.
التأثير على نماذج Nemotron
أضاف التدريب المسبق الممتد لـNemotron 3.5 Super VL 10 مليارات رموز هندية، مأخوذة من اثنتي عشرة مجموعة فرعية من الكوربس ونصوص هندية طبيعية. ارتفعت الدرجات في جميع المعايير الخمسة المذكورة للمعرفة والتفكير الهندية، بزيادة تتراوح من 4,98 إلى 9,82 نقطة مئوية. كما يحقق النموذج المُصدَر درجات أعلى من Nemotron 3 Super في خمسة من ستة معايير لمهام هندية، ويتفوق على IndiVibe في أبعاده الأربعة، مع تراجع الالتزام بالتعليمات على IFEval 1.5 بمقدار 2,04 نقطة.
يخطط الفريق للاستناد إلى هذا الكوربس في نماذج Nemotron المستقبلية، ويوصي بدمجه مع النصوص الهندية المكتوبة طبيعيًا للمعرفة المحلية والسياق الثقافي.
المصادر: Hugging Face Blog
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.