NVIDIA تدمج الاستدلال متعدد الأجهزة في TensorRT داخل Dynamo-Triton
دمجت NVIDIA الاستدلال متعدد الأجهزة في TensorRT داخل Dynamo-Triton 26.07، فأصبحت نسخة نموذج واحدة تمتلك عدة وحدات GPU وانخفض توليد فيديو Cosmos 3 Nano من 156.6 إلى 34.2 ثانية.
دمجت NVIDIA قدرة الاستدلال متعدد الأجهزة في TensorRT داخل Dynamo-Triton، بحيث لم يعد التطبيق مضطرًا لتنسيق صفوف وحدات GPU بنفسه.
ما الذي تغيّر
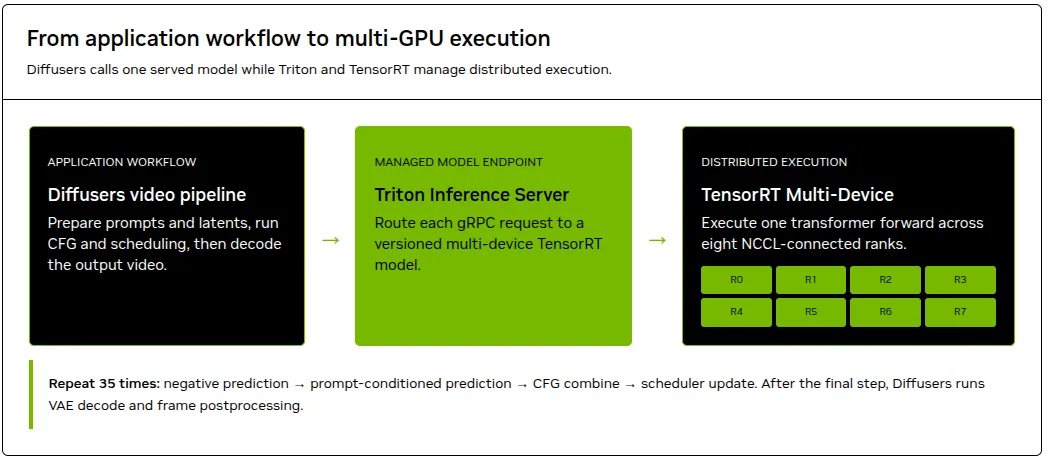
يتيح الاستدلال متعدد الأجهزة في TensorRT لشبكة واحدة أن تعمل على عدة وحدات GPU عبر مجمّعات موزّعة مدعومة بـ NCCL مع الحفاظ على تحسينات الاستدلال. ويفعّل Dynamo-Triton، المعروف سابقًا بـ Triton Inference Server، هذه القدرة في الإصدار 26.07، ويمكن لنسخة واحدة من KIND_MODEL أن تمتلك عدة وحدات GPU: فهي تنشئ سياقات التنفيذ وتدفقات CUDA ووحدات اتصال NCCL لكل صف، ثم تطلق الصفوف معًا في كل طلب عبر استدعاء gRPC واحد.
كيف يعمل مسار التقديم
عُرض التكامل باستخدام توليد الفيديو بنموذج Cosmos 3 Nano: يواصل Diffusers إدارة المحيط، بينما يقدّم Dynamo-Triton محوّل إزالة التشويش ذا الطبقات الـ36. ويوزّع الاستدلال متعدد الأجهزة في TensorRT، عبر التوازي السياقي Ulysses، 44,160 رمزًا فيديويًا على ما يصل إلى ثماني وحدات GPU.
يُترجم الرسم البياني الموزّع إلى كل خطة TensorRT قبل النشر، لذا يفعّل Triton خطة توازٍ سياقي بدلًا من تحويل محرك أحادي الجهاز. ويستحوذ المحوّل على 93.4% من زمن التوليد على وحدة واحدة، ولأن كل خطوة من خطوات إزالة التشويش الـ35 تحتاج إلى تنبؤين من أجل classifier-free guidance، ينفّذ الوسيط 70 استدعاء RPC للمحوّل في كل عملية توليد.
نتائج زمن الاستجابة
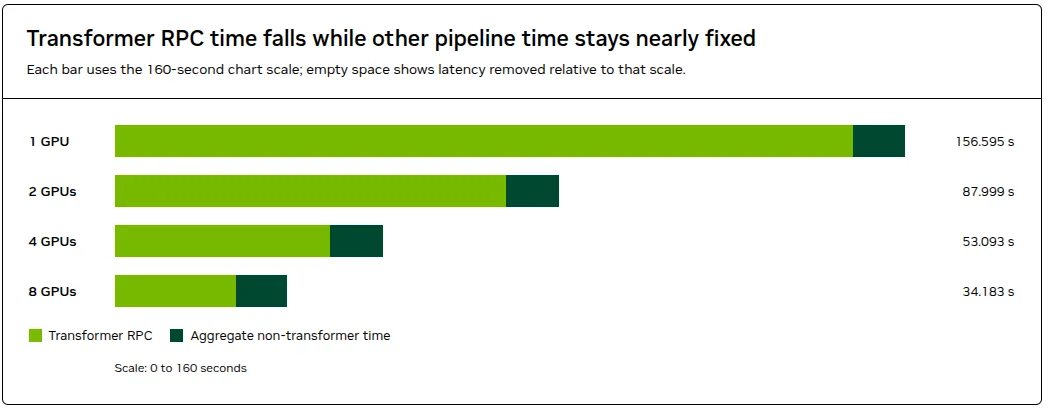
عملت النسخ الأربع على النظام نفسه المزوّد بثماني وحدات GPU: دقة 1280x720 و189 إطارًا بمعدل 24 إطارًا في الثانية وخمس عمليات توليد مقيسة. وانخفض زمن الاستجابة من الطرف إلى الطرف من 156.595 ثانية على وحدة واحدة إلى 87.999 على وحدتين و53.093 على أربع و34.183 ثانية على ثماني وحدات، أي بنسبة 78.17%. كما انخفض زمن RPC للمحوّل بنسبة 83.59%، وتراجعت حصته من الإجمالي من 93.4% إلى 70.2%، وظل الزمن خارج هذا المسار بين 10.2 و10.5 ثانية في جميع التهيئات.
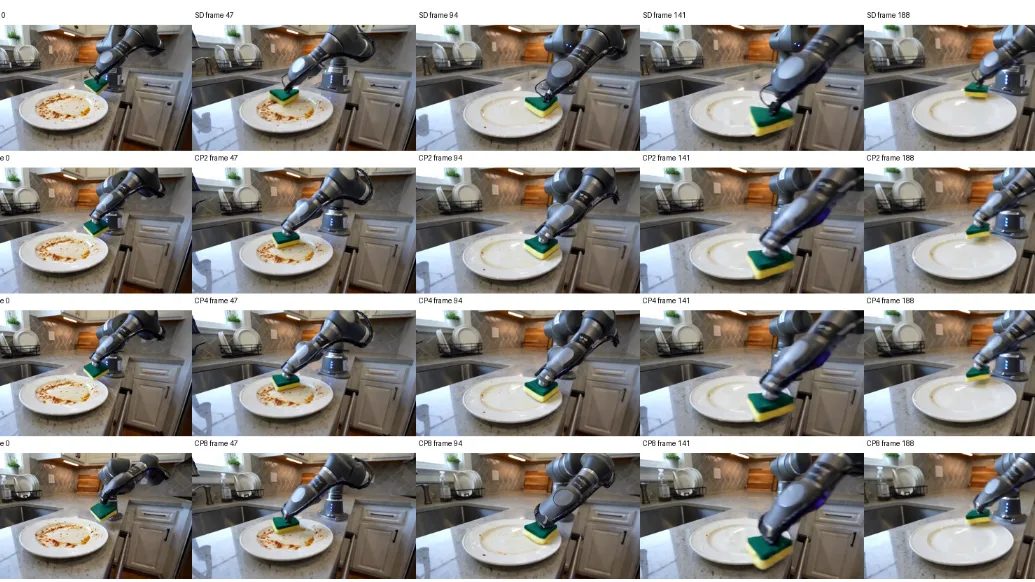
قارن التحقق كل ناتج سياقي متوازٍ بالنتيجة أحادية الجهاز عند البذرة نفسها: سجّلت CP2 وCP4 متوسط خطأ مطلقًا قدره 12.759 ونسبة PSNR بلغت 21.111 dB، وسجّلت CP8 قيمة MAE تساوي 16.316 وPSNR تساوي 19.400 dB، وكلها داخل الحدود المحددة. ولا تؤكد NVIDIA أن النتائج متطابقة على مستوى البكسل.
المقايضات
ما زال على الفرق الموازنة بين موارد GPU الإضافية وزمن استجابة أقصر. لا يقيس هذا الاختبار معدل الطلبات المتزامنة ولا تكلفة الفيديو الواحد ولا التكلفة الإجمالية للملكية، وهي مؤشرات ينبغي تقييمها مقابل أهداف مستوى الخدمة. ويمكن تنزيل Dynamo-Triton 26.07 من NGC.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.