Cerebras, Trilyon Parametrli AI Modellerini Wafer-Ölçekli Çiplərdə Necə Deploy Etdiyini İzah Edir
Cerebras böyük frontier modelləri WSE-3T waferləri arasında necə böldüyünü, Kimi K3 nümunəsi ilə on-chip yaddaş, pipeline və eyni vaxtlı sorğu idarəetməsini izah edir.
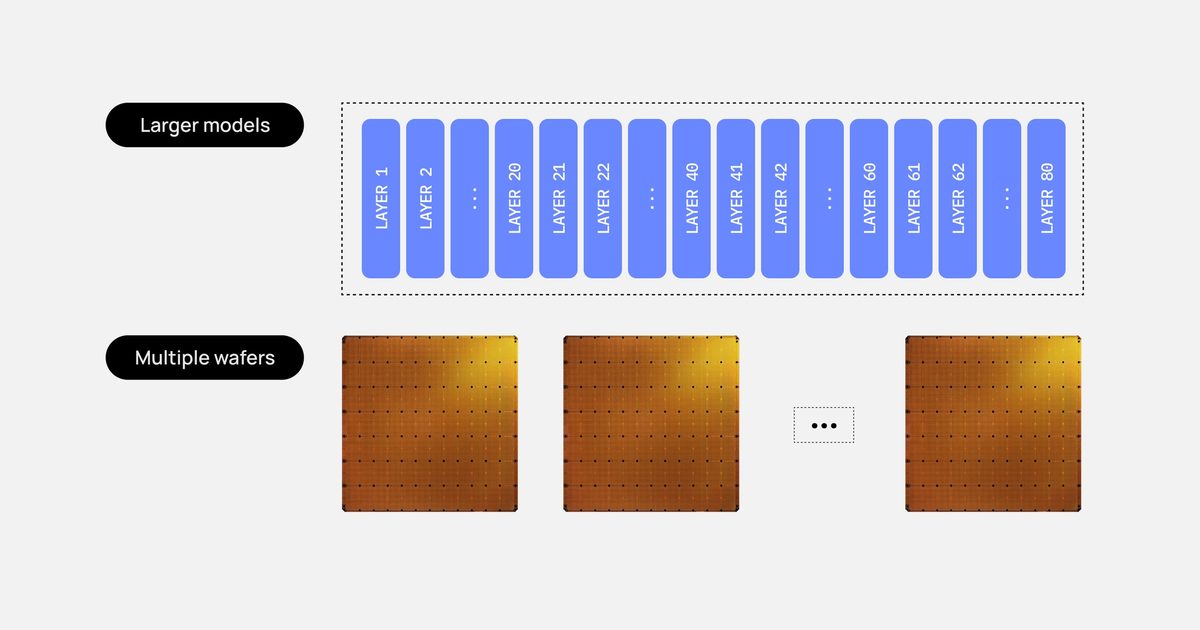
Cerebras, trilyon parametrli frontier modellərini öz wafer-ölçekli çiplərində necə deploy etdiyini izah edən bir məqalə yayımlayıb. Bir Cerebras WSE-3T waferdə 44 GB on-chip yaddaş var, halbuki trilyon parametrli modellər yalnız çəkiləri üçün terabayt tələb edir. Şirkət böyük modeli bir neçə WSE-3T waferi arasında bölərək multi-trilyon parametrli modelləri saniyədə 1000-2000+ token sürəti ilə işlədir.
Kimi K3 nümunəsi kimi
Cerebras, açıq mənbəli Kimi K3 modelini nümayiş nümunəsi kimi istifadə edir. Kimi K3-də təxminən 3 trilyon parametr, 69 linear-attention layer və 24 dense layer var. Cerebras, Kimi K3-ün Terminal-Bench 2.1-də 88.3%, GPT-5.6 Sol-un 88.8%, BrowseComp-da 91.2%, GPT-5.6 Sol-un isə 90.4% nəticə aldığını deyir. Cerebras, bu nəticələrin frontier səviyyəli kodlama və agentik qabiliyyəti göstərdiyini, modelin bəzi benchmarklarda önde olan proprietary modelləri aşdığını bildirir.
Nümunə üçün Cerebras, 256k orta sorğu ölçüsü, 4-bit weight quantization və 8-bit KV cache varsayıb. Hər model layerinin ölçüsünü hesablayır, sonra modeli 93 layerə bölür. Nəticə layer başına təxminən 16 GB edir.
Layerlərin waferlərə map edilməsi
Hər WSE-3T waferin 44 GB tutumu bir waferdə neçə layerin yerləşəcəyini müəyyən edir və cavab layer tipindən asılıdır. Dense layerlər KV cache üçün əlavə yer tələb edir, çünki hər dense full-attention layer hər aktiv sorğuda hər token üçün açar və dəyərlər saxlayır. Beləliklə Cerebras, hər waferə bir dense layer yerləşdirir və qalan SRAM-ı onun KV cache-i üçün saxlayır.
Linear-attention layerlər KV cache üçün əlavə yer tələb etmir. Hər token üçün açar və dəyər saxlamaz, əksinə linear-attention layer hər sorğu üçün kontekst uzunluğundan asılı olmayaraq kiçik, sabit ölçülü state saxlayır. Bu da hər waferdə iki linear layer üçün yer qoyur, 2 x 16 GB = 32 GB. 69 linear layer və 24 dense layer ilə mapping linear layerlər üçün 35 wafer, dense layerlər üçün 24 wafer, cəmi 59 wafer verir.
Pipeline icrası və eyni vaxtlılıq
Cerebras modelləri pipeline-da icra edir. Compiler model layerlərini wafer bölgələri arasında map edir, runtime isə tokenlərin waferlər arasında axın yolunu map edir. Waferlər arasında yalnız aktivasiyalar keçməlidir, bu RDMA over Ethernet vasitəsilə təxminən 2 mikrosaniyə bir hop-da olur. Hər waferdə 44 GB on-chip SRAM və hər layer təxminən 16 GB olarsa, bütün layerlər adətən çip üzərində birbaşa yerləşir. Əksər hallarda model çəkilərinin hərəkət etməsinə ehtiyac yoxdur, layerlər waferlər arasında bölünməyə ehtiyac yoxdur.
Hər wafer yığım xəttinin bir mərhələsi kimi işləyir. Məsələn, Wafer 1 1-2-ci layerləri işlədib aktivasiyaları Wafer 2-yə göndərir, o da layer 3-4-ü işlədib nəticələri növbəti waferə ötürür və bu zəncir son wafer növbəti tokeni çıxarana qədər davam edir. Çoxlu sorğuları xidmət etmək üçün Cerebras pipeline-ı fərqli sorğularla dolu saxlayır. Hər stage eyni vaxtda fərqli bir sorğu üzərində işləyə bilər, və hər stage tək sorğu əvəzinə micro-batch emal edə bilər. Kiçik micro-batchlər hər sorğunu daha da sürətləndirir, böyük micro-batchlər ümumi throughput-u artırır.
KV cache-ə ayrılan on-chip yaddaş miqdarı eyni vaxtlı sorğuların maksimum sayını müəyyən edir. Davam edən hər sorğu hər dense-layer waferında öz KV cache-inə malik olmalıdır. Cerebras, concurrency və batch size təkbaşına inference səmərəliliyini göstərmir; daha mənalı metrik eyni output generation speed-də ölçülən vahid güc başına düşən cəmi token throughput-dur.
Mənbələr: cerebras.ai
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.